
solr亿万级索引优化实践(四)
本篇是这个系类的最后一篇,但优化方案不仅于此,需要后续的研究与学习,本篇主要从schema设计的角度来做一些实践。
schema.xml 这个文件的作用是定义索引数据中的域的,包括域名称,域类型,域是否索引,是否分词,是否存储,是否标准化,是否存储项向量等等。在solr6中这个文件是存放在zookeeper的/configs节点之下的,在创建新的collection时,solr会根据此节点下的信息生成相应的索引库,其相关的配置信息会同步到solrhome/core目录下的core.properties文件中。同步schema文件的指令语句样例为:
bin/solr zk -upconfig -z 127.0.01:2181 -n conf -d /solrhome/configsets/sample_techproducts_configs/conf为了改进性能,可以从以下几个方面来着手:
1、对于field元素,我们将所有只用于搜索的,而不需要作为查询结果的field(特别是一些比较大的field)的stored设置为false,这样这个字段的值将不会被存储,但可以被检索,会减少不小的IO开销。我们设计了一个利用solr来做hbase的二级索引架构,可以利用hbase来存储字段信息,充分利用hadoop的大数据特性。
2、能不用copyfield这个元素就不用,这个属性会对字段做双倍存储,显然非常耗性能,好处就是在查询的时候,想要对多个字段进行检索只需要检索一个字段。
3、将一些不需要被检索的字段的index属性,设置成false,这样solr就不会对这个字段进行索引。
5、不使用中文分词器或者使用高亮功能。termPositions termOffsets的值全都设置成false。
6、在测试中发现solr在处理小报文(1K以下)的情况下吞吐量并不理想,当适当增大报文,发现速度可以得到大幅度提高,可以从之前的每个节点10M/S暴涨到30M/S。
但是在很多情况下,我们并不能人为控制报文长度,这个时候,可以通过solr的字段多值来达到目的,即将将多条消息的每个字段的值放到一起,在schema中配置multValued为true。存储到solr中是这个样子的:
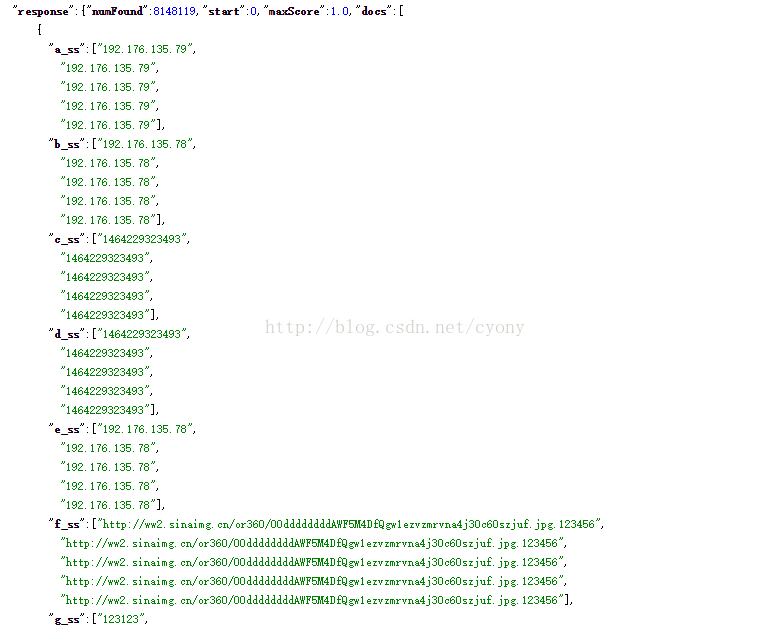
这样速度是可以单台节点达到30M/S甚至更高,但是带来的问题就是查询会变得很复杂,在命中多值中任意一条记录,结果集会带出所有值,在solr中认为这一组数据是一个文档,我们想了很多方案来解决这个问题,比较简单的方法是,在生成文档的时候控制多值字段中,没有重复的值,这样检索结果则会变得精确,缺点就是灵活性太低。另一个方案,是通过对数据做预聚合,管理快照,由于其实现比较复杂,效果也不是很理想,在此就不做过多描述了。
在不追求检索精确度,或者对数据可控的情况下,对于索引速度真的可以带来很大的惊喜。
尾言:solr由于是利用lucene为底层,lucene本身是单机的无法分布式,solr的核心就是引入了分片的机制,在数据规模变得特别庞大的时候各种弊端就显示出来了,无论是建立索引还是查询性能都不尽人意。但通过各种方法的优化与舍弃之后,差不多可以做到水平拓展,线性增长,能够满足大多数的业务场景。但是如果是要对历史数据进行检索的时候,这个历史数据规模又是极其巨量时,solr恐怕是无法承受的。现在兴起了很多列式存储结构以及时间序列的数据库以及仓库,比如driud和tsdb,他们在巨量数据检索时可以带来极高的性能体验。
solr亿万级索引优化实践(四)的更多相关文章
- solr亿万级索引优化实践-自动生成UUID
solr亿万级索引优化实践(三) 原创 2017年03月14日 17:03:09 本篇文章主要介绍下如何从客户端solrJ以及服务端参数配置的角度来提升索引速度. solrJ6.0提供的 ...
- 一个Web报表项目的性能分析和优化实践(四):MySQL建立索引,唯一索引和组合索引
先大致介绍下项目的数据库信息. 数据库A:主要存放的通用的表,如User.Project.Report等. 数据库B.C.D:一个项目对应一个数据库,而且这几个项目的表是完全一样的. 数据库表的特点 ...
- Explain执行计划与索引优化实践
一.何为explain执行计划? 使用explain关键字可以模拟优化器执行SQL语句,从而知道MySQL是如何使用索引来处理你的SQL查询语句以及连接表,可以分析查询语句或是结构的性能瓶颈,帮助我们 ...
- 让Elasticsearch飞起来!——性能优化实践干货
原文:让Elasticsearch飞起来!--性能优化实践干货 版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明. 本文链接:https://blog ...
- 携程App的网络性能优化实践
首先介绍一下携程App的网络服务架构.由于携程业务众多,开发资源导致无法全部使用Native来实现业务逻辑,因此有相当一部分频道基于Hybrid实现.网络通讯属于基础&业务框架层中基础设施的一 ...
- mysql优化之索引优化
Posted by Money Talks on 2012/02/23 | 第一篇 序章第二篇 连接优化第三篇 索引优化第四篇 查询优化第五篇 到实战中去 索引优化 索引优化涉及到几个方面,包括了索引 ...
- 转:携程App的网络性能优化实践
http://kb.cnblogs.com/page/519824/ 携程App的网络性能优化实践 受益匪浅的一篇文章,让我知道网络交互并不是简单的传输和接受数据.真正的难点在于后面的性能优化 下面对 ...
- MySQL高级学习笔记(四):索引优化分析
文章目录 性能下降 SQL慢 执行时间长 等待时间长 查询语句写的烂 查询数据过多 关联了太多的表,太多join 没有利用到索引 单值 复合 服务器调优及各个参数设置(缓冲.线程数等)(不重要DBA的 ...
- Hbase-二级索引 Hbase+Hbase-indexer+solr (CDH)
最近一段时间工作涉及到hbase sql查询和可视化展示的工作,hbase作为列存储,数据单一为二进制数组,本身就不擅长sql查询:而且有hive来作为补充作为sql查询和存储,但是皮皮虾需要低延迟的 ...
随机推荐
- 公告:《那些年,追寻Jmeter的足迹》上线
在我们团队的努力下,我们<那些年,追寻Jmeter的足迹>手册第1版本工作完成(后面还会有第2版本),比较偏基础,这是汇集我们团队的经验和团队需要用到的知识点来整理的,在第2个版本,我们整 ...
- 构建你自己的论坛,基于windows服务器的xampp+discuz论坛
首先声明,论坛的构建需要基于企业,并且基于企业注册,然后进行域名备案. 此处作为研究,先示例: 1. 安装 xampp 软件,百度搜索 然后在服务器安装,基本都是默认安装,然后出来. 安装完成后,接下 ...
- 转载:二次指数平滑法求预测值的Java代码
原文地址: http://blog.csdn.net/qustmeng/article/details/52186378?locationNum=4&fps=1 import java.uti ...
- Unity插件-ShareSDK使用指南
Unity插件ShareSDK使用教程 本文提供全流程,中文翻译.Chinar坚持将简单的生活方式,带给世人!(拥有更好的阅读体验 -- 高分辨率用户请根据需求调整网页缩放比例) 1 Summariz ...
- 牛客小白月赛2 E:是是非非(尼姆博弈)
链接:https://www.nowcoder.com/acm/contest/86/E来源:牛客网 题目描述 坎为水,险阳失道,渊深不测:离为火,依附团结,光明绚丽.坎卦:水洊至,习坎:君子以常德行 ...
- 《DSP using MATLAB》Problem 3.5
定义为: 如果序列绝对可和,其DTFT就存在.
- 构建一个dbt 数据库适配器
脚手架新的适配器 首先,将odbc适配器模板复制到同一目录中的新文件. 更新dbt / adapters / factory.py以将新适配器包含为类型.还要将类型添加到dbt / contracts ...
- Drupal 7 建站学习手记(五):QuickTabs模块内的元素无法溢出的问题
背景 项目要求站点首页放Views生成的区块,而且要求有很多其它链接. Views生成的区块默认的很多其它链接仅仅能选在列表上方和下方 下图是默认在上方的样式图: 为了美观.我将很多其它链接上移了若干 ...
- curl 知识点
curl :command line tool and library for transferring data with URLs curl 命令,常用缩写: curl 命令 缩写 说明 curl ...
- webpack 打包性能分析工具
webpack-bundle-analyzer,推荐使用 新版 vue-cli (旧版按照新版的进行配置即可)已经集成该插件,在项目的 package.json 文件中注入如下命令,然后运行(npm ...