
python-day21--序列化模块模块
import json

dic = {'k1':'v1','k2':'v2','k3':'v3'}

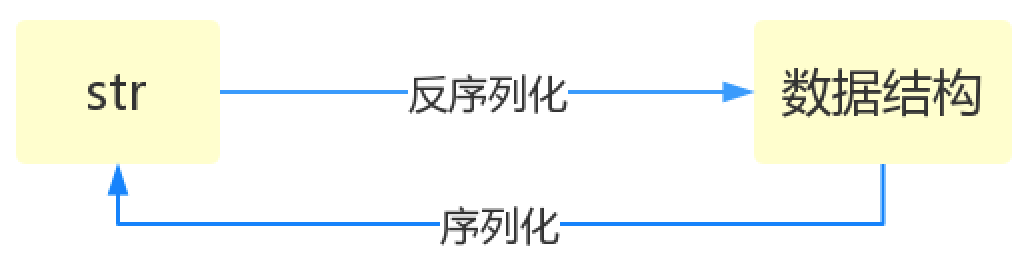
str_dic = json.dumps(dic)  #序列化:将一个字典转换成一个字符串

print(type(str_dic),str_dic)  #<class 'str'> {"k3": "v3", "k1": "v1", "k2": "v2"}

#注意,json转换完的字符串类型的字典中的字符串是由""表示的

dic2 = json.loads(str_dic)  #反序列化:将一个字符串格式的字典转换成一个字典

#注意,要用json的loads功能处理的字符串类型的字典中的字符串必须由""表示

print(type(dic2),dic2)  #<class 'dict'> {'k1': 'v1', 'k2': 'v2', 'k3': 'v3'}

list_dic = [1,['a','b','c'],3,{'k1':'v1','k2':'v2'}]

str_dic = json.dumps(list_dic) #也可以处理嵌套的数据类型

print(type(str_dic),str_dic) #<class 'str'> [1, ["a", "b", "c"], 3, {"k1": "v1", "k2": "v2"}]

list_dic2 = json.loads(str_dic)

print(type(list_dic2),list_dic2) #<class 'list'> [1, ['a', 'b', 'c'], 3, {'k1': 'v1', 'k2': 'v2'}]

loads和dumps
import json

f = open('json_file','w')

dic = {'k1':'v1','k2':'v2','k3':'v3'}

json.dump(dic,f)  #dump方法接收一个文件句柄,直接将字典转换成json字符串写入文件

f.close()

f = open('json_file')

dic2 = json.load(f)  #load方法接收一个文件句柄,直接将文件中的json字符串转换成数据结构返回

f.close()

print(type(dic2),dic2)

load和dump
dump,load
二、pickle模块
提供了四个功能:dumps、dump(序列化,存)、loads(反序列化,读)、load (不仅可以序列化字典,列表...可以把python中任意的数据类型序列化)
import pickle

dic = {'k1':'v1','k2':'v2','k3':'v3'}

str_dic = pickle.dumps(dic)

print(str_dic)  #一串二进制内容

dic2 = pickle.loads(str_dic)

print(dic2)    #字典

import time

struct_time  = time.localtime(1000000000)

print(struct_time)

f = open('pickle_file','wb')

pickle.dump(struct_time,f)

f.close()

f = open('pickle_file','rb')

struct_time2 = pickle.load(f)

print(struct_time.tm_year)
如果我们将一个字典或者序列化成了一个json存在文件里,那么java代码或者js代码也可以拿来用。
但是如果我们用pickle进行序列化,其他语言就不能读懂这是什么了~
所以,如果你序列化的内容是列表或者字典,我们非常推荐你使用json模块
但如果出于某种原因你不得不序列化其他的数据类型,而未来你还会用python对这个数据进行反序列化的话,那么就可以使用pickle
三、shelve模块
shelve只提供给我们一个open方法,是用key来访问的,使用起来和字典类似。
import shelve

f = shelve.open('shelve_file')

f['key'] = {'int':10, 'float':9.5, 'string':'Sample data'}  #直接对文件句柄操作,就可以存入数据

f.close()

import shelve

f1 = shelve.open('shelve_file')

existing = f1['key']  #取出数据的时候也只需要直接用key获取即可,但是如果key不存在会报错

f1.close()

print(existing)
这个模块有个限制,它不支持多个应用同一时间往同一个DB进行写操作。所以当我们知道我们的应用如果只进行读操作,我们可以让shelve通过只读方式打开DB
import shelve

f = shelve.open('shelve_file', flag='r')

existing = f['key']

f.close()

print(existing)
由于shelve在默认情况下是不会记录待持久化对象的任何修改的,所以我们在shelve.open()时候需要修改默认参数,否则对象的修改不会保存。
import shelve

f1 = shelve.open('shelve_file')

print(f1['key'])

f1['key']['new_value'] = 'this was not here before'

f1.close()

f2 = shelve.open('shelve_file', writeback=True)

print(f2['key'])

f2['key']['new_value'] = 'this was not here before'

f2.close()

设置writeback
writeback方式有优点也有缺点。优点是减少了我们出错的概率,并且让对象的持久化对用户更加的透明了;但这种方式并不是所有的情况下都需要,首先,使用writeback以后,shelf在open()的时候会增加额外的内存消耗,并且当DB在close()的时候会将缓存中的每一个对象都写入到DB,这也会带来额外的等待时间。因为shelve没有办法知道缓存中哪些对象修改了,哪些对象没有修改,因此所有的对象都会被写入。
python-day21--序列化模块模块的更多相关文章
- python中序列化json模块和pickle模块
内置模块和第三方模块 json模块和pickle 模块(序列化模块) 什么是序列化? 序列化就是将内粗这种的数据类型转成另一种格式 序列化:字典类型——>序列化——>其他格式——>存 ...
- python之序列化json模块与pickle模块(待补充)
一.json是所有语言都通用的一种序列化格式 只支持 : 列表,字典字符串,数字,且字典的key必须是字符串 ''' 1. dumps , loads 在内存中做数据转换: dumps : 数据类型 ...
- python常用模块(模块和包的解释,time模块,sys模块,random模块,os模块,json和pickle序列化模块)
1.1模块 什么是模块: 在计算机程序的开发过程中,随着程序代码越写越多,在一个文件里代码就会越来越长,越来越不容易维护. 为了编写可维护的代码,我们把很多函数分组,分别放到不同的文件里,这样,每个文 ...
- Python第十四天 序列化 pickle模块 cPickle模块 JSON模块 API的两种格式
Python第十四天 序列化 pickle模块 cPickle模块 JSON模块 API的两种格式 目录 Pycharm使用技巧(转载) Python第一天 安装 shell 文件 Py ...
- python之序列化模块、双下方法(dict call new del len eq hash)和单例模式
摘要:__new__ __del__ __call__ __len__ __eq__ __hash__ import json 序列化模块 import pickle 序列化模块 补充: 现在我们都应 ...
- Python基础(12)_python模块之sys模块、logging模块、序列化json模块、pickle模块、shelve模块
5.sys模块 sys.argv 命令行参数List,第一个元素是程序本身路径 sys.exit(n) 退出程序,正常退出时exit(0) sys.version 获取Python解释程序的版本信息 ...
- (转)python常用模块(模块和包的解释,time模块,sys模块,random模块,os模块,json和pickle序列化模块)
阅读目录 1.1.1导入模块 1.1.2__name__ 1.1模块 什么是模块: 在计算机程序的开发过程中,随着程序代码越写越多,在一个文件里代码就会越来越长,越来越不容易维护. 为了编写可维护的代 ...
- Python模块02/序列化/os模块/sys模块/haslib加密/collections
Python模块02/序列化/os模块/sys模块/haslib加密/collections 内容大纲 1.序列化 2.os模块 3.sys模块 4.haslib加密 5.collections 1. ...
- python的序列化模块
最近机器学习的模型需要序列化和反序列化,因为写个博客总结一下几个模型和数据等序列化的模块.
- random os 序列化 模块模块 随机选择
# 1 random 模块 随机选择# import random#随机取小数# ret = random.random() #空是0到1之间的小数字# print(ret)# # 0.0799728 ...
随机推荐
- Linux基础命令---dump
dump 检查ext2/3/4文件系统,确定哪些文件需要备份,这些需要备份的文件将会被复制到指定的磁盘或者其他存储介质.dump检查Ext 2/3/4文件系统上的文件,并确定哪些文件需要备份.这些文件 ...
- 解读 Q_D, Q_Q 指针
见 qglog.h文件定义: #define Q_D(Class) Class##Private * const d = d_func() #define Q_Q(Class) Class * ...
- Oracle查询session连接数和inactive以及 概要文件IDLE_TIME限制用户最大空闲连接时间
-----############oracle会话和进程################----------------查询会话总数select count(*) from v$session;--查 ...
- 4 个技巧学习 Golang
到达 Golang 大陆:一位资深开发者之旅. 2014 年夏天…… IBM:“我们需要你弄清楚这个 Docker.” 我:“没问题.” IBM:“那就开始吧.” 我:“好的.”(内心声音):”Doc ...
- 【读书笔记】SpringBoot读书笔记
整体目录结构: 一.入门 二.开发第一个应用程序 三.自定义配置 四.测试 五.Groovy与Spring Boot Cli 六.在Spring Boot中使用Grails 七.深入Actuator ...
- 20145104张家明 《Java程序设计》第7周学习总结
20145104张家明 <Java程序设计>第7周学习总结 教材学习内容总结 第13章 简单认识时间和日期 -时间的度量:GMT.UT.TAI.UTC.Unix.epoch. -UTC:保 ...
- 20145306 张文锦 网络攻防 web基础
20145306 网络攻防 web基础 实验内容 WebServer:掌握Apache启停配置修改(如监听端口)前端编程:熟悉HTML+JavaScript.了解表单的概念编写不同的HTML网页,放入 ...
- 九数组分数|2015年蓝桥杯B组题解析第五题-fishers
九数组分数 1,2,3...9 这九个数字组成一个分数,其值恰好为1/3,如何组法? 下面的程序实现了该功能,请填写划线部分缺失的代码. #include <stdio.h> void t ...
- Java Session 会话技术
什么是Java Session? 大图:http://images2017.cnblogs.com/blog/1030087/201712/1030087-20171223235950881-1310 ...
- FAST:通过Floodlight控制器下发流表
参考: Floodlight+Mininet搭建OpenFlow(四):流表操作 通过Floodlight控制器下发流表 下发流表的方式有两种: 1.借助Floodlight的北向API,利用curl ...