
Python3 爬虫之 Scrapy 核心功能实现(二)
基于 Python 3.6.2 的 Scrapy 爬虫框架使用,Scrapy 的搭建过程请参照本人的另一篇博客:Python3 爬虫之 Scrapy 框架安装配置(一)
1. 爬虫项目创建
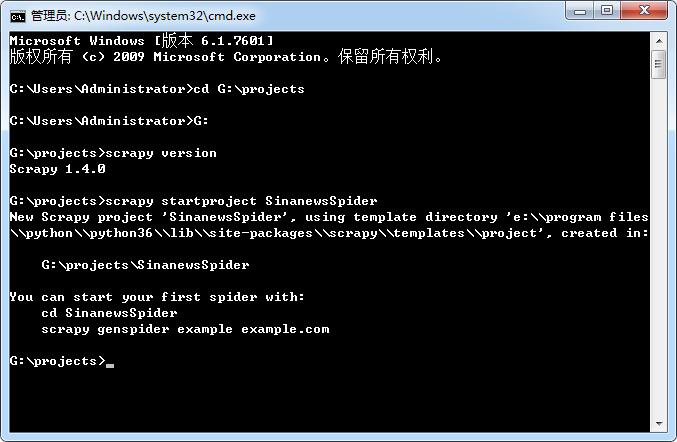
在抓取之前,需要新建一个 Scrapy 工程。进入一个你想用来保存代码的目录,比如 G:\projects 然后执行:
scrapy startproject SinanewsSpider
这个命令会在当前目录下创建一个新目录 SinanewsSpider,这就是此爬虫的项目名称,后面会使用到。
成功创建爬虫项目文件结构后,使用:tree /f 查看文件层级的结构关系

这些文件主要是:
scrapy.cfg: 项目配置文件
SinanewsSpider/: 项目python模块, 代码将从这里导入
SinanewsSpider/items.py: 项目items文件
SinanewsSpider/pipelines.py: 项目管道文件
SinanewsSpider/settings.py: 项目配置文件
SinanewsSpider/spiders: 放置spider的目录
2. 定义item
编辑 items.py 文件,items 是将要装载抓取的数据的容器,它工作方式像 python 里面的字典,但它提供更多的保护,比如对未定义的字段填充以防止拼写错误。在 items.py 文件里,scrapy 需要我们定义一个容器用于放置爬虫抓取的数据,它通过创建一个scrapy.Item 类来声明,定义它的属性为scrpy.Field 对象,就像是一个对象关系映射(ORM, Object Relational Mapping)。我们通过将需要的 item 模型化,来控制从站点获得的新闻数据,比如我们要获得新闻的标题项、内容项、发表时间、图片链接地址和页面链接地址,则定义这5种属性的域。Scrapy 框架已经定义好了基础的 item,我们自己的 item 只需继承 scrapy.Item 即可。
# -*- coding: utf-8 -*-

# Define here the models for your scraped items

#

# See documentation in:

# http://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class SinanewsspiderItem(scrapy.Item):  #定义数据项类,从scrapy.Item继承

    # define the fields for your item here like:# name = scrapy.Field()

    title = scrapy.Field()        #定义标题项

    content = scrapy.Field()     #定义内容项

    pubtime = scrapy.Field()    #定义发表时间

    imageUrl = scrapy.Field()    #定义图片链接地址

    Url = scrapy.Field()         #定义页面链接地址
3. 编写爬虫 Spider
新建 SinanewsSpider.py 文件, Scrapy 框架已经帮助我们定义好了基础爬虫,只需要从 scrapy.spider 继承,并重写相应的解析函数 parse 即可。其中会涉及到使用 xPath 获取页面元素路径的操作,xPaht 是 XML 页面路径语言,使用路径表达式来选取 XML 文档中的节点或节点集,节点是通过沿着路径(Path)或者步(Steps)来选取的,html 是 XML 的子集,当然同样适用,有兴趣的读者可以自行查阅相关的 Xpath 文档。
# -*- coding: utf-8 -*-

from scrapy.spiders import Spider

from scrapy.selector import Selector

from scrapy import signals

from scrapy.crawler import CrawlerRunner

from scrapy.utils.project import get_project_settings

from scrapy.utils.log import configure_logging

from scrapy.xlib.pydispatch import dispatcher

from twisted.internet import reactor

from time import ctime,sleep

from scrapy.spiders import Spider

from scrapy.selector import Selector

from scrapy import signals

from scrapy.crawler import CrawlerRunner

from scrapy.utils.project import get_project_settings

from scrapy.xlib.pydispatch import dispatcher

from twisted.internet import reactor

from SinanewsSpider.items import SinanewsspiderItem

from scrapy.http import Request

import logging

import MySQLdb

import scrapy

from scrapy.utils.response import get_base_url

from scrapy.utils.url import urljoin_rfc

#以上是一些依赖包的导入

class SinanewsSpider(scrapy.Spider):

    name = "SinanewsSpider"

    start_urls = []

    def __init__(self):

        self.start_urls = ["http://roll.news.sina.com.cn/news/gnxw/gdxw1/index.shtml"]

    def parse(self, response):

        for url in response.xpath('//ul/li/a/@href').extract():

            yield scrapy.Request(url, callback=self.parse_detail)

        nextLink = []

        nextLink = response.xpath('//div[@class="pagebox"]/span[last()-1]/a/@href').extract()

        if nextLink:

            nextLink = nextLink[0]

            nextpage= nextLink.split('./')[1]

            yield Request("http://roll.news.sina.com.cn/news/gnxw/gdxw1/" + nextpage,callback=self.parse)

    def parse_detail(self, response):

        item = SinanewsspiderItem()

        item['title'] = response.xpath('//h1[@class="main-title"]/text()').extract()[0]

        content = ''

        for con in response.xpath('//div[@id="article"]/p/text()').extract():

            content = content + con

        item['content'] = content

        item['pubtime'] = response.xpath('//span[@class="date"]/text()').extract()[0]

        imageurl = ''

        for img in response.xpath('//div[@id="article"]/div[@class="img_wrapper"]/img/@src').extract():

            imageurl = imageurl + img+'|'

        item['imageUrl'] = imageurl

        item['Url'] = response.url

        yield item
4. 数据存储
编辑 pipelines.py 文件,用于将 items 中的数据存储到数据库中。
首先,创建 sinanews 数据库,并创建 SinaLocalNews 数据表,用于存储爬到的新闻数据:
mysql> create database sinanews;

mysql> use sinanews;

mysql> CREATE TABLE SinaLocalNews (

    ->   id int(11) NOT NULL AUTO_INCREMENT,

    ->   title VARCHAR(100),

    ->   content  TEXT,

    ->   imageUrl       VARCHAR(2000),

    ->   Url    VARCHAR(1000),

    ->   pubtime  DATETIME,

    ->   PRIMARY KEY (id)

    -> ) ENGINE=InnoDB DEFAULT CHARSET=utf8;

Query OK, 0 rows affected (0.96 sec)
创建数据库:sinanews

创建数据表:SinaLocalNews

然后,在 process_item 方法中定义数据库操作的代码,process_item 方法在 pipeline 类中会默认执行:
# -*- coding: utf-8 -*-

# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: http://doc.scrapy.org/en/latest/topics/item-pipeline.html

import MySQLdb

class SinanewsspiderPipeline(object):

    con = MySQLdb.connect(host='localhost', port=3306, user='root', passwd='', db='sinanews', charset='utf8')

    cur = con.cursor()

    def process_item(self, item, spider):

        sql = "INSERT INTO SinaLocalNews(title, content, imageUrl, Url, pubtime) VALUES ('%s', '%s', '%s', '%s', trim(replace(replace(replace(left('%s',16),'年','-'),'月','-'),'日',' ')))" % (item['title'], item['content'], item['imageUrl'], item['Url'], item['pubtime'])

        self.cur.execute(sql)

        self.con.commit()
其中,host 为数据库服务器的地址,port 为数据库服务器监听的端口号,usr 指定数据库的用户名,passwd 则为数据库密码,db 为所要连接的具体数据库实例的名称,charset 指定你目标数据库的编码字符集。
5. 激活 pipeline 管道
编辑 settings.py 文件,添加如下代码:
BOT_NAME = 'SinanewsSpider'

SPIDER_MODULES = ['SinanewsSpider.spiders']

NEWSPIDER_MODULE = 'SinanewsSpider.spiders'

ROBOTSTXT_OBEY = True

ITEM_PIPELINES = {

    'SinanewsSpider.pipelines.SinanewsspiderPipeline': 300,

}
注意:上面大括号中的参数,一定要替换成 pipeline 中自己定义的 pipeline 类名,才能够进行激活并使用。
6. 运行爬虫
进入到爬虫项目根目录,运行爬虫,命令如下:scrapy crawl SinanewsSpider

爬虫运行过程中,会在控制台打印很多状态信息,是一个刷屏的过程,如果有错误的话,也会在控制台中显示出对应的错误信息,便于调试。

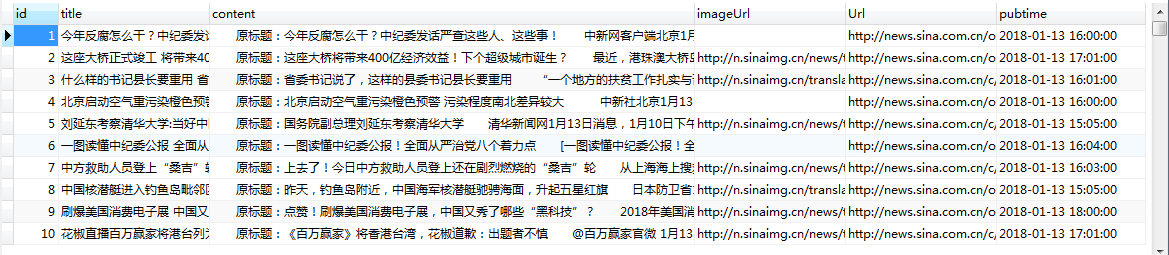
由于新闻数据太多,爬了1880条新闻(从上面的控制台中可以看到'item_scraped_count':1880)后,按 Ctrl + C 提前终止了运行, 在数据库中可以查看到所爬取的数据:

注意事项:
以下是本人在使用 Scrapy 爬虫过程中遇到的几个 Error,供大家参考:
1. 在 C/C++/Java 等语言中,代码块均放被到大括号中,但是,在 Python 中,使用缩进来表示代码块,如果碰到如下错误:
TabError: Inconsistent use of tabs and spaces in indentation

解决方法:
这个错误是说你用了 tab 键作缩进了,因为在 python 不像 C/C++ 里用大括号来区分程序块,而是用缩进,所以缩进很重要你把Tab都换成空格就好了。
2. 由于 Python2.x 和Python3.x 版本上的不兼容,导致 MySQLdb 暂时不支持 Python3,即出现如下错误时:
python3.*报"ImportError: No module named 'MySQLdb'"
解决方法:
MySQLdb只支持Python2.*,还不支持3.*
可以用PyMySQL代替。安装方法:pip install PyMySQL
然后在需要的项目中,把 __init__.py中添加两行:
import pymysql
pymysql.install_as_MySQLdb()
就可以用 import MySQLdb了。其他的方法与MySQLdb一样。
Python3 爬虫之 Scrapy 核心功能实现(二)的更多相关文章
- Python3 爬虫之 Scrapy 框架安装配置(一)
博客地址:http://www.moonxy.com 基于 Python 3.6.2 的 Scrapy 爬虫框架使用,Scrapy 的爬虫实现过程请参照本人的另一篇博客:Python3 爬虫之 Scr ...
- 小白学 Python 爬虫(34):爬虫框架 Scrapy 入门基础(二)
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 【Python3爬虫】Scrapy入门教程
Python版本:3.5 系统:Windows 一.准备工作 需要先安装几个库(pip,lxml,pywin32,Twisted,pyOpenSSL),这些都比较容易,如果使用的 ...
- 小白学 Python 爬虫(36):爬虫框架 Scrapy 入门基础(四) Downloader Middleware
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(37):爬虫框架 Scrapy 入门基础(五) Spider Middleware
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(35):爬虫框架 Scrapy 入门基础(三) Selector 选择器
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(38):爬虫框架 Scrapy 入门基础(六) Item Pipeline
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(40):爬虫框架 Scrapy 入门基础(七)对接 Selenium 实战
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(41):爬虫框架 Scrapy 入门基础(八)对接 Splash 实战
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
随机推荐
- Javascript实现简单地发布订阅模式
不论是在程序世界里还是现实生活中,发布—订阅模式的应用都非常广泛.我们先看一下现实中的例子. 小明最近看上了一套房子,到了售楼处之后才被告知,该楼盘的房子早已售罄.好在售楼MM告诉小明,不久后还有一些 ...
- Elasticsearch 7.x 最详细安装及配置
Elasticsearch 7.x 最详细安装及配置 一.Elasticsearch 7.x 小马哥说过,学习技术栈得看版本,那么 Elasticsearch 7.x 有什么好的特性呢? ES 7.0 ...
- 源码分析Retrofit请求流程
Retrofit 是 square 公司的另一款广泛流行的网络请求框架.前面的一篇文章<源码分析OKHttp执行过程>已经对 OkHttp 网络请求框架有一个大概的了解.今天同样地对 Re ...
- F#周报2019年第34期
新闻 高效的F#,提示与技巧 Fable 社区资源 Visual Studio提示与技巧:为.NET增加生产力 无风险地尝试Compositional IT的培训包--如果没有增加任何价值,可以得到完 ...
- deepin 15.11 安装 pyenv
GitHub:官方环境:https://github.com/pyenv/pyenv/wiki/Common-build-problems GitHub:官方文档:https://github.com ...
- Spring学习之旅(四)--高级装配Bean
条件化 bean 有时候我们要满足某种情况才将bean 初始化放入容器中. 基于环境初始化不同的 bean 1.申明接口并创建两个实现类 public interface Teacher { void ...
- [Python] Django框架入门2——深入模型
说明: 本文主要深入了解模型(models.py),涉及ORM简介.模型定义.模型成员.模型查询.自连接等.需要一定基础,可以先走一走基本入门流程. 附录一使用mysql数据库,附录二Django开发 ...
- MySQL的count(*)的优化,获取千万级数据表的总行数[转]
一.前言 这个问题是今天朋友提出来的,关于查询一个1200w的数据表的总行数,用count(*)的速度一直提不上去.找了很多优化方案,最后另辟蹊径,选择了用explain来获取总行数. 二.关于cou ...
- ES6之模块化导入导出
1.概述 在js的历史上一直没有模块(module)体系,无法将一个大程序拆分成相互依赖的小文件,再用简单的方法拼装起来,这对开发大型的.复杂的项目形成了巨大障碍. 在 ES6 之前,社区制定了一些模 ...
- 深入理解 Handler 消息机制
记得很多年前的一次面试中,面试官问了这么一个问题,你在项目中一般如何实现线程切换? 他的本意应该是考察 RxJava 的使用,只是我的答案是 Handler,他也就没有再追问下去了.在早期 Andro ...