
Python3 爬虫之 Scrapy 框架安装配置(一)
基于 Python 3.6.2 的 Scrapy 爬虫框架使用,Scrapy 的爬虫实现过程请参照本人的另一篇博客:Python3 爬虫之 Scrapy 核心功能实现(二)
一、初识 Scrapy
Scrapy 是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。其最初是为了页面抓取(更确切来说, 网络抓取)所设计的, 也可以应用在获取API所返回的数据(例如 Amazon Associates Web Services)或者通用的网络爬虫。
二、Scrapy 环境搭建
所需环境:
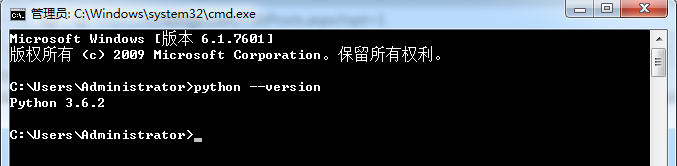
1. 安装 Python 3.6,本文使用 Python 3.6,且在 PATH 中设置好环境变量,当然也可以选择2.7的版本,但有一点需要明确,Python 3.x 和 2.x 互不兼容,安装好之后输入如下命令:python --version,下载地址:https://www.python.org/downloads/
2. 安装 pywin32-221,根据上面安装的 Python 的位数,32 位或 64 位来决定 pywin32的版本,本文使用 pywin32-221.win-amd64-py3.6.exe,下载地址:https://sourceforge.net/projects/pywin32/files/pywin32/
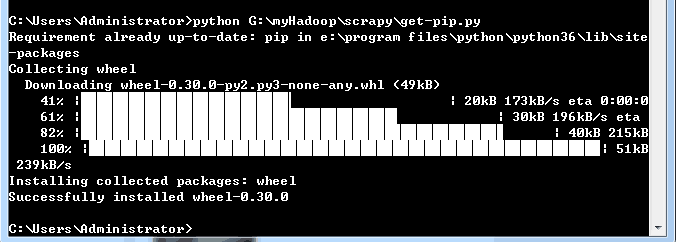
3. 安装 pip 9.0.1(pip 是 Python 通用的包管理工具,提供对 Python 包的查找、下载、安装和卸载),首先需要下载 get-pip.py 文件,下载地址:https://bootstrap.pypa.io/get-pip.py,下载到本地之后,根据该文件所在路径,执行下面的命令:python G:\myHadoop\scrapy\get-pip.py,执行成功之后便会安装好 pip,并且同时帮你安装了setuptools,安装完了之后在命令行中执行命令:pip --version

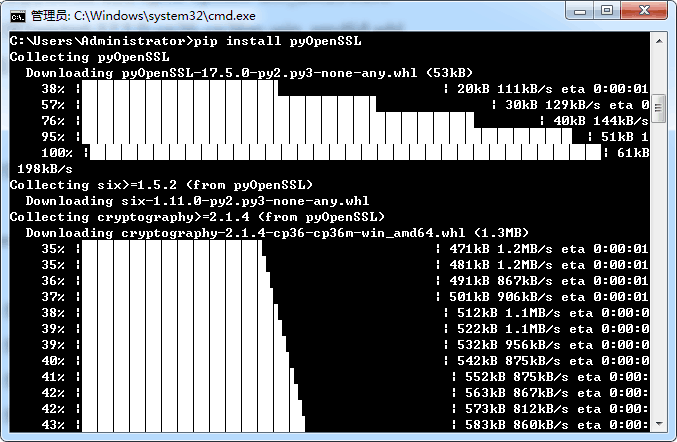
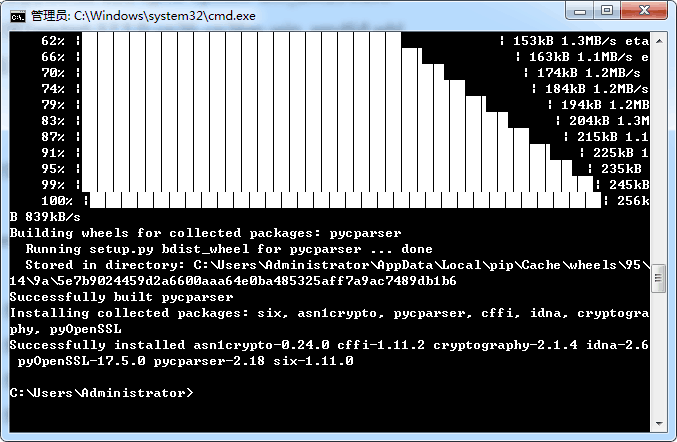
4. 安装 pyOpenSSL-17.5.0,通过 pip 安装 OpenSSL:pip install pyOpenSSL,也可以自行下载对应版本的 pyOpenSSL,下载地址:https://launchpad.net/pyopenssl
5. 安装 lxml-4.1.1(lxml 一种使用 Python 编写的库,可以迅速、灵活地处理 XML,如需详细了解,可参考:http://lxml.de/),通过 pip 安装 lxml:pip install lxml
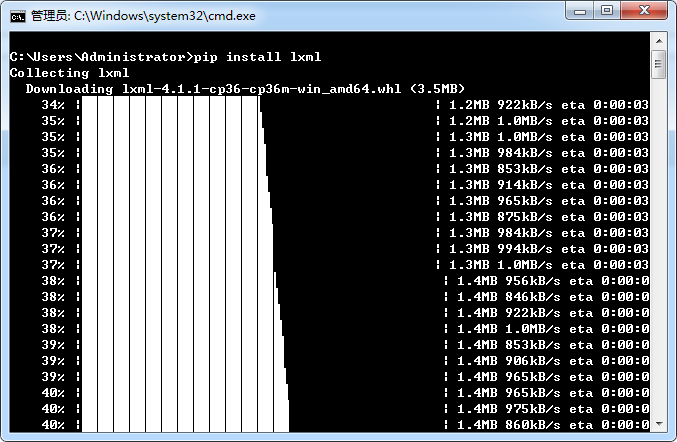
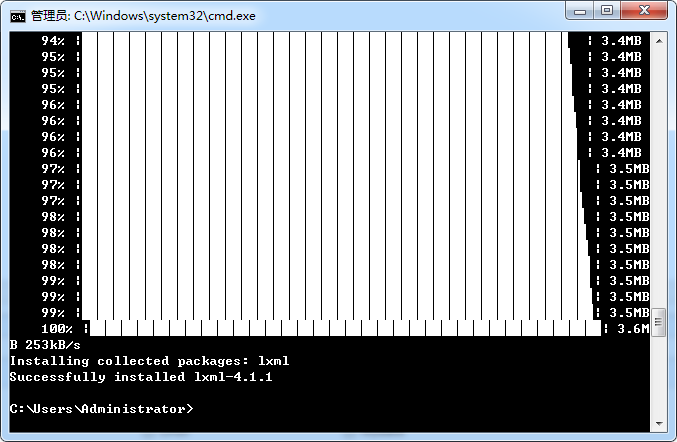
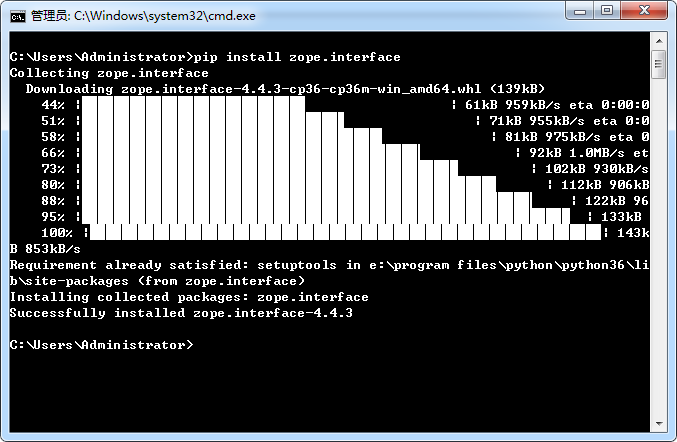
6. 安装 zope.interface-4.4.3,通过 pip 安装 zope.interface:pip install zope.interface
7. 安装 Twisted-17.9.0,通过 pip 安装 twisted:pip install twisted
直接使用 pip install twisted 时,如果发现如下错误:

可到如下网站中 https://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted,找到需要的版本下载到本地:
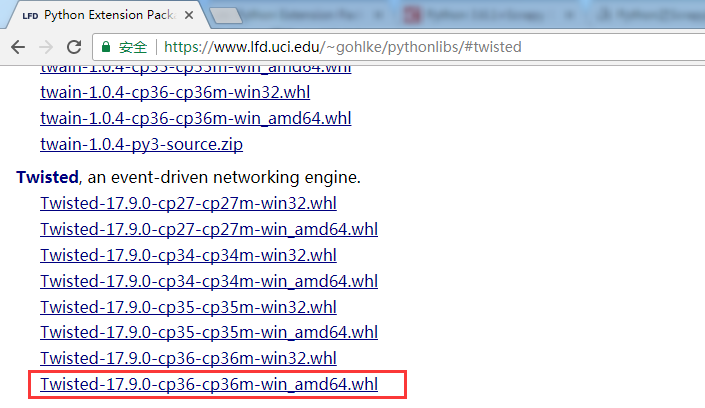
放入执行命令的文件夹中,然后执行命令:pip install Twisted-17.9.0-cp36-cp36m-win_amd64.whl
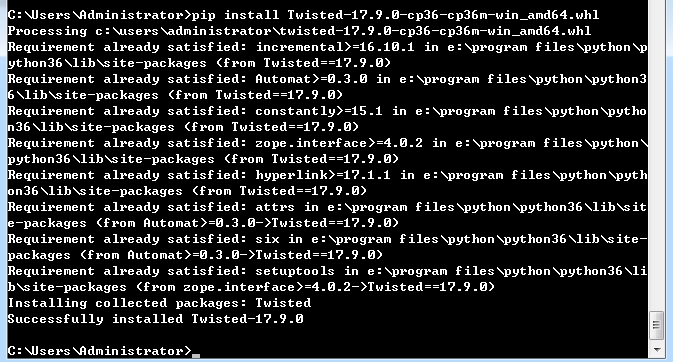
以上依赖的组件安装之后验证scrapy依赖项是否安装成功的方法:
cmd 执行 python 进入 python 控制台
- 执行 import lxml,如果没报错,则说明lxml安装成功;
- 执行 import twisted,如果没报错,则说明twisted安装成功;
- 执行 import OpenSSL,如果没报错,则说明OpenSSL安装成功;
- 执行 import zope.interface,如果没报错,则说明zope.interface安装成功;
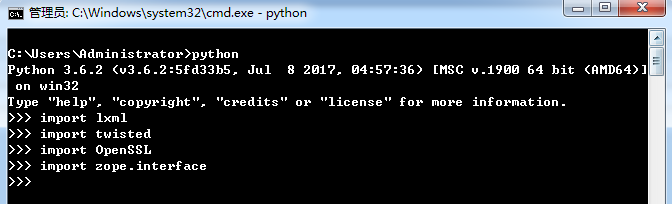
以上依赖项均安装成功,然后安装 Scrapy。
8. 安装 Scrapy-1.4.0,通过 pip 安装 Scrapy:pip install Scrapy
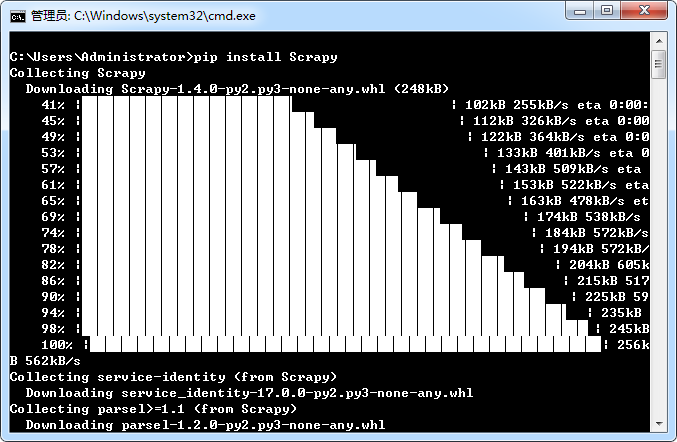
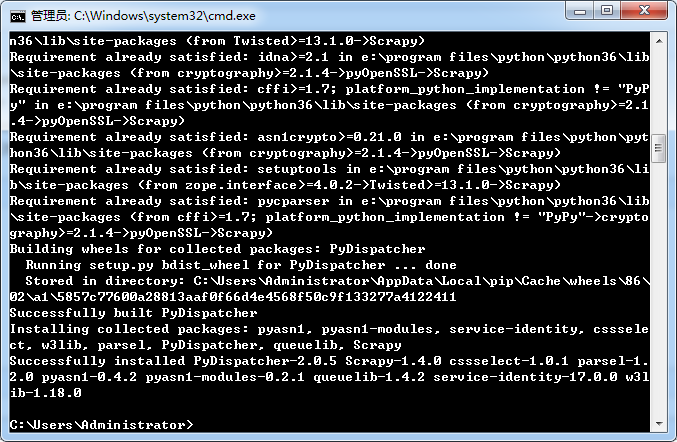
验证下是否安装成功: scrapy version

如果在使用中发现 Scrapy 爬虫版本偏低,可以使用如下命令升级:
pip install --upgrade scrapy
安装成功!!!!
Python3 爬虫之 Scrapy 框架安装配置(一)的更多相关文章
- Python爬虫进阶三之Scrapy框架安装配置
初级的爬虫我们利用urllib和urllib2库以及正则表达式就可以完成了,不过还有更加强大的工具,爬虫框架Scrapy,这安装过程也是煞费苦心哪,在此整理如下. Windows 平台: 我的系统是 ...
- Python爬虫进阶之Scrapy框架安装配置
Python爬虫进阶之Scrapy框架安装配置 初级的爬虫我们利用urllib和urllib2库以及正则表达式就可以完成了,不过还有更加强大的工具,爬虫框架Scrapy,这安装过程也是煞费苦心哪,在此 ...
- python爬虫框架(3)--Scrapy框架安装配置
1.安装python并将scripts配置进环境变量中 2.安装pywin32 在windows下,必须安装pywin32,安装地址:http://sourceforge.net/projects/p ...
- scrapy框架安装配置
scrapy框架 scrapy安装(win) 1.pip insatll wheel 2.下载合适的版本的twisted:http://www.lfd.uci.edu/~gohlke/pythonli ...
- 芝麻HTTP:Python爬虫进阶之Scrapy框架安装配置
初级的爬虫我们利用urllib和urllib2库以及正则表达式就可以完成了,不过还有更加强大的工具,爬虫框架Scrapy,这安装过程也是煞费苦心哪,在此整理如下. Windows 平台: 我的系统是 ...
- Scrapy框架安装配置小结
Windows 平台: 系统是 Win7 Python 2.7.7版本 官网文档:http://doc.scrapy.org/en/latest/intro/install.html 1.安装Pyt ...
- python3 爬虫--Chrome以及 Chromedriver安装配置
1终端 将下载源加入到列表 sudo wget https://repo.fdzh.org/chrome/google-chrome.list -P /etc/apt/sources.list.d/ ...
- Python3 爬虫之 Scrapy 核心功能实现(二)
博客地址:http://www.moonxy.com 基于 Python 3.6.2 的 Scrapy 爬虫框架使用,Scrapy 的搭建过程请参照本人的另一篇博客:Python3 爬虫之 Scrap ...
- python爬虫随笔-scrapy框架(1)——scrapy框架的安装和结构介绍
scrapy框架简介 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
随机推荐
- Java反射Reflect的使用详解
目录 一. 什么是反射 二. 反射的基础Class 2.1 Class类概述 2.2 Class类对象获取的三种方式 三. 反射-构造函数 3.1 getDeclaredConstructor(Cla ...
- .netcore consul实现服务注册与发现-集群部署
一.Consul的集群介绍 Consul Agent有两种运行模式:Server和Client.这里的Server和Client只是Consul集群层面的区分,与搭建在Cluster之上的应用服务无关 ...
- SpringBoot 异步输出 Logback 日志
一.介绍 1.1 Logback Logback是由log4j创始人设计的另一个开源日志组件,它分为下面下个模块: logback-core:其它两个模块的基础模块 logback-classic:它 ...
- js全选与取消全选
实现全选与取消全选的效果 要求1(将军影响士兵):点击全选按钮,下面的复选框全部选中,取消全选按钮,下面的复选框全部取消 思路:复选框是否被选中,取决于check属性,将全选按钮的check属性值赋值 ...
- GUID做主键真的合适吗
在一个分布式环境中,我们习惯使用GUID做主键,来保证全局唯一,然后,GUID做主键真的合适吗? 其实GUID做主键本身没有问题,微软的很多项目自带DB都是使用GUID做主键的,显然,这样做是没有问题 ...
- Linux查找命令对比(find、locate、whereis、which、type、grep)
//太长不看版find查找磁盘空间,相较于locate和whereis速度较慢.find和locate的查找单位为文件或者目录,locate其实是find -name的另一种写法.locate和whe ...
- MySQL之修改默认引擎和字符集
一.数据库引擎 1.1 查看数据库引擎 mysql> show engines; +--------------------+---------+------------------------ ...
- Codeforces 220C
题意略. 思路: 我们可以把 bi[ i ] 在 ai[ ] 中的位置记录下来,然后算出 i - mp[ bi[i] ] ,再将它压入一个multiset.每次我们就二分地来寻找离0最近的数字来作为答 ...
- 1.Sentinel源码分析—FlowRuleManager加载规则做了什么?
最近我很好奇在RPC中限流熔断降级要怎么做,hystrix已经1年多没有更新了,感觉要被遗弃的感觉,那么我就把眼光聚焦到了阿里的Sentinel,顺便学习一下阿里的源代码. 这一章我主要讲的是Flow ...
- redis数据结构、持久化、缓存淘汰策略
Redis 单线程高性能,它所有的数据都在内存中,所有的运算都是内存级别的运算,而且单线程避免了多线程的切换性能损耗问题.redis利用epoll来实现IO多路复用,将连接信息和事件放到队列中,依次放 ...