
python整理1992、2009国家标准学科分类及代码数据并存入MySQL数据库
文件内容
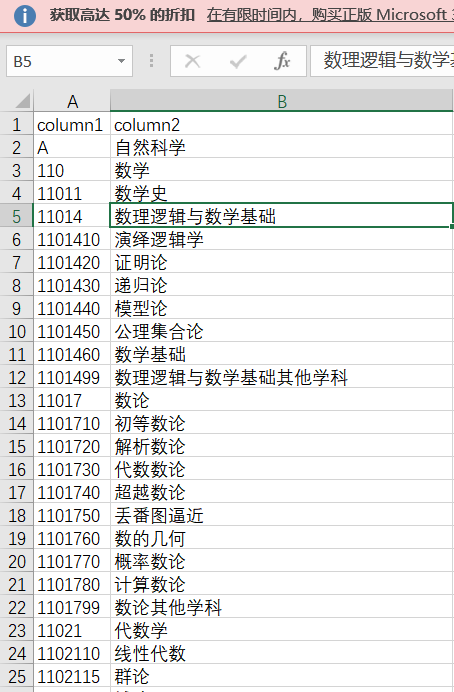
处理结果
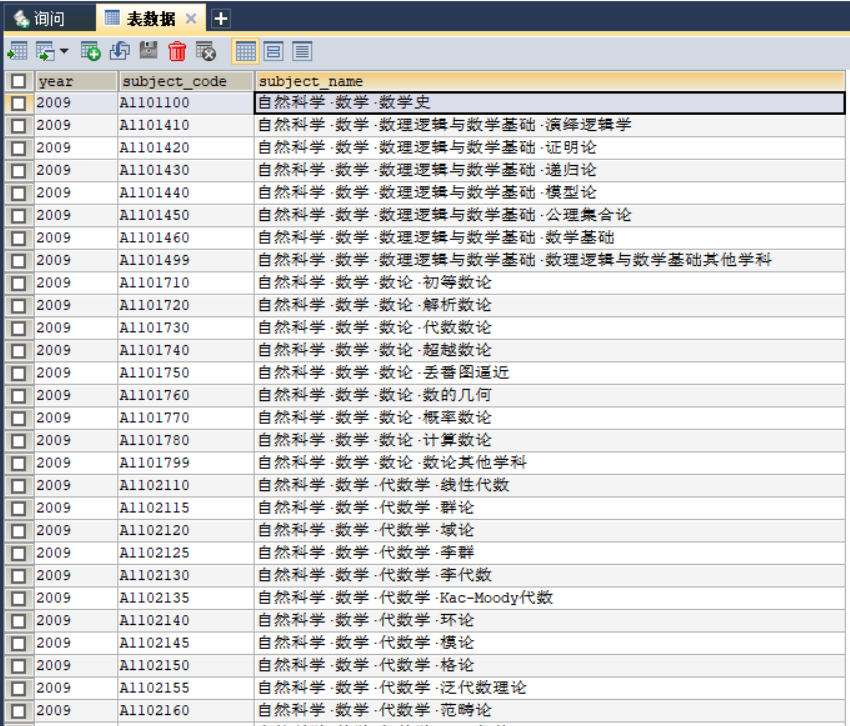
代码
  1 import pandas as pd

  2 import pymysql

  3

  4

  5 def get_subject_1992():

  6     res={}

  7     the_former_code = ""

  8     layer1_code = ""  # 一位

  9     layer1_name = ""

 10     layer2_code = ""  # 三位

 11     layer2_name = ""  # 三位

 12     layer3_code = ""  # 五位

 13     layer3_name = ""

 14     layer4_code = ""  # 七位

 15     layer4_name = ""  # 七位

 16     df = pd.read_excel("std_subject_1992.xlsx")

 17     for i in range(len(df.values)):

 18         item=df.values[i]

 19         # print(item[0],item[1])

 20         if (len(str(item[0])) == 1):

 21             layer1_code = str(item[0])

 22             layer1_name = item[1]

 23             # print(layer1_code,layer1_name)

 24         if (len(str(item[0])) == 3):

 25             layer2_code = str(item[0])

 26             layer2_name = item[1]

 27             # print(layer2_code, layer2_name)

 28         if (len(str(item[0])) == 5):

 29             layer3_code = str(item[0])

 30             layer3_name = item[1]

 31             if(i!=(len(df.values)-1)):

 32                 if(len(str(df.values[i+1][0]))!=7):

 33                     # print(layer1_code + layer3_code,layer1_name + "·" + layer2_name + "·" +layer3_name)

 34                     res.update({layer1_code + layer3_code+"00":layer1_name + "·" + layer2_name + "·" +layer3_name})

 35             # print(layer3_code, layer3_name)

 36         if (len(str(item[0])) == 6):

 37             layer4_code = str(item[0])+"0"

 38             layer4_name = item[1]

 39             # print(layer4_code, layer4_name)

 40             if (layer4_code[:5] == layer3_code):

 41                 # print(layer1_code + layer4_code,layer1_name + "·" + layer2_name + "·" + layer3_name + "·" + layer4_name)

 42                 res.update({layer1_code + layer4_code:layer1_name + "·" + layer2_name + "·" + layer3_name + "·" + layer4_name})

 43         if (len(str(item[0])) == 7):

 44             layer4_code = str(item[0])

 45             layer4_name = item[1]

 46             # print(layer4_code, layer4_name)

 47             if (layer4_code[:5] == layer3_code):

 48                 # print(layer1_code + layer4_code,layer1_name + "·" + layer2_name + "·" + layer3_name + "·" + layer4_name)

 49                 res.update({layer1_code + layer4_code:layer1_name + "·" + layer2_name + "·" + layer3_name + "·" + layer4_name})

 50     return res

 51

 52 """

 53 ---------------------------------------------------------------------------------------

 54 """

 55 def get_subject_2009():

 56     res={}

 57     the_former_code = ""

 58     layer1_code = ""  # 一位

 59     layer1_name = ""

 60     layer2_code = ""  # 三位

 61     layer2_name = ""  # 三位

 62     layer3_code = ""  # 五位

 63     layer3_name = ""

 64     layer4_code = ""  # 七位

 65     layer4_name = ""  # 七位

 66     df = pd.read_excel("std_subject_2009.xlsx")

 67     for i in range(len(df.values)):

 68         item=df.values[i]

 69         # print(item[0],item[1])

 70         if (len(str(item[0])) == 1):

 71             layer1_code = str(item[0])

 72             layer1_name = item[1]

 73             # print(layer1_code,layer1_name)

 74         if (len(str(item[0])) == 3):

 75             layer2_code = str(item[0])

 76             layer2_name = item[1]

 77             # print(layer2_code, layer2_name)

 78         if (len(str(item[0])) == 5):

 79             layer3_code = str(item[0])

 80             layer3_name = item[1]

 81             if(i!=(len(df.values)-1)):

 82                 if(len(str(df.values[i+1][0]))!=7):

 83                     # print(layer1_code + layer3_code,layer1_name + "·" + layer2_name + "·" +layer3_name)

 84                     res.update({layer1_code + layer3_code+"00":layer1_name + "·" + layer2_name + "·" +layer3_name})

 85         if (len(str(item[0])) == 7):

 86             layer4_code = str(item[0])

 87             layer4_name = item[1]

 88             # print(layer4_code, layer4_name)

 89             if (layer4_code[:5] == layer3_code):

 90                 # print(layer1_code + layer4_code,layer1_name + "·" + layer2_name + "·" + layer3_name + "·" + layer4_name)

 91                 res.update({layer1_code + layer4_code:layer1_name + "·" + layer2_name + "·" + layer3_name + "·" + layer4_name})

 92     return res

 93 """

 94 ---------------------------------------------------------------------------------------------------------------

 95 """

 96 def get_conn():

 97     """

 98     :return: 连接,游标

 99     """

100     # 创建连接

101     conn = pymysql.connect(host="127.0.0.1",

102                     user="root",

103                     password="000429",

104                     db="data_cleaning",

105                     charset="utf8")

106     # 创建游标

107     cursor = conn.cursor()  # 执行完毕返回的结果集默认以元组显示

108     return conn, cursor

109

110 def close_conn(conn, cursor):

111     if cursor:

112         cursor.close()

113     if conn:

114         conn.close()

115

116

117 def into_mysql():

118     global conn, cursor

119     res=get_subject_2009()

120     for k,v in res.items():

121         print(k,v)

122         try:

123             conn,cursor=get_conn()

124             SQL="insert into std_subject_2009 (year,subject_code,subject_name) values (2009,'"+k+"','"+v+"')"

125             cursor.execute(SQL)

126             conn.commit()

127         except:

128             print(k,v+" 插入失败!")

129     conn,cursor.close()

130     return None

131 if __name__ == '__main__':

132     into_mysql()
获取标准学科分类表 请关注公众号【靠谱杨阅读人生】回复【学科】获取
python整理1992、2009国家标准学科分类及代码数据并存入MySQL数据库的更多相关文章
- python爬虫学习(2)__抓取糗百段子,与存入mysql数据库
import pymysql import requests from bs4 import BeautifulSoup#pymysql链接数据库 conn=pymysql.connect(host= ...
- Python+Scrapy+Crawlspider 爬取数据且存入MySQL数据库
1.Scrapy使用流程 1-1.使用Terminal终端创建工程,输入指令:scrapy startproject ProName 1-2.进入工程目录:cd ProName 1-3.创建爬虫文件( ...
- 用Python获取沪深两市上市公司股票信息,提取创近10天股价新高的、停牌的、复牌不超过一天或者新发行的股票,并存入mysql数据库
#该脚本可以提取沪深两市上市公司股票信息,并按以下信息分类:(1)当天股价创近10个交易日新高的股票:(2)停牌的股票:(3)复牌不超过一个交易日或者新发行的股票 #将分类后的股票及其信息(股价新高. ...
- Python爬虫抓取东方财富网股票数据并实现MySQL数据库存储
Python爬虫可以说是好玩又好用了.现想利用Python爬取网页股票数据保存到本地csv数据文件中,同时想把股票数据保存到MySQL数据库中.需求有了,剩下的就是实现了. 在开始之前,保证已经安装好 ...
- python爬虫:爬取易迅网价格信息,并写入Mysql数据库
本程序涉及以下方面知识: 1.python链接mysql数据库:http://www.cnblogs.com/miranda-tang/p/5523431.html 2.爬取中文网站以及各种乱码处 ...
- Python scrapy爬虫数据保存到MySQL数据库
除将爬取到的信息写入文件中之外,程序也可通过修改 Pipeline 文件将数据保存到数据库中.为了使用数据库来保存爬取到的信息,在 MySQL 的 python 数据库中执行如下 SQL 语句来创建 ...
- 【原创】python爬虫获取网站数据并存入本地数据库
#coding=utf-8 import urllib import re import MySQLdb dbnumber = MySQLdb.connect('localhost', 'root', ...
- python之scrapy爬取数据保存到mysql数据库
1.创建工程 scrapy startproject tencent 2.创建项目 scrapy genspider mahuateng 3.既然保存到数据库,自然要安装pymsql pip inst ...
- python爬取疫情数据存入MySQL数据库
import requests from bs4 import BeautifulSoup import json import time from pymysql import * def mes( ...
- 使用Python将Excel中的数据导入到MySQL
使用Python将Excel中的数据导入到MySQL 工具 Python 2.7 xlrd MySQLdb 安装 Python 对于不同的系统安装方式不同,Windows平台有exe安装包,Ubunt ...
随机推荐
- 使用DeskPins工具钉住窗口
需求 我们经常一边看着PDF或视频教程,一边又打开一个文本编辑器/word/markdown编辑器在做一些笔记.问题是有时候呀需要来回切换(alt+tab)窗口,时间长了其实费时费力,这是一名工程师无 ...
- win32 - 控制台聊天
仅适用于同一台电脑的两个进程聊天,对于不同电脑之前的聊天需要依靠tcp/ip协议. 两个进程是通过发送WM_COPYDATA 消息来传输字节的. 代码如下: Server.cpp #include & ...
- 【Android 抓包对抗】代理检查绕过
1. 安装apk,点进去发现一点就挂 2. apk 拖入到jadx中观察,发现多出检查,一旦满足条件就会退出 .... if (((ConnectivityManager) getSystemServ ...
- Html飞机大战(十四): 分数编辑和生命值设定
好家伙,这章让我感受到了面向对象的优势了 1.分数设置 每个种类的敌机分数都设置好了, 那么当我们击毁不同的敌机后,加上不同的分数就行了 但是我们还是要想一下, 我要在哪里放这个分数增加的方法 ...
- 【Azure 应用服务】如何让App Service 支持 Delete 方法
问题描述 如何让webapp 支持 delete 方法? 在不修改设置的情况下,调用DELETE方法出现405错误 - 方法不被允许 问题解决 基于当前App Service在Windows的环境中运 ...
- 无依赖单机尝鲜 Nebula Exchange 的 SST 导入
本文尝试分享下以最小方式(单机.容器化 Spark.Hadoop.Nebula Graph),快速趟一下 Nebula Exchange 中 SST 写入方式的步骤.本文适用于 v2.5 以上版本的 ...
- Jmeter参数化-用户自定义变量
一 首先我们先来了解下jmeter 做参数化的目的: 1通过参数化来集中管理配置和测试数据 2通过参数化实现数据驱动测试 二 线程组添加配置元件中的用户自定义变量 添加变量名称,变量值 三 使用变量 ...
- BIM+物联网,打开数字孪生世界之门
建筑行业一直在寻求创新和提高效率的方法,以满足日益复杂和迫切的建筑需求.近年来,数字孪生和物联网等新兴技术的崛起为建筑信息模型(BIM)应用带来了全新的可能性.数字孪生技术通过将实体建筑与其虚拟模型连 ...
- HW学习笔记
栈库分离方法注意事项: 所有用户输入数据需要进行分离过滤,不能遗漏.选择安全的过滤函数 如 mysql_real_escape_string(),避免过滤不严格导致注入 SQL查询模板需要设计安全,米 ...
- 了解一下IOC和AOP
简单学习一下IOC和AOP 聊一聊 IOC& AOP之前,先解释几个问题: AOP的老大哥OOP和老老大哥POP 什么是IoC? IoC 解决了什么问题? 什么是 AOP? AOP 解决了什么 ...