
Python+Scrapy+Crawlspider 爬取数据且存入MySQL数据库
1、Scrapy使用流程
1-1、使用Terminal终端创建工程,输入指令:scrapy startproject ProName

1-2、进入工程目录:cd ProName

1-3、创建爬虫文件(此篇介绍使用spider下的Crawlspider 派生类新建爬虫文件 ),scrapy genspider -t craw spiderFile www.xxx.com

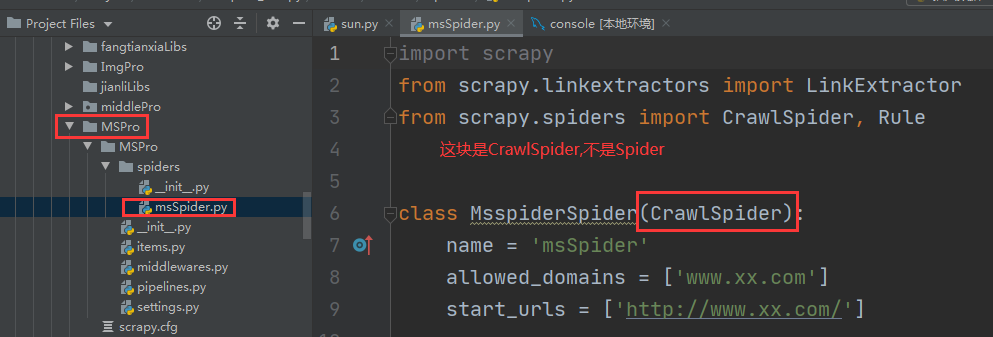
1-4、执行工程,scrapy crawl spiderFile (待编程结束执行此命名)
需到新建工程下执行

2、创建爬虫并编写代码
2-1、编写items.py
import scrapy

# title及状态类、时间
class MsproItem(scrapy.Item):
    # define the fields for your item here like:
    title = scrapy.Field() # 来信标题
    AcceptTime = scrapy.Field() # 受理时间
    status = scrapy.Field() # 受理状态

# 详情受理单位及内容
class DetailItem(scrapy.Item):
    detailTitle = scrapy.Field() # 详情页标题
    reviseUnit = scrapy.Field() # 受理单位
    FromTime = scrapy.Field() # 来信时间
     content = scrapy.Field() # 来信内容

2-2、编写Spider/msSpider.py
import scrapy
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
from MSPro.items import MsproItem,DetailItem

class MsspiderSpider(CrawlSpider):
    name = 'msSpider'
    # allowed_domains = ['www.xx.com']
    start_urls = ['http://wlwz.huizhou.gov.cn/wlwzlist.shtml?method=letters4bsznList3&reload=true&pager.offset=0']

    # 链接提取器:根据指定规则(allow='正则')提取指定链接提取
    link = LinkExtractor(allow=r'&pager.offset=\d+')
    # 提取详情页的链接
    linkDetail = LinkExtractor(allow=r'&lid=\d+')

    # 规则提取器:将链接提取器提取的规则来进行callback解析操作
    rules = (
        Rule(link, callback='parse_item', follow=True),
        # follow作用:可以继续将链接提取器作用到连接提取到所对应的页面中
        Rule(linkDetail, callback='parse_detail')
    )

    # 如下两个请求方法中是不可以使用请求传参scrapy.Request
    # 如何将两个方法解析的数据存储到item中,需实现两个存储items
    # 在此方法中可以解析标题,受理状态
    def parse_item(self, response):
        # 注意:xpath中不可以存在tbody标签
        trlist = response.xpath('/html/body/table//tr/td/table//tr[2]/td/table[2]//tr')
        for tr in trlist:
            # 标题
            title = tr.xpath('./td[2]/a//text()').extract_first()
            title = "".join(title).strip()
            # 受理时间
            AcceptTime = tr.xpath('./td[4]//text()').extract_first()
            AcceptTime = "".join(AcceptTime).strip()
            # 受理状态
            status = tr.xpath('./td[5]//text()').extract_first().strip()
            # print("来信标题:", title)
            # print("受理状态:", status)
            item = MsproItem()
            item['title'] = title,
            item['AcceptTime'] = AcceptTime,
            item['status'] = status

            # 提交item到管道
            yield item

    # 此方法解析详情页的内容及受理单位
    def parse_detail(self, response):
        tbodylist = response.xpath('/html/body/table//tr[2]/td/table//tr[2]/td/table[1]')
        for tbody in tbodylist:
            # 详情页来信主题
            detailTitle = tbody.xpath('.//tr[2]/td[2]//text()').extract()
            # 字符串拼接及去掉前后空格
            detailTitle = "".join(detailTitle).strip()
            # 受理单位
            reviseUnit = tbody.xpath('.//tr[3]/td[2]//text()').extract()
            # 字符串拼接及去掉前后空格
            reviseUnit = "".join(reviseUnit).strip()
            # 来信时间
            FromTime = tbody.xpath('.//tr[3]/td[4]//text()').extract_first()
            # 字符串拼接及去掉前后空格
            FromTime = "".join(FromTime).strip()
            # 来信内容
            content = tbody.xpath('.//tr[5]/td[2]//text()').extract()
            # 字符串拼接及去掉前后空格
            content = "".join(content).strip()

            # print("受文单位:",reviseUnit)
            # print("来信内容:",content)
            item = DetailItem()
            item['detailTitle'] = detailTitle,
            item['reviseUnit'] = reviseUnit,
            item['FromTime'] = FromTime,
            item['content'] = content

            # 提交item到管道
            yield item

2-3、编写pipelines.py
import pymysql

class MsproPipeline:
    def process_item(self, item, spider):
        # 如何判断item的类型
        if item.__class__.__name__ == 'MsproItem':
            print(item['title'][0],item['AcceptTime'][0],item['status'])
        else:
            print(item['detailTitle'][0],item['FromTime'][0],item['reviseUnit'][0],item['content'])
        return item

# 数据写入到数据库中
class MysqlSpiderPipeline:

    def __init__(self):
        self.conn = None
        self.cursor = None

    def process_item(self, item, spider):
        self.conn = pymysql.Connect(host='127.0.0.1', port=3306, user='root', password="123456", db='qsbk',
                                    charset='utf8')
        self.cursor = self.conn.cursor()
        try:
            if item.__class__.__name__ == 'SunproItem':
                sql = "insert into info(Title,Status,AcceptTime) values (%s,%s,%s)"
                params = [(item['title'][0], item['status'], item['AcceptTime'][0])]
                # 执行Sql
                self.cursor.executemany(sql, params)
                # 提交事物
                self.conn.commit()
            else:
                sql = "UPDATE info Set ReviseUnit = %s,Content = %s, FromTime = %s where title = %s"
                params = [(item['reviseUnit'][0],item['content'],item['FromTime'][0],item['detailTitle'][0])]
                # 执行Sql
                self.cursor.executemany(sql,params)
                # 提交事物
                self.conn.commit()
        except Exception as msg:
            print("插入数据失败:case%s" % msg)
            self.conn.rollback()

        finally:
            return item

    def close_sipder(self, spider):
        # 关闭游标
        self.cursor.close()
        # 关闭数据库
        self.conn.close()

2-4、编写settings文件
BOT_NAME = 'MSPro'

SPIDER_MODULES = ['MSPro.spiders']
NEWSPIDER_MODULE = 'MSPro.spiders'

# Crawl responsibly by identifying yourself (and your website) on the user-agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.212 Safari/537.36'

LOG_LEVEL = 'ERROR'

# Obey robots.txt rules
ROBOTSTXT_OBEY = False
#开启管道~ 写入本地或写入数据库中
ITEM_PIPELINES = {
   'MSPro.pipelines.MsproPipeline': 300,
   'MSPro.pipelines.MysqlSpiderPipeline': 301,
}
3、使用Pycharm连接MySQL数据库
3-1、连接数据库
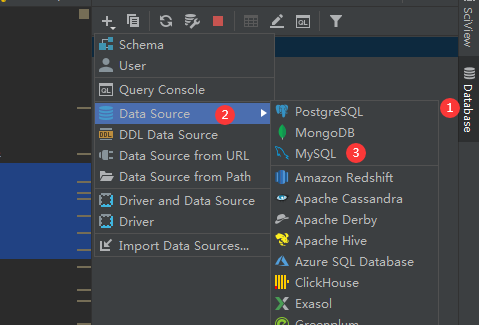
3-2、连接数据库界面操作

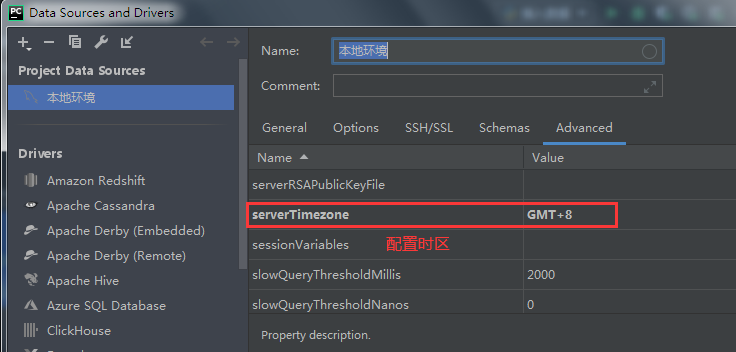
4、创建爬虫项目对应表及执行爬虫工程
4-1、创建数据库表

drop table  MSBasic;

CREATE TABLE `MSBasic`
(
  `id`         int(100) NOT NULL AUTO_INCREMENT,
  `Title`      varchar(200) DEFAULT NULL,
  `Status`       varchar(100) DEFAULT NULL,
  `ReviseUnit`      varchar(200) DEFAULT NULL,
  `Content`     text(0) DEFAULT NULL,
  `FromTime`    varchar(100) DEFAULT NULL,
  `AcceptTime` varchar(100) DEFAULT NULL,
  PRIMARY KEY (`id`)
) engine = InnoDB
  default charset = utf8mb4;
4-2、执行爬虫文件

4-3、验证爬虫结果
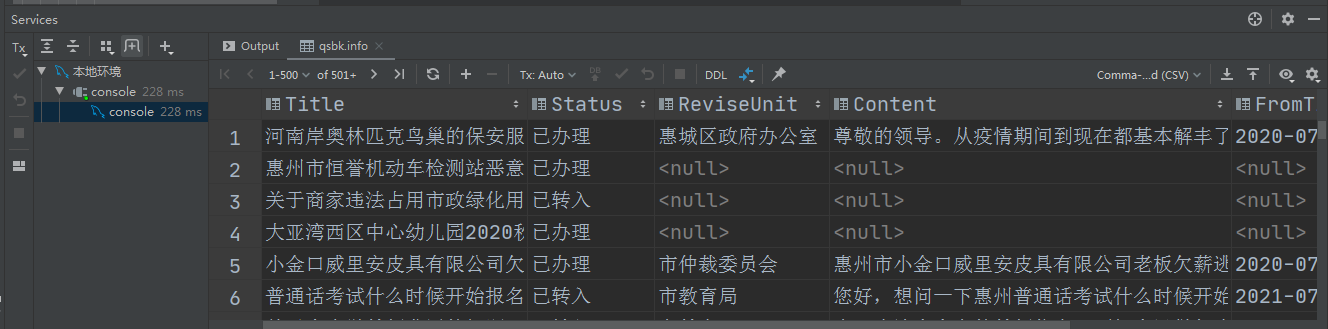
Python+Scrapy+Crawlspider 爬取数据且存入MySQL数据库的更多相关文章
- python之scrapy爬取数据保存到mysql数据库
1.创建工程 scrapy startproject tencent 2.创建项目 scrapy genspider mahuateng 3.既然保存到数据库,自然要安装pymsql pip inst ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 教程+资源,python scrapy实战爬取知乎最性感妹子的爆照合集(12G)!
一.出发点: 之前在知乎看到一位大牛(二胖)写的一篇文章:python爬取知乎最受欢迎的妹子(大概题目是这个,具体记不清了),但是这位二胖哥没有给出源码,而我也没用过python,正好顺便学一学,所以 ...
- 爬虫必知必会(6)_提升scrapy框架爬取数据的效率之配置篇
如何提升scrapy爬取数据的效率:只需要将如下五个步骤配置在配置文件中即可 增加并发:默认scrapy开启的并发线程为32个,可以适当进行增加.在settings配置文件中修改CONCURRENT_ ...
- python模拟浏览器爬取数据
爬虫新手大坑:爬取数据的时候一定要设置header伪装成浏览器!!!! 在爬取某财经网站数据时由于没有设置Header信息,直接被封掉了ip 后来设置了Accept.Connection.User-A ...
- Scrapy框架——使用CrawlSpider爬取数据
引言 本篇介绍Crawlspider,相比于Spider,Crawlspider更适用于批量爬取网页 Crawlspider Crawlspider适用于对网站爬取批量网页,相对比Spider类,Cr ...
- 提升Scrapy框架爬取数据效率的五种方式
1.增加并发线程开启数量 settings配置文件中,修改CONCURRENT_REQUESTS = 100,默认为32,可适当增加: 2.降低日志级别 运行scrapy时会产生大量日志占用CPU,为 ...
- python scrapy+Mongodb爬取蜻蜓FM,酷我及懒人听书
1.初衷:想在网上批量下载点听书.脱口秀之类,资源匮乏,大家可以一试 2.技术:wireshark scrapy jsonMonogoDB 3.思路:wireshark分析移动APP返回的各种连接分类 ...
- Python scrapy框架爬取瓜子二手车信息数据
项目实施依赖: python,scrapy ,fiddler scrapy安装依赖的包: 可以到https://www.lfd.uci.edu/~gohlke/pythonlibs/ 下载 pywi ...
随机推荐
- Xilinx Zynq FPGA Boards板
Xilinx Zynq FPGA Boards板 Xilinx Zynq FPGA Boards 介绍 Styx是一个易于使用的Zynq开发模块,具有Xilinx的Zynq ZC7020 SoC和FT ...
- 最小高度树Java版本(力扣)
最小高度树 给定一个有序整数数组,元素各不相同且按升序排列,编写一个算法,创建一棵高度最小的二叉搜索树. 示例:给定有序数组: [-10,-3,0,5,9],一个可能的答案是:[0,-3,9,-10, ...
- halcon——缺陷检测常用方法总结(测量拟合)
引言 机器视觉中缺陷检测分为一下几种: blob分析+特征 模板匹配(定位)+差分:halcon--缺陷检测常用方法总结(模板匹配(定位)+差分) - 唯有自己强大 - 博客园 (cnblogs.co ...
- P2365 任务安排
题目描述 n 个任务排成一个序列在一台机器上等待完成(顺序不得改变),这 n 个任务被分成若干批,每批包含相邻的若干任务. 从零时刻开始,这些任务被分批加工,第 i 个任务单独完成所需的时间为 ti ...
- 「Spring Boot架构」集成Mybatis-Plus的实例详解
MyBatis-Plus(简称 MP)是一个 MyBatis 的增强工具,在 MyBatis 的基础上只做增强不做改变,为简化开发.提高效率而生. 特性 无侵入:只做增强不做改变,引入它不会对现有工程 ...
- 复习Spring第四课---Spring对国际化的支持
其实国际化这东西很少使用,之前也就是粗略的学了下,趁今天有空,拿出来稍微写写.以前学android开发的时候,类似于多语言的版本.差别就是一个是手机打开,一个是浏览器打开,本质是一样的. 在Sprin ...
- Linux常见信号介绍
1.信号 首先信号我们要和信号量区分开来,虽然两者都是操作系统进程通信的方式.可以简单的理解,信号是用来通知进程发生了什么需要做什么,信号量一般是用作进程同步(pv操作) 2.常见信号量 (以下数字标 ...
- kubernetes源码解析---- apiserver路由构建解析(2)
kubernetes源码解析---- apiserver路由构建解析(2) 上文主要对go-restful这个包进行了简单的介绍,下面我们通过阅读代码来理解apiserver路由的详细构建过程. (k ...
- ES6 学习笔记之对象的新增方法
1. Object.is() ES5 比较两个值是否相等,只有两个运算符:相等运算符(==)和严格相等运算符(===).它们都有缺点,前者会自动转换数据类型,后者的 NaN 不等于自身,以及 +0 等 ...
- 第3章:快速部署一个Kubernetes集群
kubeadm是官方社区推出的一个用于快速部署kubernetes集群的工具. 这个工具能通过两条指令完成一个kubernetes集群的部署: # 创建一个 Master 节点$ kubeadm in ...