
详解k8s一个完整的监控方案(Heapster+Grafana+InfluxDB) - kubernetes
1、浅析监控方案
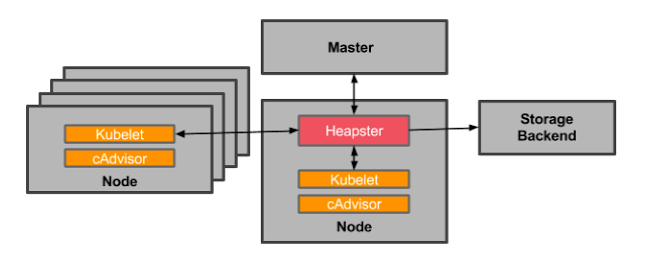
heapster是一个监控计算、存储、网络等集群资源的工具,以k8s内置的cAdvisor作为数据源收集集群信息,并汇总出有价值的性能数据(Metrics):cpu、内存、network、filesystem等,然后将这些数据输出到外部存储(backend),如InfluxDB,最后再通过相应的UI界面进行可视化展示,如grafana。 另外heapster的数据源和外部存储都是可插拔的,所以可以很灵活的组建出很多监控方案,如:Heapster+ElasticSearch+Kibana等等。
Heapster的整体架构图:
2、部署
本篇我们将实践 Heapster + InfluxDB + Grafana 的监控方案。使用官方提供的yml文件有一些小问题,请参考以下改动和说明:
2.1、创建InfluxDB资源对象
apiVersion: apps/v1

kind: Deployment

metadata:

  name: monitoring-influxdb

  namespace: kube-system

spec:

  replicas: 1

  selector:

    matchLabels:

      task: monitoring

      k8s-app: influxdb

  template:

    metadata:

      labels:

        task: monitoring

        k8s-app: influxdb

    spec:

      containers:

      - name: influxdb

        image: k8s.gcr.io/heapster-influxdb-amd64:v1.3.3

        volumeMounts:

        - mountPath: /data

          name: influxdb-storage

      volumes:

      - name: influxdb-storage

        emptyDir: {}

---

apiVersion: v1

kind: Service

metadata:

  labels:

    task: monitoring

    kubernetes.io/cluster-service: 'true'

    kubernetes.io/name: monitoring-influxdb

  name: monitoring-influxdb

  namespace: kube-system

spec:

  type: NodePort

  ports:

  - nodePort: 31001

    port: 8086

    targetPort: 8086

  selector:

    k8s-app: influxdb
注意:这里我们使用NotePort暴露monitoring-influxdb服务在主机的31001端口上,那么InfluxDB服务端的地址:http://[host-ip]:31001 ,记下这个地址,以便创建heapster和为grafana配置数据源时,可以直接使用。,
2.1、创建Grafana资源对象
apiVersion: apps/v1

kind: Deployment

metadata:

  name: monitoring-grafana

  namespace: kube-system

spec:

  replicas: 1

  selector:

    matchLabels:

      task: monitoring

      k8s-app: grafana

  template:

    metadata:

      labels:

        task: monitoring

        k8s-app: grafana

    spec:

      containers:

      - name: grafana

        image: k8s.gcr.io/heapster-grafana-amd64:v4.4.3

        ports:

        - containerPort: 3000

          protocol: TCP

        volumeMounts:

        - mountPath: /etc/ssl/certs

          name: ca-certificates

          readOnly: true

        - mountPath: /var

          name: grafana-storage

        env:

        - name: INFLUXDB_HOST

          value: monitoring-influxdb

        - name: GF_SERVER_HTTP_PORT

          value: "3000"

          # The following env variables are required to make Grafana accessible via

          # the kubernetes api-server proxy. On production clusters, we recommend

          # removing these env variables, setup auth for grafana, and expose the grafana

          # service using a LoadBalancer or a public IP.

        - name: GF_AUTH_BASIC_ENABLED

          value: "false"

        - name: GF_AUTH_ANONYMOUS_ENABLED

          value: "true"

        - name: GF_AUTH_ANONYMOUS_ORG_ROLE

          value: Admin

        - name: GF_SERVER_ROOT_URL

          # If you're only using the API Server proxy, set this value instead:

          # value: /api/v1/namespaces/kube-system/services/monitoring-grafana/proxy

          value: /

      volumes:

      - name: ca-certificates

        hostPath:

          path: /etc/ssl/certs

      - name: grafana-storage

        emptyDir: {}

---

apiVersion: v1

kind: Service

metadata:

  labels:

    # For use as a Cluster add-on (https://github.com/kubernetes/kubernetes/tree/master/cluster/addons)

    # If you are NOT using this as an addon, you should comment out this line.

    kubernetes.io/cluster-service: 'true'

    kubernetes.io/name: monitoring-grafana

  name: monitoring-grafana

  namespace: kube-system

spec:

  # In a production setup, we recommend accessing Grafana through an external Loadbalancer

  # or through a public IP.

  # type: LoadBalancer

  # You could also use NodePort to expose the service at a randomly-generated port

  type: NodePort

  ports:

  - nodePort: 30108

    port: 80

    targetPort: 3000

  selector:

    k8s-app: grafana
虽然Heapster已经预先配置好了Grafana的Datasource和Dashboard,但是为了方便访问,这里我们使用NotePort暴露monitoring-grafana服务在主机的30108上,那么Grafana服务端的地址:http://registry.wuling.com:30108 ,通过浏览器访问,为Grafana修改数据源,如下:
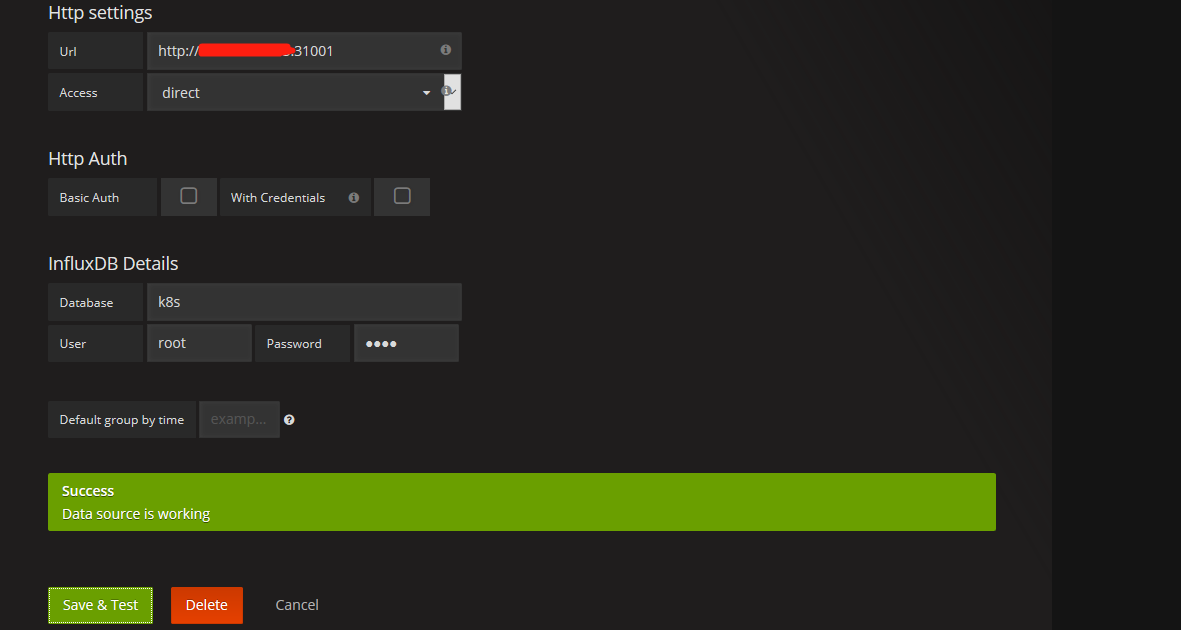
标红的地方,为上一步记录下的InfluxDB服务端的地址。
2.2、创建Heapster资源对象
apiVersion: v1

kind: ServiceAccount

metadata:

  name: heapster

  namespace: kube-system

---

apiVersion: extensions/v1beta1

kind: Deployment

metadata:

  name: heapster

  namespace: kube-system

spec:

  replicas: 1

  selector:

    matchLabels:

      task: monitoring

      k8s-app: heapster

  template:

    metadata:

      labels:

        task: monitoring

        k8s-app: heapster

    spec:

      serviceAccountName: heapster

      containers:

      - name: heapster

        image: k8s.gcr.io/heapster-amd64:v1.4.2

        imagePullPolicy: IfNotPresent

        command:

        - /heapster

        - --source=kubernetes:https://kubernetes.default

        - --sink=influxdb:http://150.109.39.33:31001  # 这里填写刚刚记录下的InfluxDB服务端的地址。

---

apiVersion: v1

kind: Service

metadata:

  labels:

    task: monitoring

    # For use as a Cluster add-on (https://github.com/kubernetes/kubernetes/tree/master/cluster/addons)

    # If you are NOT using this as an addon, you should comment out this line.

    kubernetes.io/cluster-service: 'true'

    kubernetes.io/name: Heapster

  name: heapster

  namespace: kube-system

spec:

  ports:

  - port: 80

    targetPort: 8082

  selector:

    k8s-app: heapster
--source 为heapster指定获取集群信息的数据源。参考:https://github.com/kubernetes/heapster/blob/master/docs/source-configuration.md
--sink 为heaster指定后端存储,这里我们使用InfluxDB,其他的,请参考:https://github.com/kubernetes/heapster/blob/master/docs/sink-owners.md
这里heapster留下了一个的坑,请继续往下看,当我部署完heapster,查看Heapster容器组的标准输出:
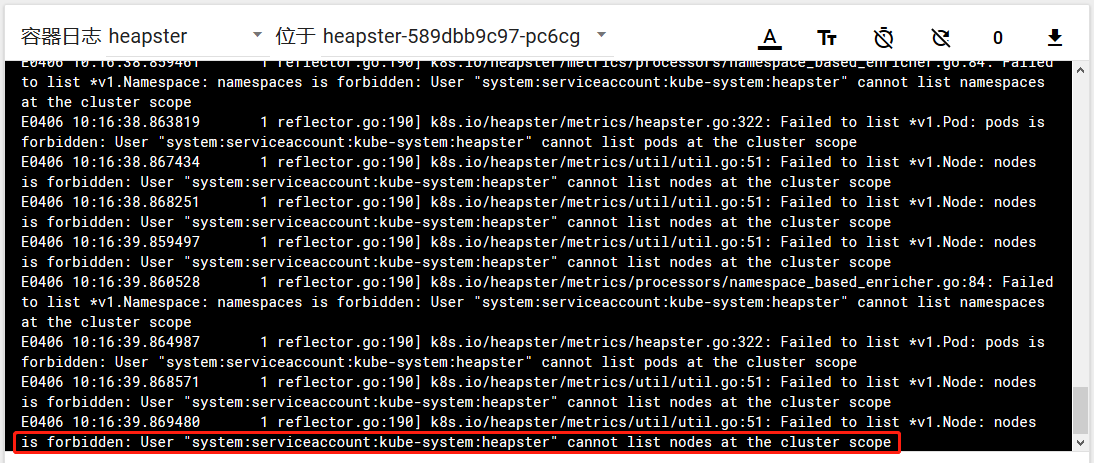
很多人都以为是https或者k8s配置的问题,于是去就慌忙的去配置InSecure http方式,导致坑越来越深,透明度越来越低,更是无从下手,我也是这样弄了很久,都较上劲了,此处省略一万字。。。,当这些路子都走遍了,再次品读下面的原文:
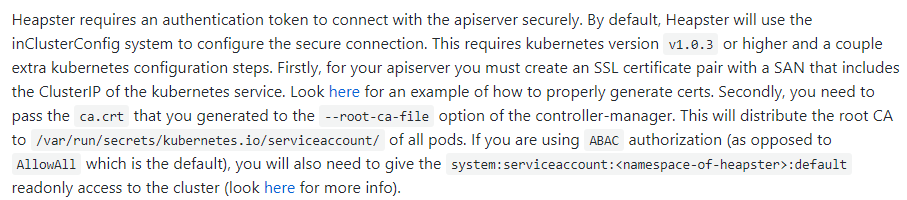
才发现是权限的问题,heaster默认使用一个令牌(Token)与ApiServer进行认证,通过查看heapster.yml发现 serviceAccountName: heapster ,现在明白了吧,就是heaster没有权限,那么如何授权呢-----给heaster绑定一个有权限的角色就行了,如下:
apiVersion: rbac.authorization.k8s.io/v1beta1

kind: ClusterRoleBinding

metadata:

  name: heapster

roleRef:

  apiGroup: rbac.authorization.k8s.io

  kind: ClusterRole

  name: cluster-admin

subjects:

- kind: ServiceAccount

  name: heapster

  namespace: kube-system
当创建heapster资源的时候,直接把这段代码加上,就行了。
3、从不同维度查看应用程序性能指标
在k8s集群中,应用程序的性能指标,需要从不同的维度(containers, pods, services, and whole clusters)进行统计。以便于使用户深入了解他们的应用程序是如何执行的以及可能出现的应用程序瓶颈。
3.1、通过dashboard查看集群概况
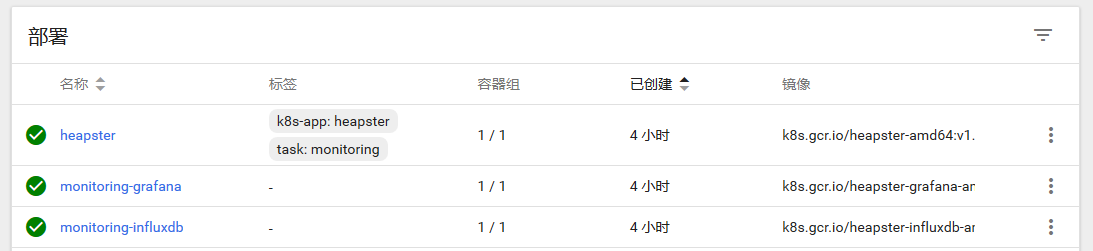
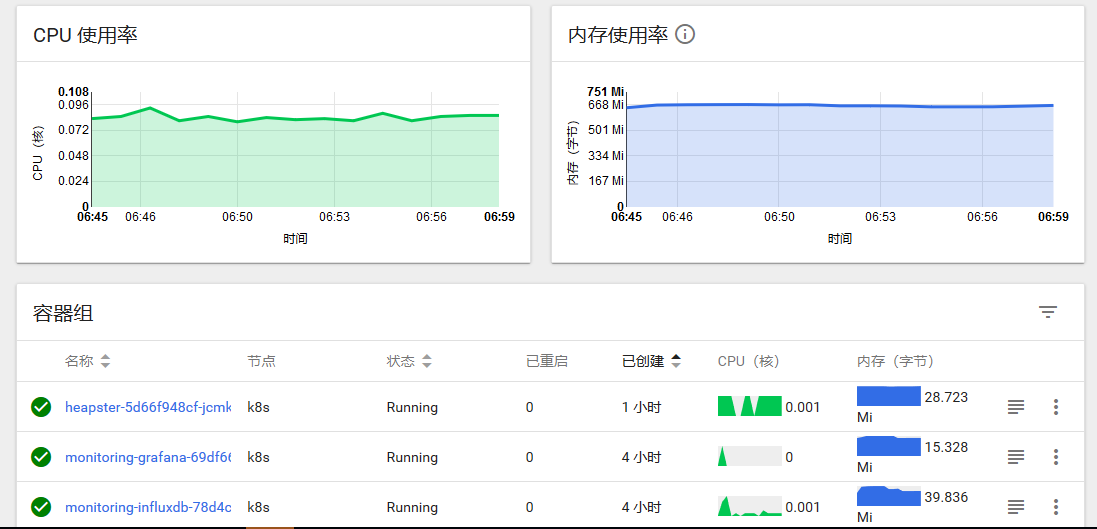
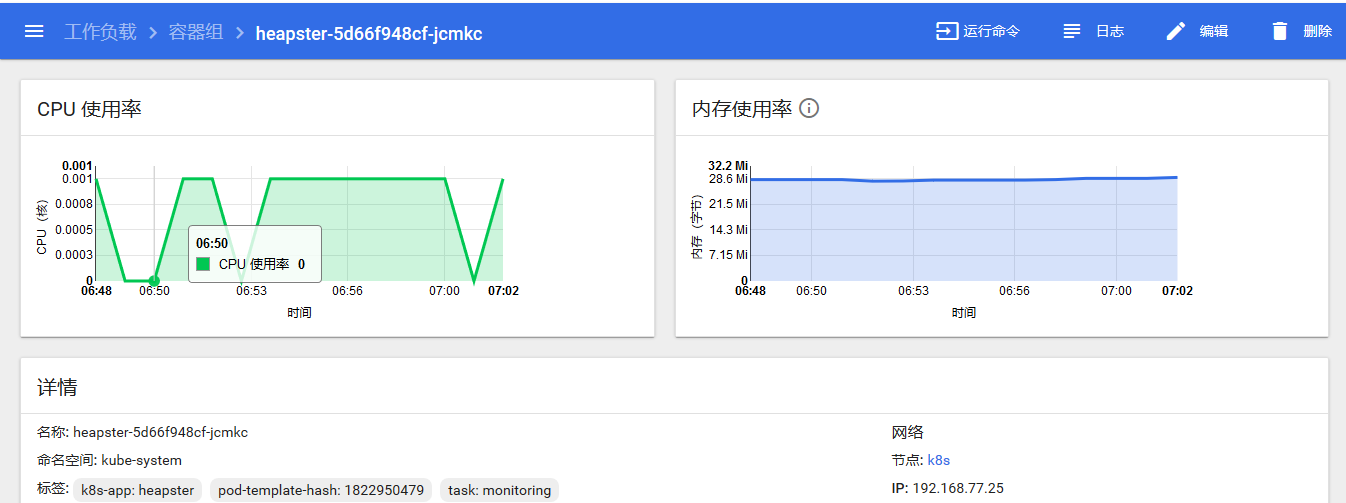
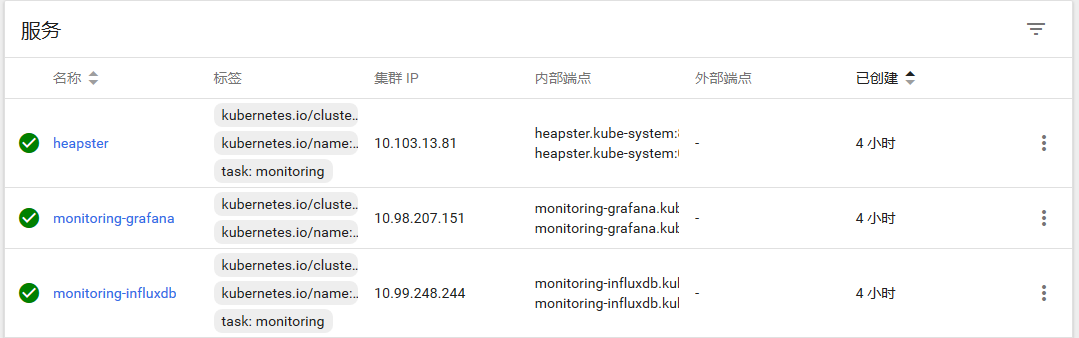
整个监控方案部署成功后,从上图可以看到,在不同粒度/维度下,dashboard上可以呈现对象的具体CPU和内存使用率。
3.2、通过Grafana查看集群详情(cpu、memory、filesystem、network)
通过Grafana可以查看某个Node或Pod的所有资源使用率,包括集群节点、不同NameSpace下的单个Pod等,一部分截图如下所示:
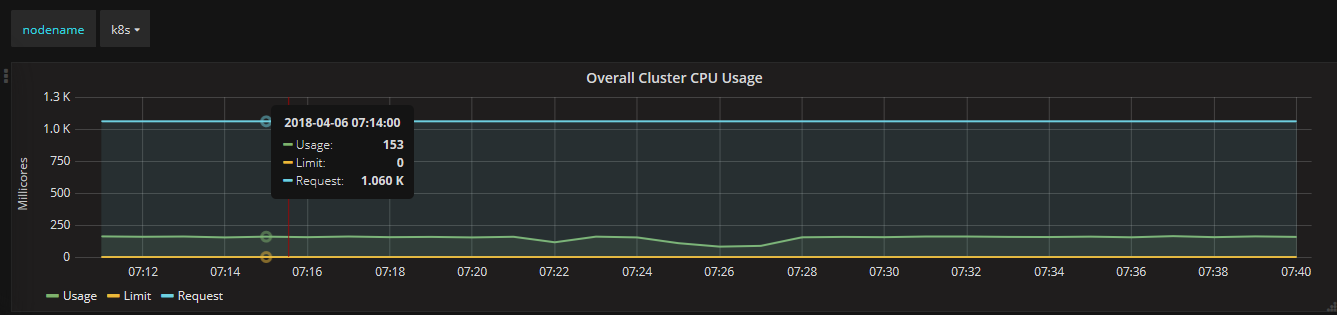
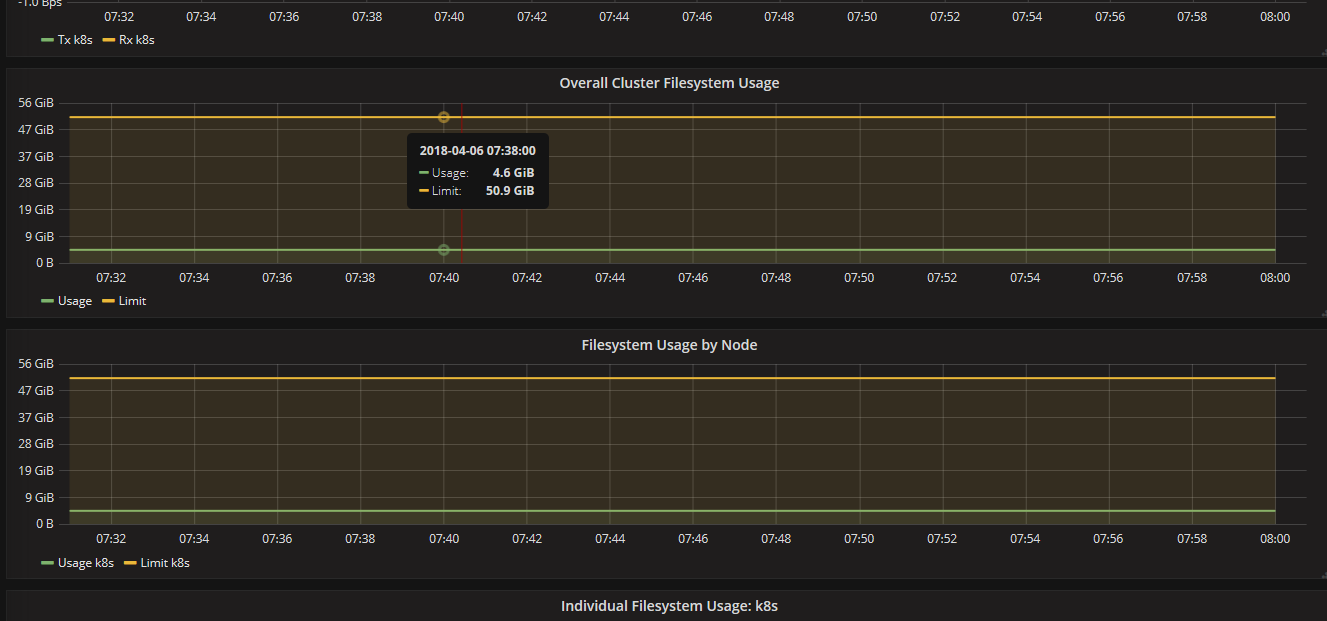
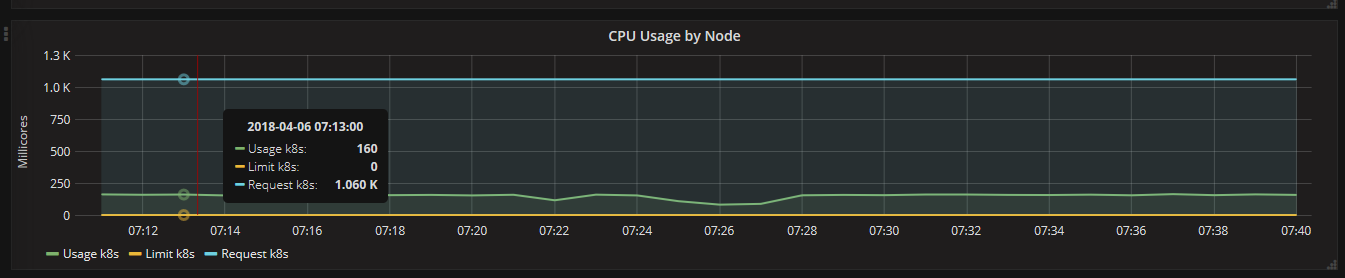
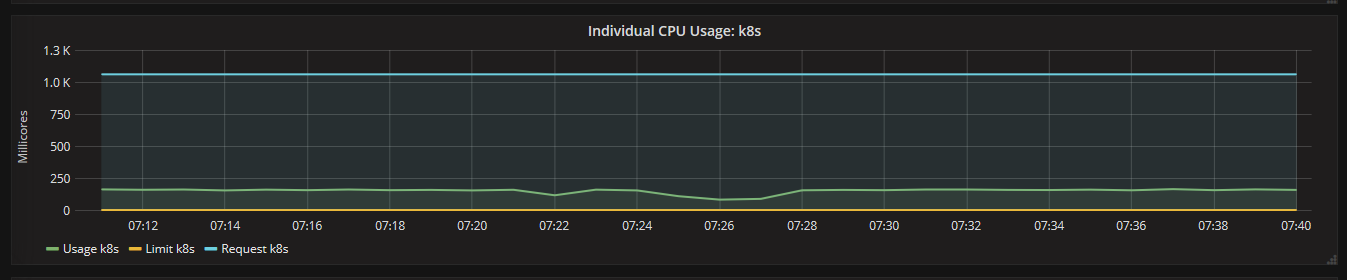
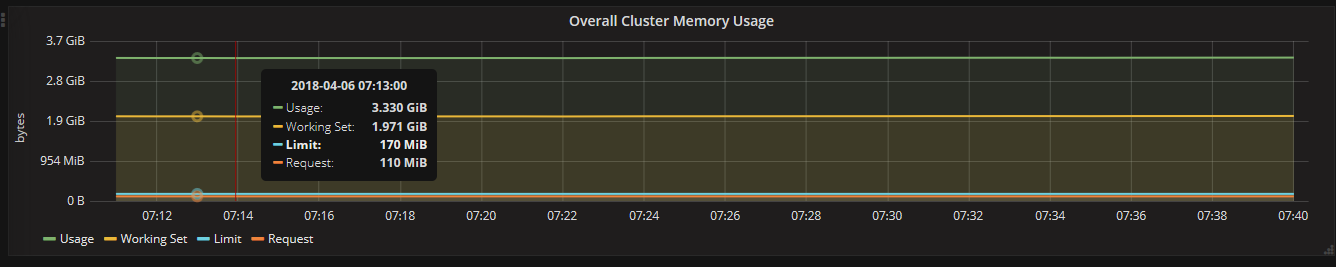
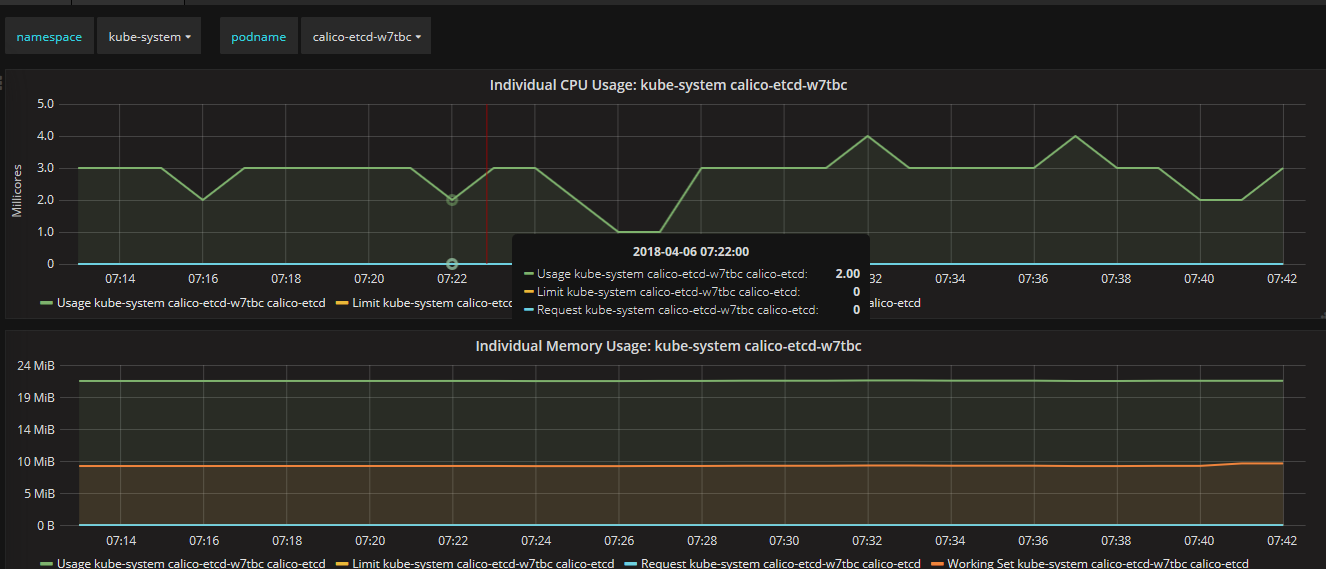
从上面可以看到,Heapster无缝衔接Grafana,提供了完美的数据展示,很直观、友好。我们也可以学习 Grafana 来自定制出更美观和满足特定业务需求的Dashboard。
4、总结
本篇我们详解了k8s原生的监控方案,它主要监控的是pod和node,对于kubernetes其他组件(API Server、Scheduler、Controller Manager等)的监控显得力不从心,而prometheus(一套开源的监控&报警&时间序列数据库的组合)功能更全面,后面有时间会进行实战。监控是一个非常大的话题,监控的目的是为预警,预警的目的是为了指导系统自愈。只有把 监控=》预警 =》自愈 三个环节都完成了,实现自动对应用程序性能和故障管理,才算得上是一个真正意义的应用程序性能管理系统(APM),所以这个系列会一直朝着这个目标努力下去,请大家继续关注。如果有什么好的想法,欢迎评论区交流。
延伸阅读
https://github.com/kubernetes/heapster
如果你觉得本篇文章对您有帮助的话,感谢您的【推荐】。
如果你对 kubernets 感兴趣的话可以关注我,我会定期的在博客分享我的学习心得。
详解k8s一个完整的监控方案(Heapster+Grafana+InfluxDB) - kubernetes的更多相关文章
- QuartusII13.0使用教程详解(一个完整的工程建立)
好久都没有发布自己的博客了,因为最近学校有比赛,从参加到现在都是一脸懵逼,幸亏有bingo大神的教程,让我慢慢走上了VIP之旅,bingo大神的无私奉献精神值得我们每一个业界人士学习,向bingo致敬 ...
- Kubernetes监控:部署Heapster、InfluxDB和Grafana
本节内容: Kubernetes 监控方案 Heapster.InfluxDB和Grafana介绍 安装配置Heapster.InfluxDB和Grafana 访问 grafana 访问 influx ...
- 详解k8s原生的集群监控方案(Heapster+InfluxDB+Grafana) - kubernetes
1.浅析监控方案 heapster是一个监控计算.存储.网络等集群资源的工具,以k8s内置的cAdvisor作为数据源收集集群信息,并汇总出有价值的性能数据(Metrics):cpu.内存.netwo ...
- (4)top详解 (每周一个linux命令系列)
(4)top详解 (每周一个linux命令系列) linux命令 top详解 引言:今天的命令是用来看cpu信息的top top 我们先看man top top - display Linux pro ...
- 企业sudo权限规划详解 (实测一个堆命令搞定)
简述问题: 随着公司的服务器越来越多,人员流动性也开始与日俱增,以往管理服务器的陈旧思想应当摒弃,公司需要有 更好更完善的权限体系,经过多轮沟通和协商,公司一致决定重新整理规划权限体系 ...
- (5)ps详解 (每周一个linux命令系列)
(5)ps详解 (每周一个linux命令系列) linux命令 ps详解 引言:今天的命令是用来看进程状态的ps命令 ps 我们先看man ps ps - report a snapshot of t ...
- (3)lscpu详解 (每周一个linux命令系列)
(3)lscpu详解 (每周一个linux命令系列) linux命令 lscpu详解 引言:今天的命令是用来看cpu信息的lscpu lscpu 我们先看man lscpu display infor ...
- (2)free详解 (每周一个linux命令系列)
(2)free详解 (每周一个linux命令系列) linux命令 free详解 引言:今天的命令是用来看内存的free free 换一个套路,我们先看man free中对free的描述: Displ ...
- 详解k8s零停机滚动发布微服务 - kubernetes
1.前言 在当下微服务架构盛行的时代,用户希望应用程序时时刻刻都是可用,为了满足不断变化的新业务,需要不断升级更新应用程序,有时可能需要频繁的发布版本.实现"零停机"." ...
随机推荐
- 【经验随笔】Java通过代理访问互联网平台提供的WebService接口的一种方法
背景 通常有两点原因需要通过代理访问互联网平台的提供的WebService接口: 1. 在公司企业内网访问外部互联网平台发布的接口,公司要求通过代理访问外网. 2. 频繁访问平台接口,IP被平台封了, ...
- c# 使用EnyimMemcached 连接memcache
首先nuget安装EnyimMemcached,本地启动memcache,往app.config(mvc项目则是web.config)加入以下内容: configSection内加入: <sec ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 防反编译的加壳工具-Virbox Protector
通过Virbox Protector可快速对您的软件进行加壳,可防调试,防挂钩,防反编译. 首先,你要有一个云平台(www.sense.com.cn)的帐号,登录后,只需将你的dll或者exe拖入到加 ...
- nginx location匹配顺序及CI框架的nginx配置
Nginx location匹配顺序如下: 用前缀字符串定义的location规则对URI进行匹配测试. =号定义了精确的前缀字符串匹配,如果发现精确匹配则使用当前规则.否则继续下一步匹配. 匹配其它 ...
- Java后台模拟发送http的get和post请求,并测试
个人学习使用:谨慎参考 1 Client类 import com.thoughtworks.gauge.Step; import com.thoughtworks.gauge.Table; impor ...
- 框架开发之——AngularJS+MVC+Routing开发步骤总结——5.14
1.延续MVC的观念:包括路由映射的编写,Controller的内容,具体View页面js的分离. 2.结合AngularJS做前端,后端使用Node.Js的写法,引入MVC框架,进行快速的开发. 步 ...
- 【Django】 rest-framework和RestfulAPI的设计
[rest-framework] 这是一个基于django才能发挥作用的组件,专门用于构造API的. 说到API,之前在其他项目中我也做过一些小API,不过那些都是玩票性质,结构十分简单而且要求的设计 ...
- 设计模式 --> (17)状态模式
状态模式 允许一个对象在其内部状态改变时改变它的行为.对象看起来似乎修改了它的类.它有两种使用情况: (1)一个对象的行为取决于它的状态, 并且它必须在运行时刻根据状态改变它的行为. (2)一个操作中 ...
- KVM之七:KVM克隆
1.在克隆虚拟机之前,必须先暂停或者停掉kvm 虚拟机.以虚拟机 snale 为例,先暂停虚拟机,如下 [root@kvm ~ ::]#virsh list Id 名称 状态 ------------ ...