
用python爬取豆瓣电影Top 250
首先,打开豆瓣电影Top 250,然后进行网页分析。找到它的Host和User-agent,并保存下来。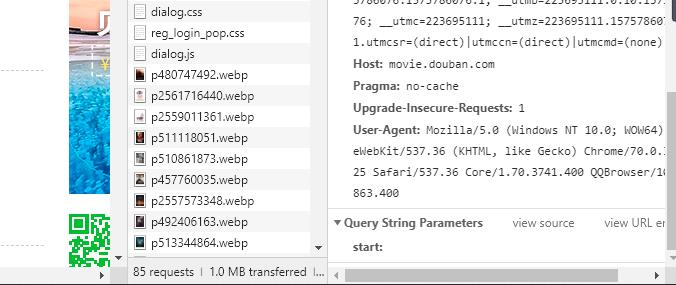 然后,我们通过翻页,查看各页面的url,发现规律:
第一页:https://movie.douban.com/top250?start=0&filter=
第二页:https://movie.douban.com/top250?start=25&filter=
第三页:https://movie.douban.com/top250?start=50&filter=
第四页:https://movie.douban.com/top250?start=75&filter=
我们发现,每个页面的url都是https://movie.douban.com/top250?start= +25+ &filter=的规律。如此,就可以开始写代码:
import requests

from bs4 import BeautifulSoup

def get_movie():

    headers={

        'Host': 'movie.douban.com',

        'User-Agent': 'Mozilla / 5.0(Windows NT 6.1;WOW64) AppleWebKit / 537.36(KHTML, likeGecko) Chrome / 45.0.2454.101Safari / 537.36'

    } #防止反扒措施

    movie_list=[]

    for i in range(10):

        url='https://movie.douban.com/top250?start='+str(i*25) #各页面url

        response=requests.get(url,headers=headers,timeout=10)

        soup=BeautifulSoup(response.text,'lxml')

        div_list=soup.find_all('div',class_='hd')

        for each in div_list:

            movie=each.a.span.text.strip()

            movie_list.append(movie)

    for j in movie_list:

        print(j) #按格式输出电影名称

get_movie()
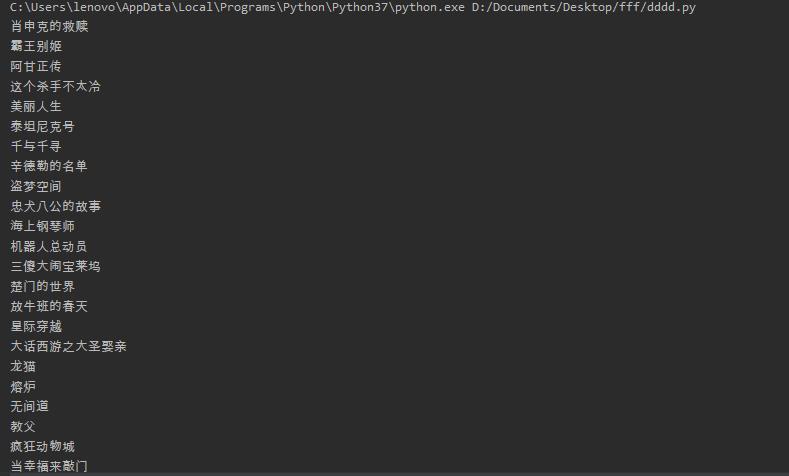
下面给出运行结果:
用python爬取豆瓣电影Top 250的更多相关文章
- 爬取豆瓣电影TOP 250的电影存储到mongodb中
爬取豆瓣电影TOP 250的电影存储到mongodb中 1.创建项目sp1 PS D:\scrapy> scrapy.exe startproject douban 2.创建一个爬虫 PS D: ...
- Python爬取豆瓣电影top
Python爬取豆瓣电影top250 下面以四种方法去解析数据,前面三种以插件库来解析,第四种以正则表达式去解析. xpath pyquery beaufifulsoup re 爬取信息:名称 评分 ...
- Python开发爬虫之静态网页抓取篇:爬取“豆瓣电影 Top 250”电影数据
所谓静态页面是指纯粹的HTML格式的页面,这样的页面在浏览器中展示的内容都在HTML源码中. 目标:爬取豆瓣电影TOP250的所有电影名称,网址为:https://movie.douban.com/t ...
- 爬虫——正则表达式爬取豆瓣电影TOP前250的中英文名
正则表达式爬取豆瓣电影TOP前250的中英文名 1.首先要实现网页的数据的爬取.新建test.py文件 test.py 1 import requests 2 3 def get_Html_text( ...
- 爬虫系列1:Requests+Xpath 爬取豆瓣电影TOP
爬虫1:Requests+Xpath 爬取豆瓣电影TOP [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]: ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
- python 爬取豆瓣电影评论,并进行词云展示及出现的问题解决办法
本文旨在提供爬取豆瓣电影<我不是药神>评论和词云展示的代码样例 1.分析URL 2.爬取前10页评论 3.进行词云展示 1.分析URL 我不是药神 短评 第一页url https://mo ...
- python爬取豆瓣电影信息数据
题外话+ 大家好啊,最近自己在做一个属于自己的博客网站(准备辞职回家养老了,明年再战)在家里 琐事也很多, 加上自己 一回到家就懒了(主要是家里冷啊! 广东十几度,老家几度,躲在被窝瑟瑟发抖,) 由于 ...
- python 爬取豆瓣电影短评并wordcloud生成词云图
最近学到数据可视化到了词云图,正好学到爬虫,各种爬网站 [实验名称] 爬取豆瓣电影<千与千寻>的评论并生成词云 1. 利用爬虫获得电影评论的文本数据 2. 处理文本数据生成词云图 第一步, ...
随机推荐
- PHP curl put方式上传文件
发送端: <?php function curlPut($destUrl, $sourceFileDir, $headerArr = array(), $timeout = ) { $ch = ...
- python清理docker-harbor的多余镜像
# coding: utf-8 from operator import itemgetter from urllib import parse import requests import date ...
- ZingChart 隐藏数据点
正常情况下 zingChart 的数据点会显示到图表中,但是如果数据点很多的情况下,可能会让你无法准确的预测趋势,而且也不美观 在 js 配置中添加最多允许显示的数据点,超过这个值将不显示数据点 效果 ...
- netty5心跳与阻塞性业务消息分发实例
继续之前的例子(netty5心跳与业务消息分发实例),我们在NettyClientHandler把业务消息改为阻塞性的: package com.wlf.netty.nettyclient.handl ...
- dubbo+zookeeper+springboot简单示例
目录 dubbo+zookeeper+springboot简单示例 zookeeper安装使用 api子模块 生产者producer 消费者consumer @(目录) dubbo+zookeeper ...
- LODOP中设置设置图片平铺水印,超文本透明
之前的博文:LODOP中平铺图片 文本项Repeat. 该博文中是平铺的图片,上面是文本.如果是图片add_print_image和add_print_text纯文本,这两个打印项设计的,可以直接通过 ...
- 【Leetcode_easy】933. Number of Recent Calls
problem 933. Number of Recent Calls 参考 1. Leetcode_easy_933. Number of Recent Calls; 完
- CSS网站框架及样式命名规范
CSS网站框架 复位:reset.css 基础:base.css 或 basic.css (字体大小.颜色.背景.行高.列表样式.按钮样式.表格样式等等) 布局:layout.css (非结构的布局) ...
- windows下 pip下载包到指定目录
pip download -r requirements.txt -d G:\PythonVirtualenv\packages python setup.py install
- bootstrap-table和bootstrap-switch
{% load staticfiles %} <!DOCTYPE html> <html lang="en"> <head> <meta ...