
Hadoop spark mongo复制集
启动hadoop

cd /usr/local/hadoop/hadoop

$hadoop namenode -format			# 启动前格式化namenode

$./sbin/start-all.sh

检查是否启动成功

[hadoop@hadoop1 hadoop]$ jps

16855 NodeManager

16999 Jps

16090 NameNode

16570 ResourceManager

16396 SecondaryNameNode

[hadoop@hadoop1 hadoop]$

/usr/local/hadoop/hadoop

[hadoop@hadoop2 hadoop]$ jps

1378 NodeManager

1239 DataNode

1528 Jps

[hadoop@hadoop2 hadoop]$

停止

$./sbin/stop-all.sh

启动spark

cd /usr/local/hadoop/spark/

./sbin/start-all.sh

检查是否启动成功

[hadoop@hadoop1 spark]$ jps

16855 NodeManager

17223 Master

17447 Jps

17369 Worker

16090 NameNode

16570 ResourceManager

16396 SecondaryNameNode

[hadoop@hadoop1 spark]$

[hadoop@hadoop2 spark]$ jps

1378 NodeManager

1239 DataNode

2280 Worker

2382 Jps

[hadoop@hadoop2 spark]$

停止

$./sbin/stop-all.sh
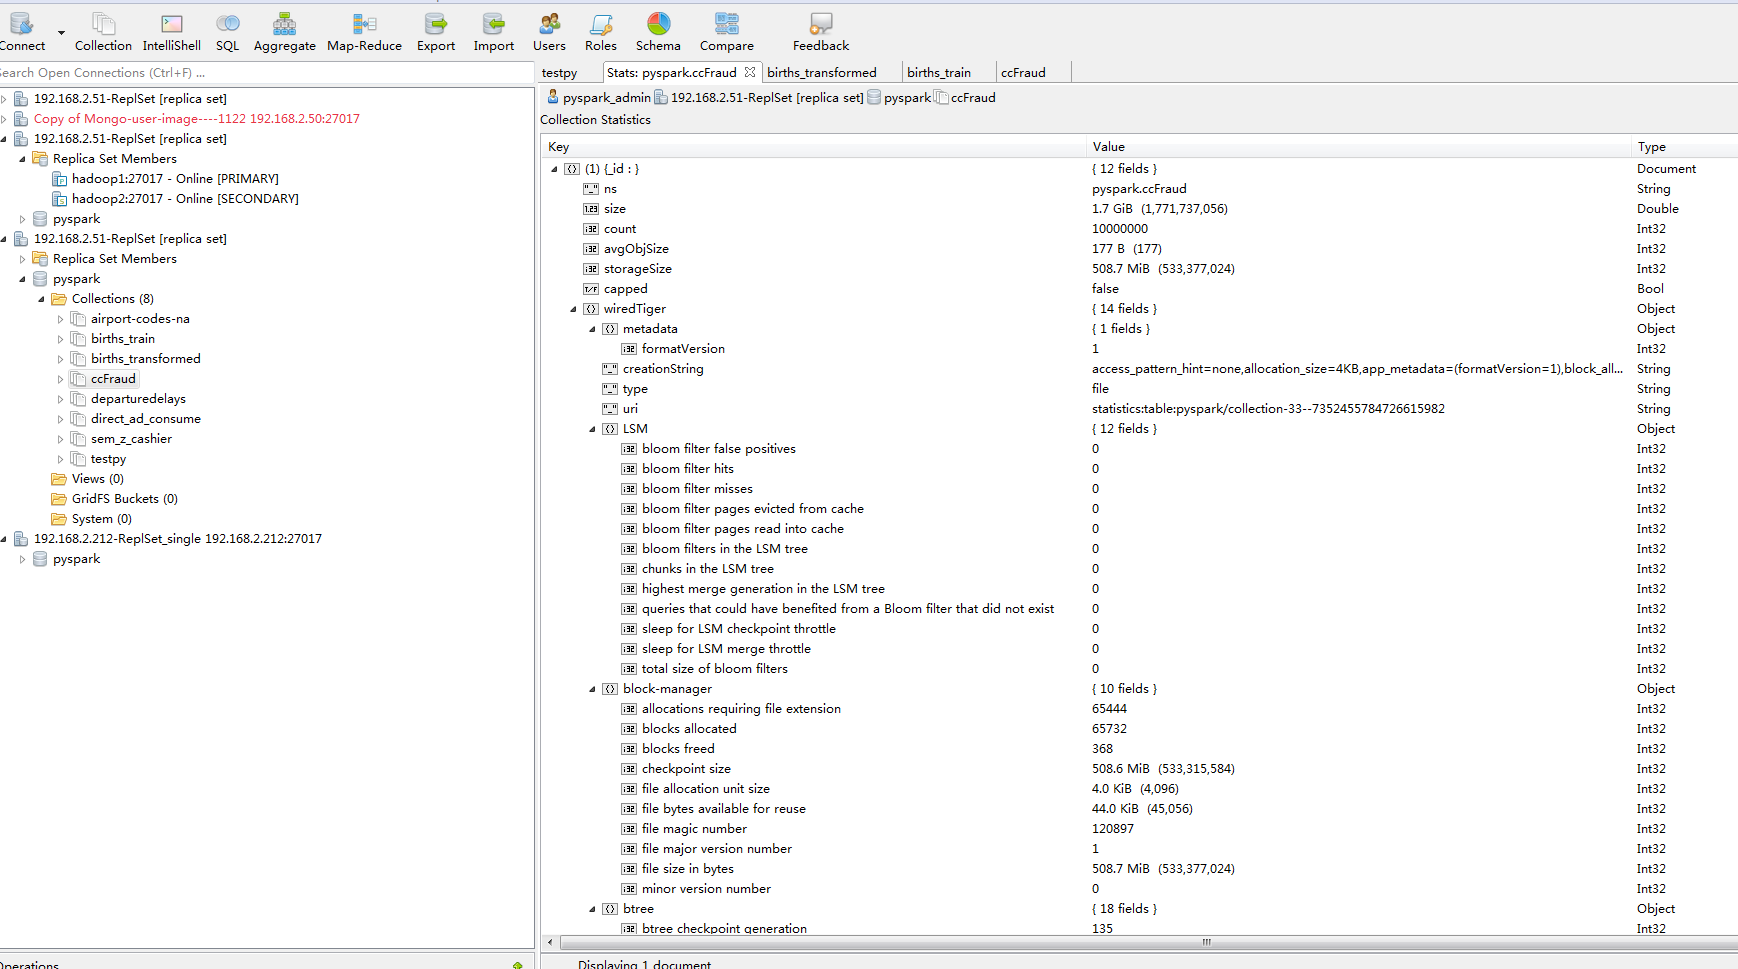
pyspark_mongo复制集_hdfs_hbase

启动mongo复制集

[

/usr/local/mongodb/安装后,初始化

    mkdir -p /mnt/mongodb_data/{data,log};

    mkdir conf/;

    vim /usr/local/mongodb/conf/mongod.conf;

     [

       mv /mnt/mongodb_data/data /mnt/mongodb_data/data$(date +"%Y%m%d_%H%I%S");  mkdir /mnt/mongodb_data/data;

     ]

    ``

bind_ip=0.0.0.0

port=

dbpath=/mnt/mongodb_data/data

logpath=/mnt/mongodb_data/log/mongod.log

pidfilepath=/usr/local/mongodb/mongo.pid

fork=true

logappend=true

    scp /usr/local/mongodb/conf/mongod.conf root@hadoop2:/usr/local/mongodb/conf/;

    启动服务

    /usr/local/mongodb/bin/mongod -f /usr/local/mongodb/conf/mongod.conf

    进入读写窗设置admin账号

    /usr/local/mongodb/bin/mongo

use admin;

db.createUser(

  {

    user: "admin",

    pwd: "admin123",

    roles: [ { role: "userAdminAnyDatabase", db: "admin" } ,"clusterAdmin"]

  }

);

    检验是否添加成功

    db.getUsers()

    关闭服务mongod

    db.shutdownServer()

    退出mongo

    exit

    对配置文件加入ip限制和复制集配置

    vim /usr/local/mongodb/conf/mongod.conf;

replSet=repl_test

keyFile=/usr/local/mongodb/conf/keyFile

shardsvr=true

directoryperdb=true

    /usr/local/mongodb/bin/mongod -f /usr/local/mongodb/conf/mongod.conf

    进入任一节点mongo窗,进入读写

    /usr/local/mongodb/bin/mongo

    use admin;

    db.auth("admin","admin123");

    设置复制集

    rs.status();

    rs.();

    rs.status();

    rs.add("hadoop2:27017");

    rs.status();

    复制集无误后,库表、角色、用户设计;

    use pyspark;

    db.createUser(

   {

         user: "pyspark_admin",

         pwd: "admin123",

        roles: [ "readWrite", "dbAdmin" ]

       }

    );

    db.getRoles();

    db.getUsers();

    db.auth("pyspark_admin","admin123");

    show collections;

    db.createCollection('direct_ad_consume');

    db.createCollection('sem_z_cashier');

    show collections;

    db.createCollection('testpy');

    db.createCollection('departuredelays');

    db.createCollection('airport-codes-na');

    db.createCollection('ccFraud');

    db.sem_z_cashier.drop();

]

spark数据源;

单个大文件hdfs、hbase

序列化文件mongo复制集,可以考虑spark-mongo组件

执行spark

cd /usr/local/hadoop/

启动hadoop

cd /usr/local/hadoop/hadoop

$hadoop namenode -format            # 启动前格式化namenode

$./sbin/start-all.sh

检查是否启动成功

[hadoop@hadoop1 hadoop]$ jps

 NodeManager

 Jps

 NameNode

 ResourceManager

 SecondaryNameNode

[hadoop@hadoop1 hadoop]$

/usr/local/hadoop/hadoop

[hadoop@hadoop2 hadoop]$ jps

 NodeManager

 DataNode

 Jps

[hadoop@hadoop2 hadoop]$

停止

$./sbin/stop-all.sh

启动spark

cd /usr/local/hadoop/spark/

./sbin/start-all.sh

检查是否启动成功

[hadoop@hadoop1 spark]$ jps

 NodeManager

 Master

 Jps

 Worker

 NameNode

 ResourceManager

 SecondaryNameNode

[hadoop@hadoop1 spark]$

[hadoop@hadoop2 spark]$ jps

 NodeManager

 DataNode

 Worker

 Jps

[hadoop@hadoop2 spark]$

停止

$./sbin/stop-all.sh
Hadoop spark mongo复制集的更多相关文章
- mongo复制集脑裂问题如何处理
mongo replication 脑裂问题如何处理: 一.问题描述:一套mongo replication有4个节点.1个仲裁节点.在停止实例(或实例毁坏)的时候,导致所有节点都变为SECONDAR ...
- mongo 复制集命令
1.登录primary2.use admin >rs.add("new_node:port") 或 rs.add({"_id":4,"host& ...
- mongo复制集、分片集(亲测)
1.1 架构思路: 192.168.50.131 192.168.50.131 192.168.50.132 mongos mongos mongos ...
- 单机Mongo复制集安装配置(数据库版本:4.x)
官方文档: https://docs.mongodb.com/manual/tutorial/deploy-replica-set-with-keyfile-access-control/#dep ...
- hadoop - spark on yarn 集群搭建
一.环境准备 1. 机器: 3 台虚拟机 机器 角色 l-qta3.sp.beta.cn0 NameNode,ResourceManager,spark的master l-querydiff1.sp ...
- 工作中Hadoop,Spark,Phoenix,Impala 集群中遇到坑及解决方案
1.HDFS 修复 问题描述:其他部门在yarn平台上跑spark 程序错误的生成了海量的不到100K的小文件,导致namenode压力过大,其中一个namenode宕机后,没有及时发现 使得edit ...
- MongoDB复制集搭建(3.4.17版)
==版本== mongodb-linux-x86_64-rhel70-3.4.17.tgz ==准备== 3个节点,我这里的IP及hostname分别是: 10.11.2.52 dscn49 10.1 ...
- docker添加mongo4.0.3并配置复制集
1.创建docker 具体略过 自行百度 2.创建数据持久化目录文件(/data/mongo0是个例子 命名随意) 拉取mongo docker pull mongo:4.0.3 3.启动容器 do ...
- Hadoop+Spark:集群环境搭建
环境准备: 在虚拟机下,大家三台Linux ubuntu 14.04 server x64 系统(下载地址:http://releases.ubuntu.com/14.04.2/ubuntu-14.0 ...
随机推荐
- 阿里 AndFix 热修复框架简介
阿里AndFix热修复框架简介 热修复原理: Android的类加载机制 Android的类加载器分为两种,PathClassLoader和DexClassLoader,两者都继承自BaseDexCl ...
- TeraTerm下载
参考:http://blog.csdn.net/gxp/article/details/9169319 官方主页: http://ttssh2.sourceforge.jp/ 官方下载: http:/ ...
- 【2018.12.10】NOI模拟赛3
题目 WZJ题解 大概就是全场就我写不过 $FFT$ 系列吧……自闭 T1 奶一口,下次再写不出这种 $NTT$ 裸题题目我就艹了自己 -_-||| 而且这跟我口胡的自创模拟题 $set1$ 的 $T ...
- Java面试通关要点
Java面试通关要点 2018-03-23 梁桂钊 占小狼的博客 占小狼的博客 占小狼的博客 微信号 whywhy_zj 功能介绍 Java进阶技术干货.实践分享,跟着狼哥一起学习JVM.性能调优,欢 ...
- 【bzoj2733】[HNOI2012]永无乡 线段树合并
Description 永无乡包含 n 座岛,编号从 1 到 n,每座岛都有自己的独一无二的重要度,按照重要度可 以将这 n 座岛排名,名次用 1 到 n 来表示.某些岛之间由巨大的桥连接,通过桥可以 ...
- Centos 安装Python3的方法
由于centos7原本就安装了Python2,而且这个Python2不能被删除,因为有很多系统命令,比如yum都要用到. [root@VM_105_217_centos Python-3.6.2]# ...
- Requests模拟登陆
requests模拟登陆知乎网站 实例 # -*- coding: utf-8 -*- __author__ = 'CQ' import requests try: import cookielib ...
- BZOJ 1090 字符串折叠(Hash + DP)
题目链接 字符串折叠 区间DP.$f[l][r]$为字符串在区间l到r的最小值 正常情况下 $f[l][r] = min(f[l][r], f[l][l+k-1]+f[l+k][r]);$ 当$l$到 ...
- 使用SmartQQ实现的智能回复(Web QQ协议)
采用SmartQQ SDK进行开发,官网:https://github.com/ScienJus/smartqq 此项目只是集成使用的方法,在com.jsoft.robot.SmartQQUse.Re ...
- Spring中Beans的自动装配概述
以下内容引用自http://wiki.jikexueyuan.com/project/spring/beans-autowiring.html: 在之前的做法上会参照这样的顺序:1.使用<bea ...