
Llama2-Chinese项目:1-项目介绍和模型推理
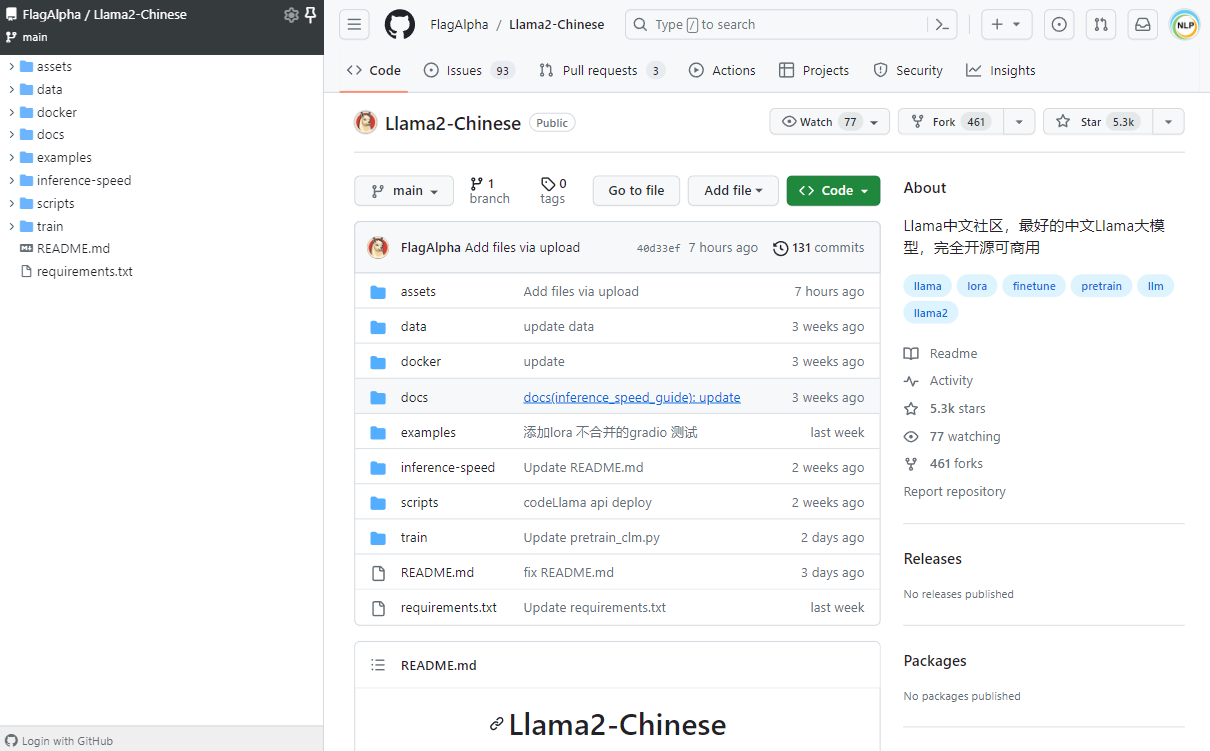
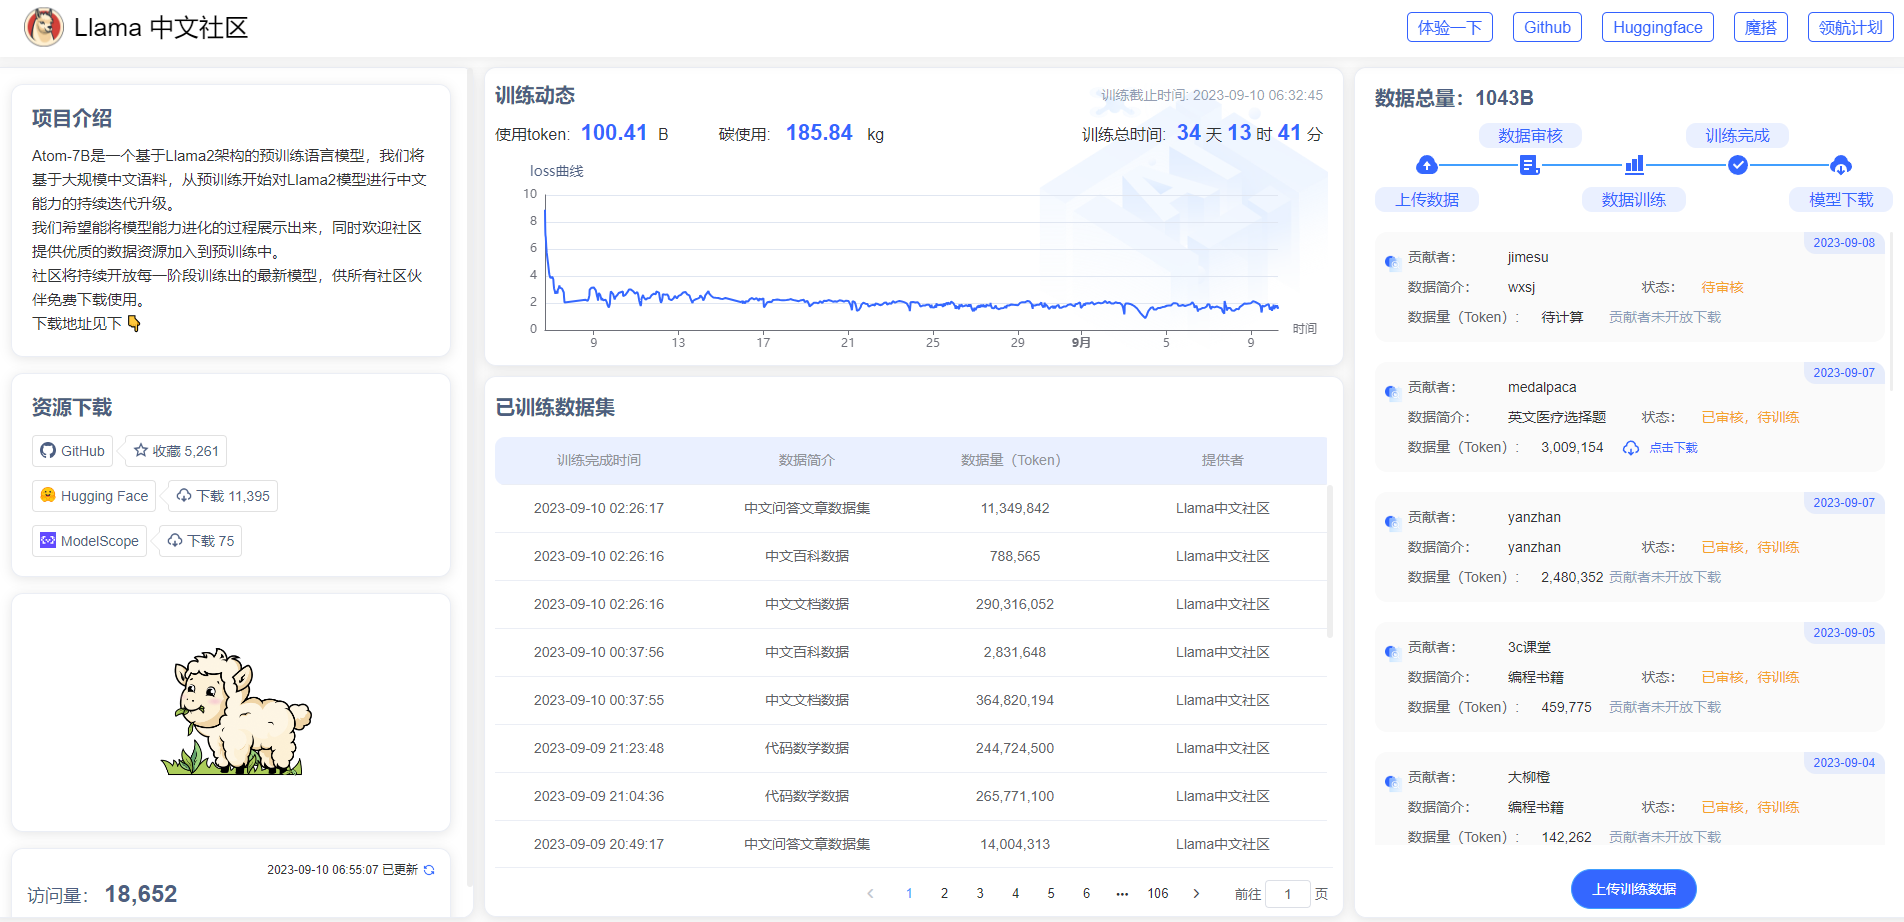
Atom-7B与Llama2间的关系:Atom-7B是基于Llama2进行中文预训练的开源大模型。为什么叫原子呢?因为原子生万物,Llama中文社区希望原子大模型未来可以成为构建AI世界的基础单位。目前社区发布了6个模型,如下所示:
FlagAlpha/Atom-7B
FlagAlpha/Llama2-Chinese-7b-Chat
FlagAlpha/Llama2-Chinese-7b-Chat-LoRA
FlagAlpha/Llama2-Chinese-13b-Chat
FlagAlpha/Llama2-Chinese-13b-Chat-LoRA
FlagAlpha/Llama2-Chinese-13b-Chat-4bit
一.Llama2-Chinese项目介绍
1.Llama相关论文
LLaMA: Open and Efficient Foundation Language Models
Llama 2: Open Foundation and Fine-Tuned Chat Models
Code Llama: Open Foundation Models for Code
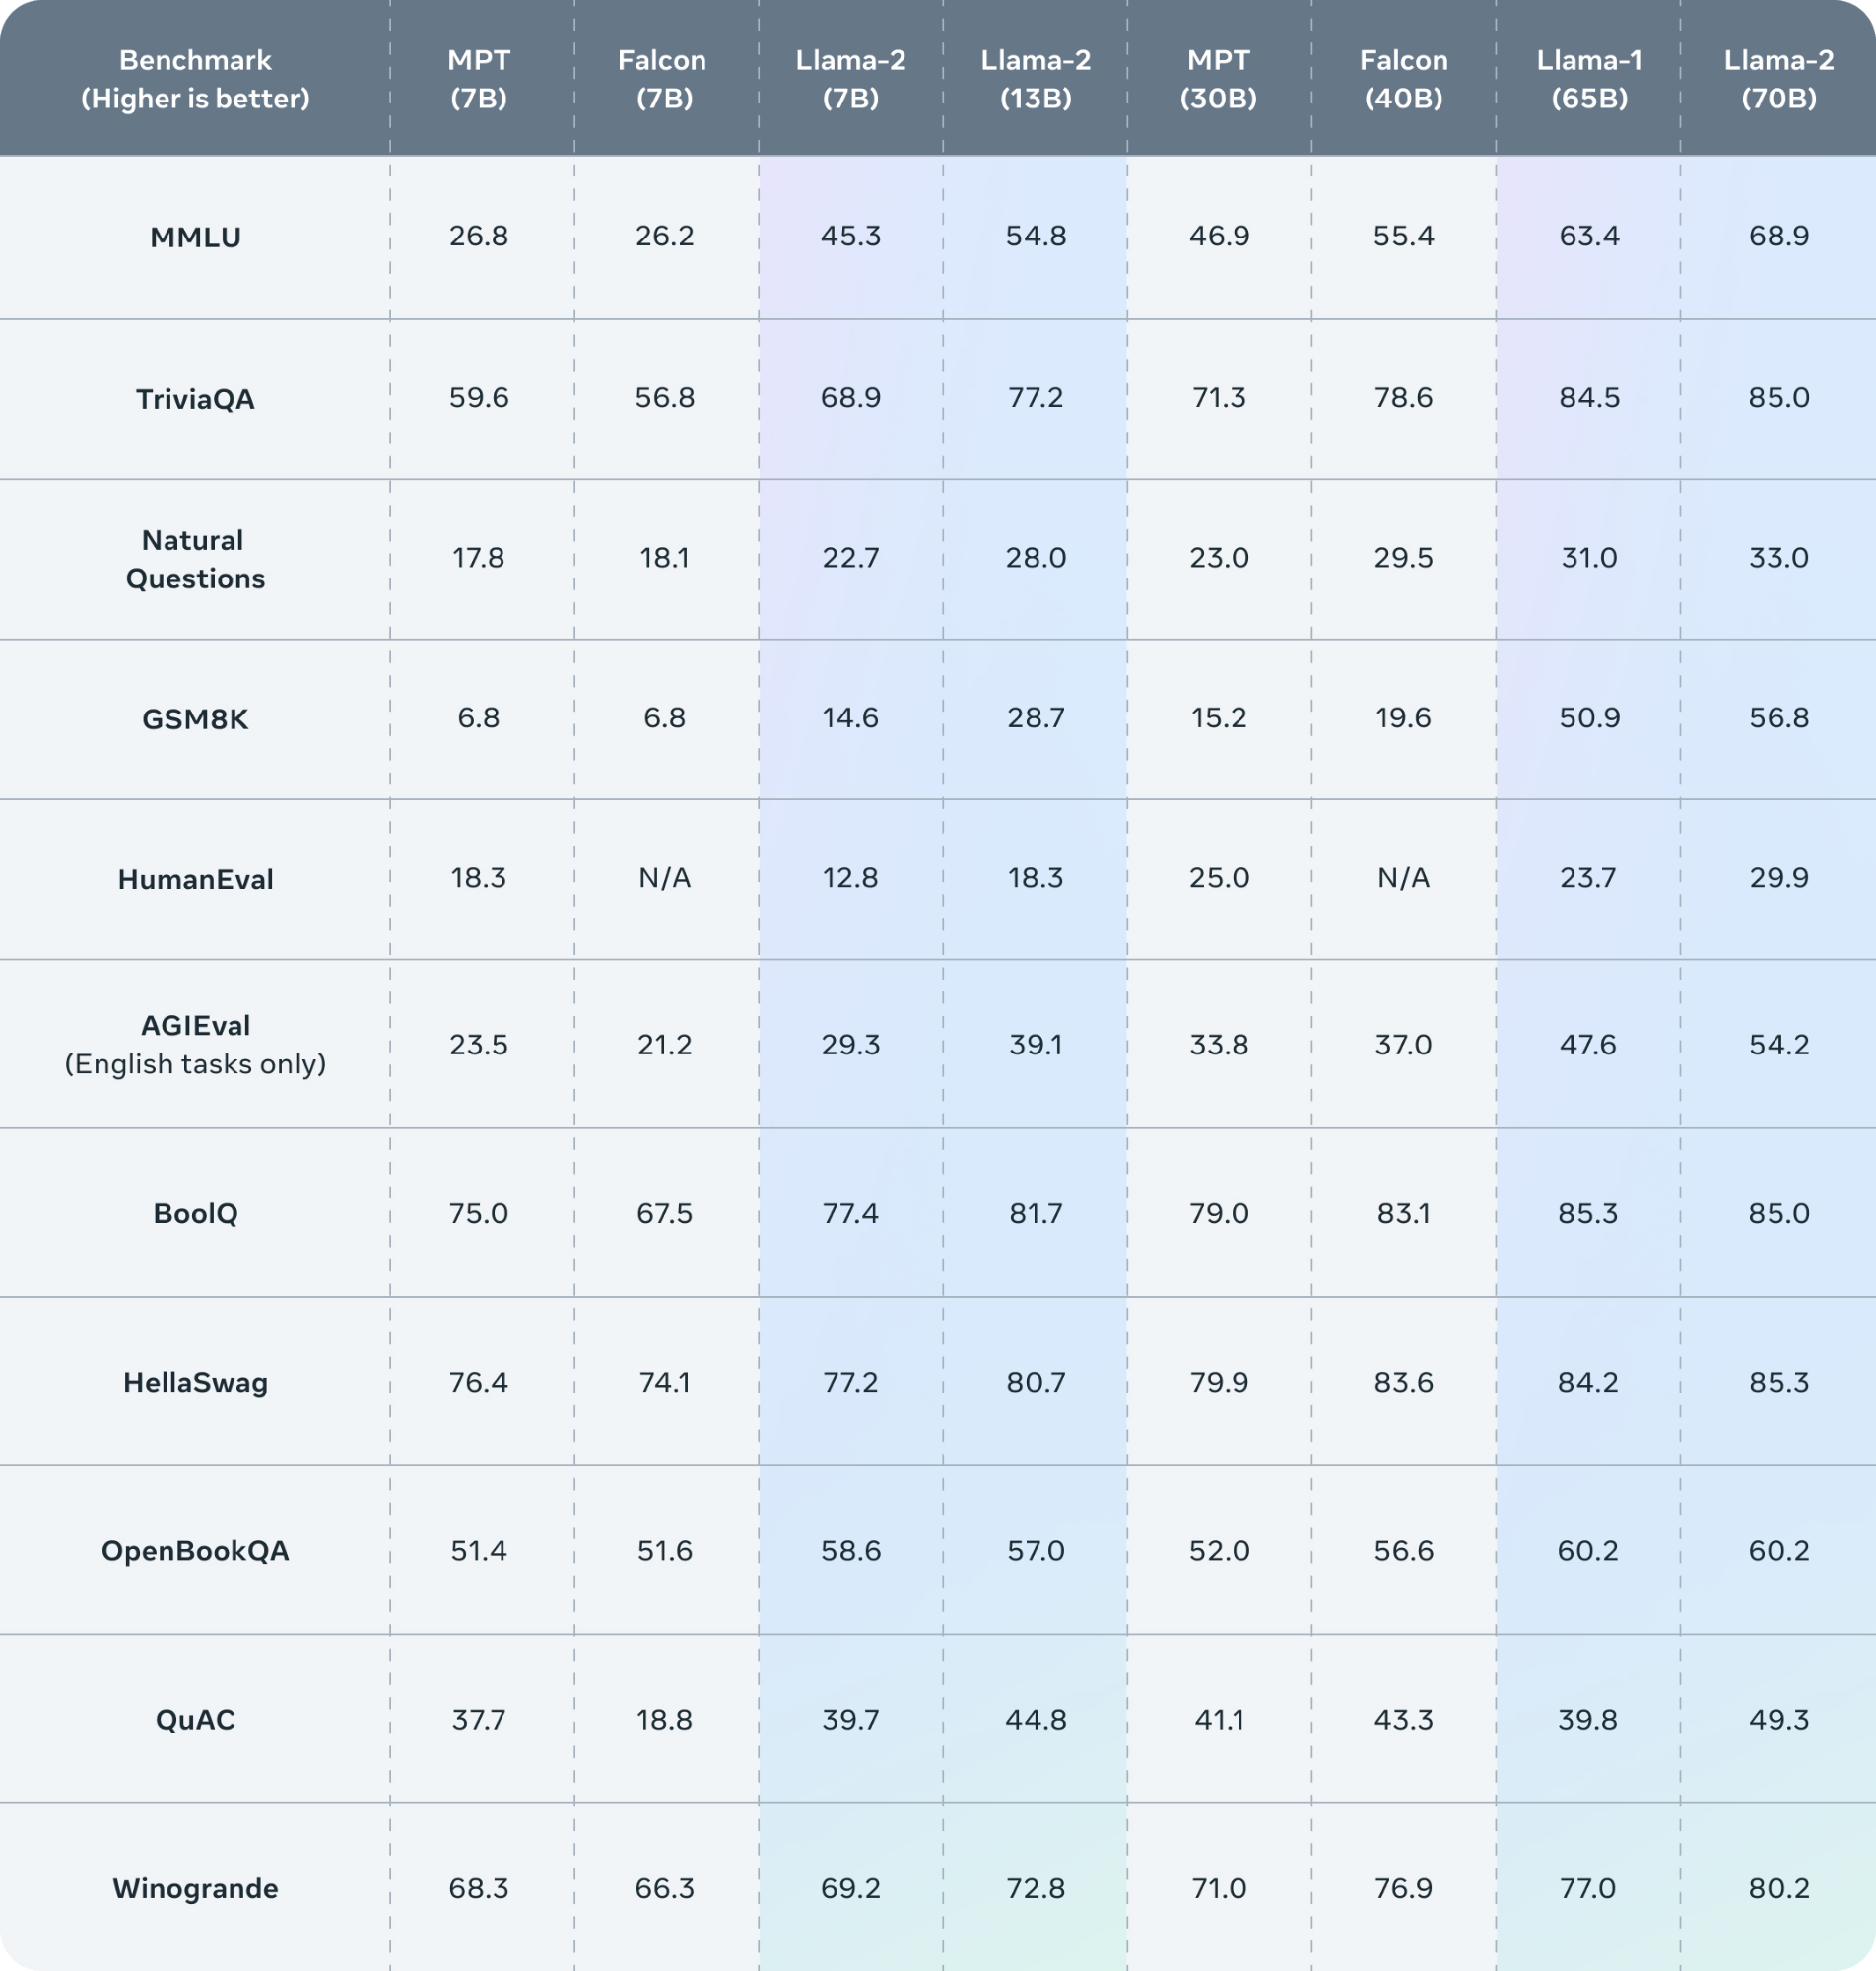
2.Llama2的评测结果
二.Atom-7B加载和推理
模型调用代码示例如下所示:
from transformers import AutoTokenizer, AutoModelForCausalLM
from pathlib import Path
import torch

pretrained_model_name_or_path = r'L:/20230903_Llama2/Atom-7B'
model = AutoModelForCausalLM.from_pretrained(Path(f'{pretrained_model_name_or_path}'), device_map='auto', torch_dtype=torch.float16, load_in_8bit=True) #加载模型
model = model.eval() #切换到eval模式
tokenizer = AutoTokenizer.from_pretrained(Path(f'{pretrained_model_name_or_path}'), use_fast=False) #加载tokenizer
tokenizer.pad_token = tokenizer.eos_token  #为了防止生成的文本出现[PAD],这里将[PAD]重置为[EOS]
input_ids = tokenizer(['<s>Human: 介绍一下中国\n</s><s>Assistant: '], return_tensors="pt", add_special_tokens=False).input_ids.to('cuda') #将输入的文本转换为token
generate_input = {
    "input_ids": input_ids, #输入的token
    "max_new_tokens": 512,  #最大生成的token数量
    "do_sample": True,      #是否采样
    "top_k": 50,            #采样的top_k
    "top_p": 0.95,          #采样的top_p
    "temperature": 0.3,     #采样的temperature
    "repetition_penalty": 1.3,               #重复惩罚
    "eos_token_id": tokenizer.eos_token_id,  #结束token
    "bos_token_id": tokenizer.bos_token_id,  #开始token
    "pad_token_id": tokenizer.pad_token_id   #pad token
}
generate_ids = model.generate(**generate_input) #生成token
text = tokenizer.decode(generate_ids[0]) #将token转换为文本
print(text) #输出生成的文本
三.相关知识点
1.Fire库
解析:Fire是一个Google开发的库,用于自动生成Python命令行接口(CLI)。它可以帮助开发人员快速将Python对象和函数暴露为命令行工具。使用Fire可以自动创建命令行参数,参数类型和默认值等。
2.Llama1和Llama2区别
解析:
(1)Llama2采用Llama1的大部分预训练设置和模型架构,它们使用标准的Transformer架构,应用RMSNorm进行预归一化,使用SwiGLU激活函数和旋转位置编码。与Llama1相比,主要的架构差异包括增加的上下文长度和分组查询注意力(GQA)。
(2)Llama2总共公布了7B、13B和70B三种参数大小的模型。相比于LLaMA,Llama2的训练数据达到了2万亿token,上下文长度也由之前的2048升级到4096,可以理解和生成更长的文本。Llama2Chat模型基于100万人类标记数据微调得到,在英文对话上达到了接近ChatGPT的效果。
四.相关问题
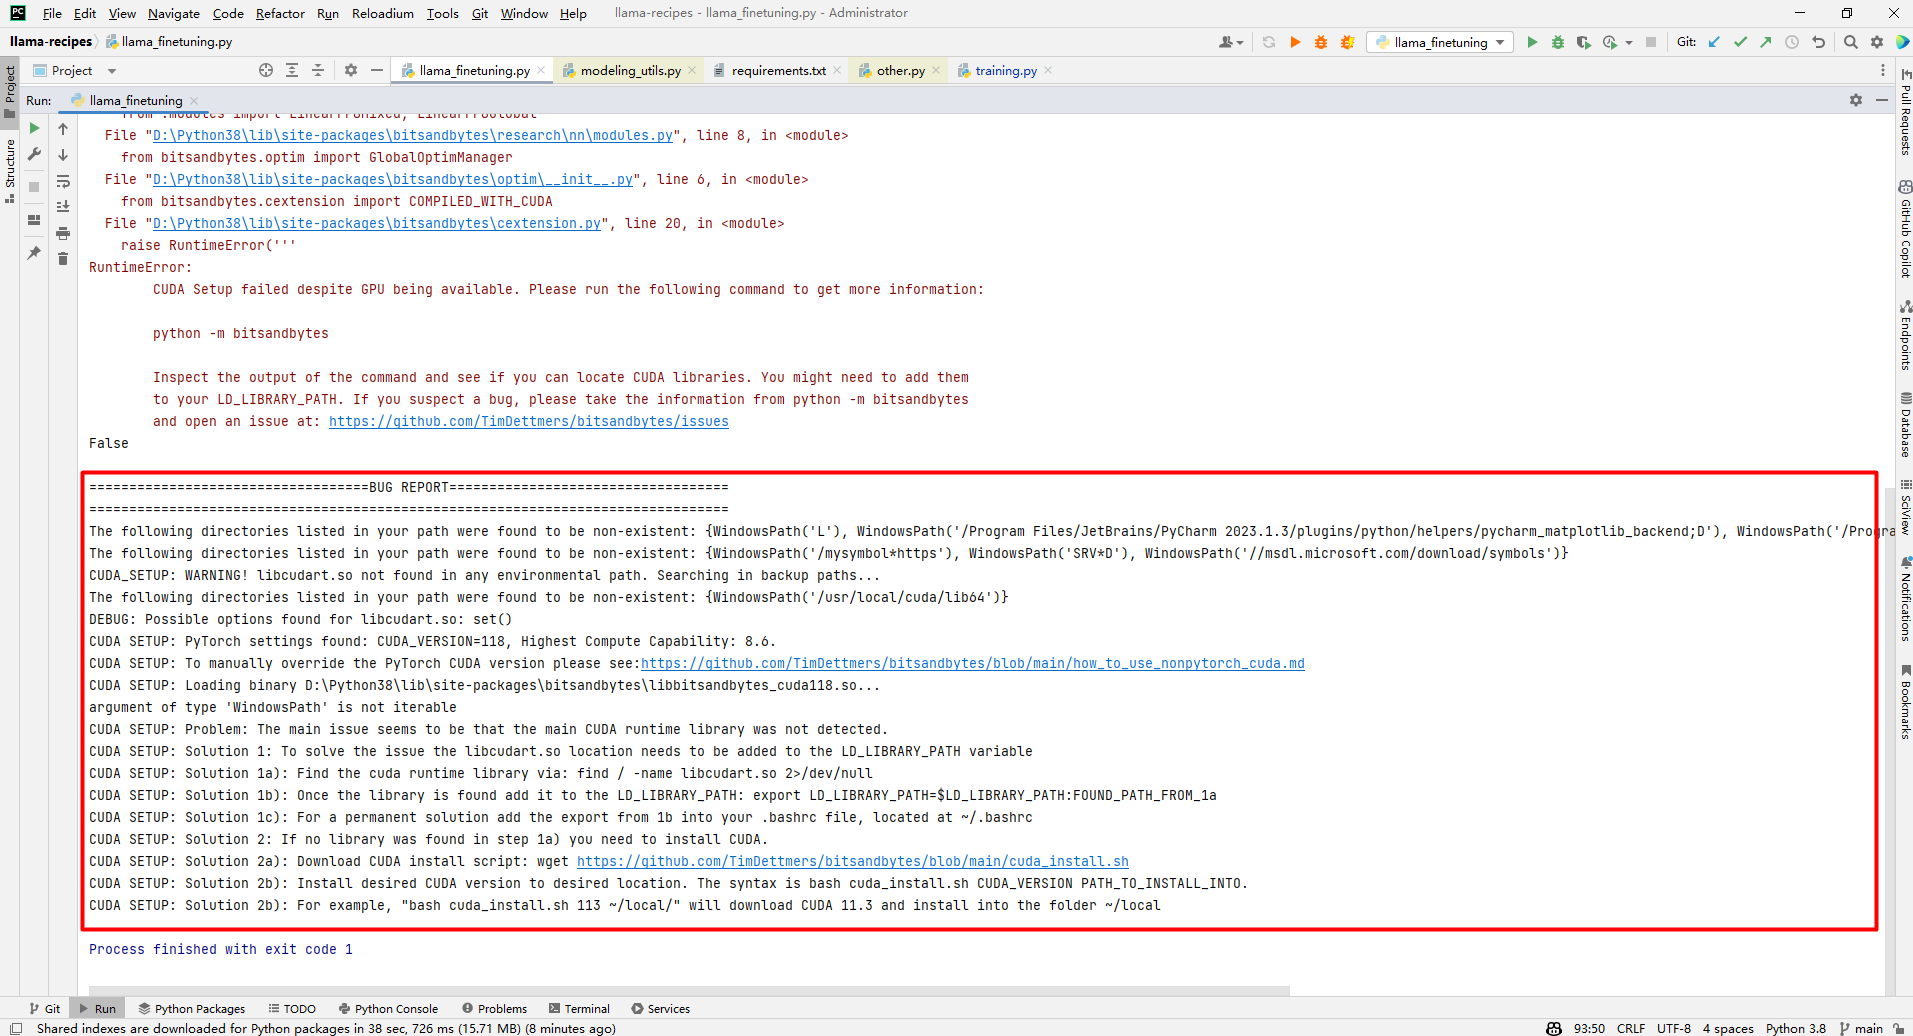
1.CUDA Setup failed despite GPU being available
解析:如下是网上介绍的解决方案,还有的建议源码编译,但是这2种方案都没有走通。
(1)安装路径
bitsandbytes路径(0.39.1):D:\Python38\Lib\site-packages\bitsandbytes CUDA路径(v12.1):C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.1\bin
将"CUDA路径(v12.1)"下的文件拷贝到"bitsandbytes路径(0.39.1)"目录下:
cudart64_12.dll
cublas64_12.dll
cublasLt64_12.dll
cusparse64_12.dll
nvJitLink_120_0.dll
实践经验建议方式[8]为pip3 install https://github.com/jllllll/bitsandbytes-windows-webui/blob/main/bitsandbytes-0.39.0-py3-none-any.whl。有图有证据如下所示:

(2)修改文件
D:\Python38\Lib\site-packages\bitsandbytes\cuda_setup\main.py
将 if not torch.cuda.is_available(): return 'libsbitsandbytes_cpu.so', None, None, None, None替换为if torch.cuda.is_available(): return 'libbitsandbytes_cuda116.dll', None, None, None, None将2个地方的 self.lib = ct.cdll.LoadLibrary(binary_path)替换为self.lib = ct.cdll.LoadLibrary(str(binary_path))
(3)添加libbitsandbytes_cuda116.dll和libbitsandbytes_cpu.dll
存放路径为D:\Python38\Lib\site-packages\bitsandbytes,下载地址参考[0]。
2.RuntimeError: cuDNN error: CUDNN_STATUS_NOT_INITIALIZED
解析:下载链接为[7],下载之前需要NVIDIA社区账号登录。
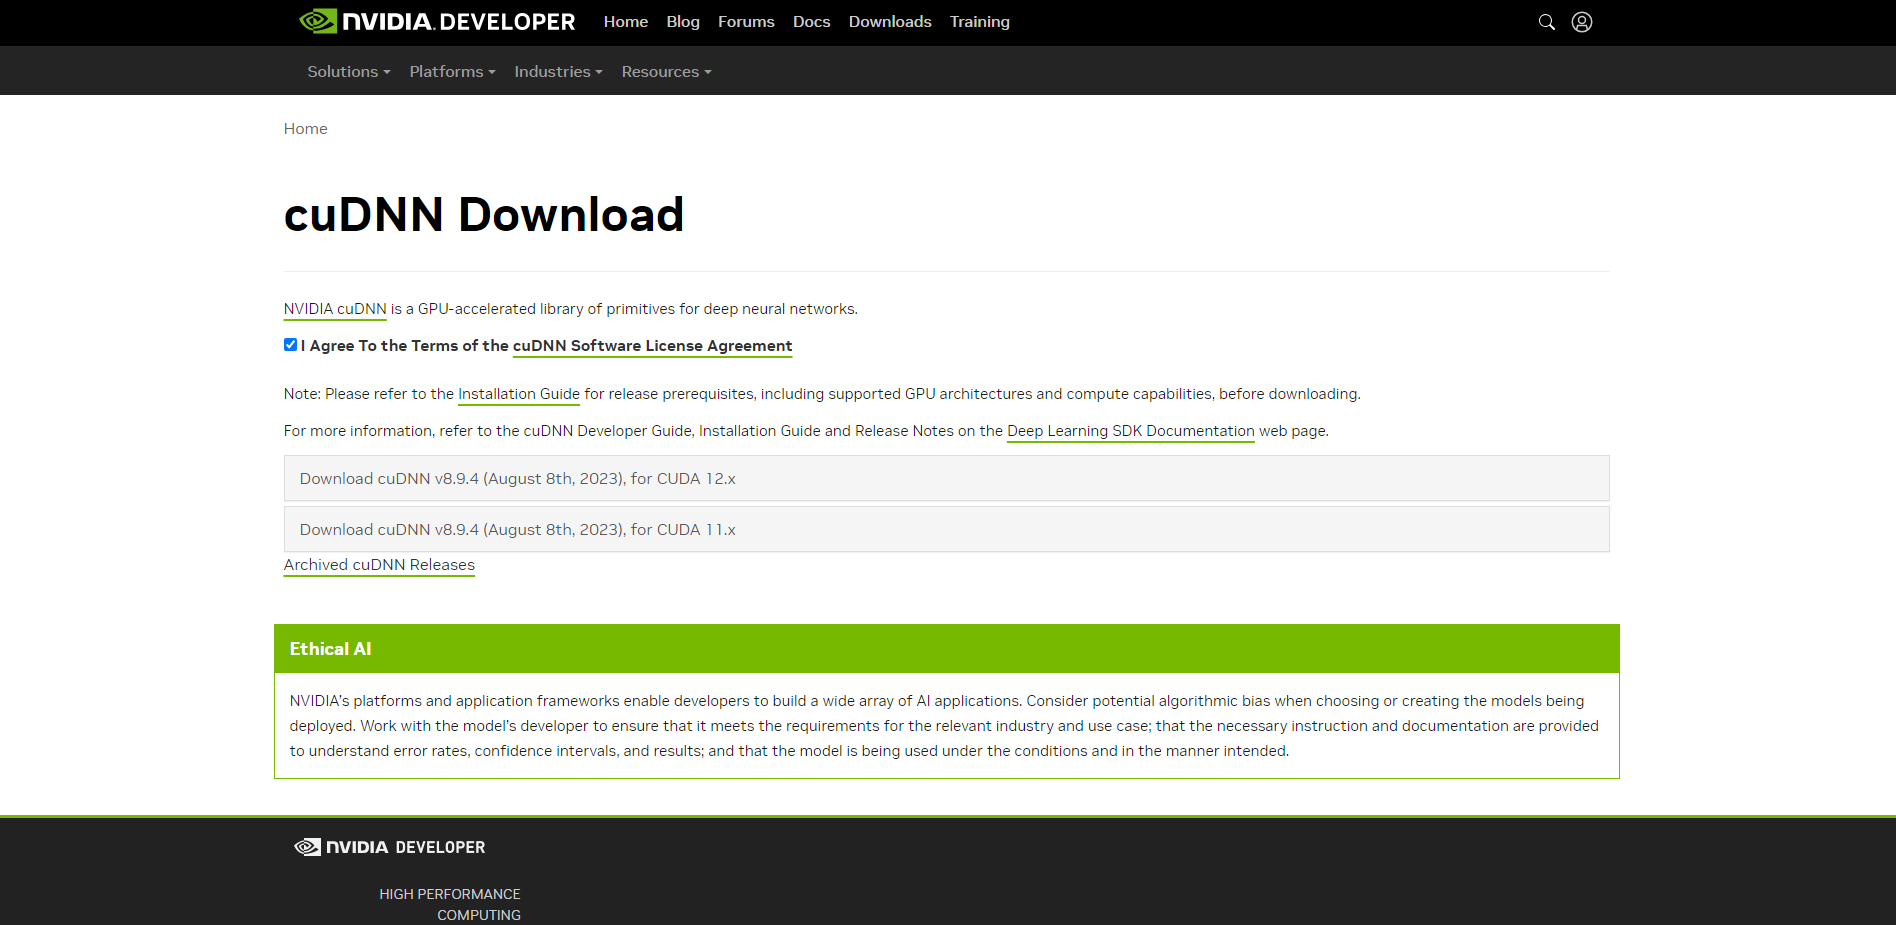
(1)解压cudnn-windows-x86_64-8.9.4.25_cuda12-archive.zip

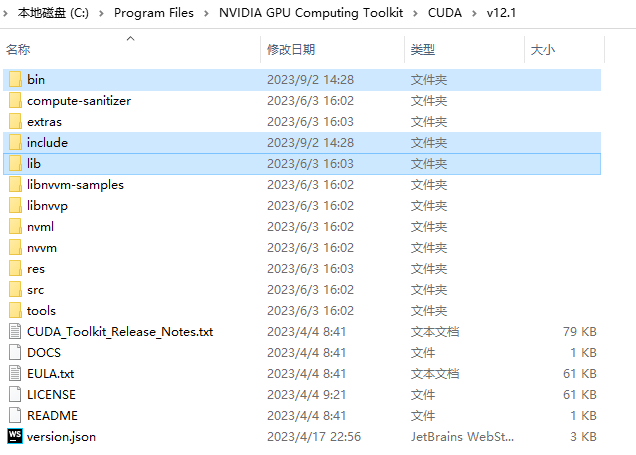
(2)拷贝到C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.1
参考文献:
[0]https://github.com/DeXtmL/bitsandbytes-win-prebuilt/tree/main
[1]https://github.com/facebookresearch/llama
[2]https://github.com/facebookresearch/llama-recipes/
[3]https://huggingface.co/meta-llama/Llama-2-7b-hf/tree/main
[4]https://huggingface.co/spaces/ysharma/Explore_llamav2_with_TGI
[5]https://huggingface.co/meta-llama/Llama-2-70b-chat-hf
[6]https://huggingface.co/blog/llama2
[7]https://developer.nvidia.com/rdp/cudnn-download
[8]https://github.com/jllllll/bitsandbytes-windows-webui
[9]https://github.com/langchain-ai/langchain
[10]https://github.com/AtomEcho/AtomBulb
[11]https://github.com/huggingface/peft
[12]全参数微调时,报没有target_modules变量:https://github.com/FlagAlpha/Llama2-Chinese/issues/169
[13]https://huggingface.co/FlagAlpha
[14]https://llama.family/
Llama2-Chinese项目:1-项目介绍和模型推理的更多相关文章
- iOS 9应用开发教程之创建iOS 9项目与模拟器介绍
iOS 9应用开发教程之创建iOS 9项目与模拟器介绍 编写第一个iOS 9应用 本节将以一个iOS 9应用程序为例,为开发者讲解如何使用Xcode 7.0去创建项目,以及iOS模拟器的一些功能.编辑 ...
- mnist手写数字识别——深度学习入门项目(tensorflow+keras+Sequential模型)
前言 今天记录一下深度学习的另外一个入门项目——<mnist数据集手写数字识别>,这是一个入门必备的学习案例,主要使用了tensorflow下的keras网络结构的Sequential模型 ...
- 团队项目作业:利用NABCD模型进行竞争性需求分析
NABC正是这样的一套框架,当你试图提出一项崭新的提案之际,它能够提供四个思维基点,令你的商业策划具备天马行空的基础. 具体来说,NABC是四个关键词的首字母缩写- Need(需求)-现在市场上未被满 ...
- 系列二VS项目软件配置工具介绍
原文:系列二VS项目软件配置工具介绍 Svn和VisualSvn介绍 在使用TortoiseSvn(SVN客户端)+ AnkhSvn(VS2008插件) +VisualSvn Server(版本控制服 ...
- Python爬虫教程-32-Scrapy 爬虫框架项目 Settings.py 介绍
本篇介绍项目开发的过程中,对 Setting 文件的配置和使用 Python爬虫教程-32-Scrapy 爬虫框架项目 Settings.py 介绍 settings.py 文件的使用 想要详细查看 ...
- Ionic01 简单介绍、环境搭建、创建项目、项目结构、创建组件、创建页面、子页面跳转
1 Ionic 基本介绍 Ionic 是一款基于 Angular.Cordova 的强大的 HTML5 移动应用开发框架 , 可以快速创建一个跨平台的移动应用.可以快速开发移动 App.移动端 WEB ...
- [Xcode 实际操作]一、博主领进门-(1)iOS项目的创建和项目模板的介绍
目录:[Swift]Xcode实际操作 本文将演示iOS项目的创建和项目模板的介绍. [Create a new Xcode project]创建一个新的项目. 在弹出的模板窗口中,显示了所有的项目模 ...
- vuecli创建项目-vue项目目录介绍-es6导入导出语法-小练习登录功能-scoped
目录 vuecli创建项目-vue项目目录介绍-es6导入导出语法-小练习登录功能-scoped 今日内容概要 今日内容详细 1 vue-ci创建项目 2 vue项目目录介绍 3 es6导入导出语法 ...
- 前端开发工程师 - 06.Mini项目实战 - 项目简介
第6章--Mini项目实战 项目简介 Mini项目简介-Ego社区开发 回顾: 页面制作 页面架构 JavaScript程序设计 DOM编程艺术 产品前端架构 实践课Mini项目--Ego: 主题:漫 ...
- 毕业设计代做,各种系统微服务项目ssm项目,员工管理系统,微信小程序,购物商城,二手商城系统,销售系统,等等
毕业设计代做,各种系统,微服务项目,ssm项目 小程序,商城等,期末作业等都可以,价格好说,长期接单, 有项目说明书,软件介绍相关文档,答辩的时候包过,知识点对接好,给你讲解等, 毕业设计代做,各种系 ...
随机推荐
- centos安装Vue
一直以来,有关LINUX的系统安装包,都是比较随意,直接使用yum进行或者apt-get 安装 标准安装流程是什么的呢.我们通过centos安装Vue进行展示 1 首先下载安装nodejs , htt ...
- Python3 解决pip报ssl.SSLError: [SSL: CERTIFICATE_VERIFY_FAILED] certificate verify failed (_ssl.c:598)
ERROR: Could not install packages due to an EnvironmentError: HTTPSConnectionPool(host='files.python ...
- 小程序提交POST请求,出现405错误
status": 405, "error": "Method Not Allowed", "message": "Req ...
- Galaxy Project | 生信人最值得学习的开源项目之一
我与 Galaxy Project 的渊源可以追溯到我刚毕业,还在华大实习的那一段时间,这个项目应该是我职业生涯中最重要的一段经历.虽然这么对年以来一直都关注着这个项目,但大多数都是浅尝辄止,对源码层 ...
- day09-SpringCloud Sleuth+Zipkin-链路追踪
SpringCloud Sleuth+Zipkin-链路追踪 官网:spring-cloud/spring-cloud-sleuth: Distributed tracing for spring c ...
- Kubernetes使用Harbor作为私有镜像仓库
概述 Harbor使用了基于角色的访问控制策略,当从Harbor中拉去镜像的时候,首先要进行身份认证,认证通过后才可以拉取镜像.在命令行模式下,需要先执行docker login,登陆成功后,才可以d ...
- Apple、AWS 这些科技巨头,已悄然入局隐私计算
随着数字化时代的到来,数据已经成为企业竞争的重要资源.然而,与此同时,数据隐私泄露的风险也在不断增加,这已经成为了公共安全和个人权利保护的重要问题.为了解决这个问题,科技巨头谷歌.苹果.亚马逊纷纷入局 ...
- LLaMA模型微调版本:斯坦福 Alpaca 详解
项目代码:https://github.com/tatsu-lab/stanford_alpaca 博客介绍:https://crfm.stanford.edu/2023/03/13/alpaca.h ...
- go select 使用总结
转载请注明出处: 在Go语言中,select语句用于处理多个通道的并发操作.它类似于switch语句,但是select语句用于通信操作,而不是条件判断.select语句会同时监听多个通道的操作,并选择 ...
- Asp-Net-Core学习笔记:gRPC快速入门
前言 此前,我在做跨语言调用时,用的是 Facebook 的 Thrift,挺轻量的,还不错. Thrift是一种接口描述语言和二进制通讯协议,它被用来定义和创建跨语言的服务.它被当作一个远程过程调用 ...