
你的Parquet该升级了:IOException: totalValueCount == 0问题定位之旅
摘要:使用Spark SQL进行ETL任务,在读取某张表的时候报错:“IOException: totalValueCount == 0”,但该表在写入时,并没有什么异常。
本文分享自华为云社区《你的Parquet该升级了:IOException: totalValueCount == 0问题定位之旅》,原文作者:wzhfy 。
1. 问题描述
使用Spark SQL进行ETL任务,在读取某张表的时候报错:“IOException: totalValueCount == 0”,但该表在写入时,并没有什么异常。
2. 初步分析
该表的结果是由两表join后生成。经分析,join的结果产生了数据倾斜,且倾斜key为null。Join后每个task写一个文件,所以partition key为null的那个task将大量的null值写入了一个文件,null值个数达到22亿。
22亿这个数字比较敏感,正好超过int最大值2147483647(21亿多)。因此,初步怀疑parquet在写入超过int.max个value时有问题。
【注】本文只关注大量null值写入同一个文件导致读取时报错的问题。至于该列数据产生如此大量的null是否合理,不在本文讨论范围之内。
3. Deep dive into Parquet (version 1.8.3,部分内容可能需要结合Parquet源码进行理解)
入口:Spark(Spark 2.3版本) -> Parquet
Parquet调用入口在Spark,所以从Spark开始挖掘调用栈。
InsertIntoHadoopFsRelationCommand.run()/SaveAsHiveFile.saveAsHiveFile() -> FileFormatWriter.write()
这里分几个步骤:
- 启动作业前,创建outputWriterFactory: ParquetFileFormat.prepareWrite()。这里会设置一系列与parquet写文件有关的配置信息。其中主要的一个,是设置WriteSupport类:ParquetOutputFormat.setWriteSupportClass(job, classOf[ParquetWriteSupport]),ParquetWriteSupport是Spark自己定义的类。
- 在executeTask() -> writeTask.execute()中,先通过outputWriterFactory创建OutputWriter (ParquetOutputWriter):outputWriterFactory.newInstance()。
- 对于每行记录,使用ParquetOutputWriter.write(InternalRow)方法依次写入parquet文件。
- Task结束前,调用ParquetOutputWriter.close()关闭资源。
3.1 Write过程
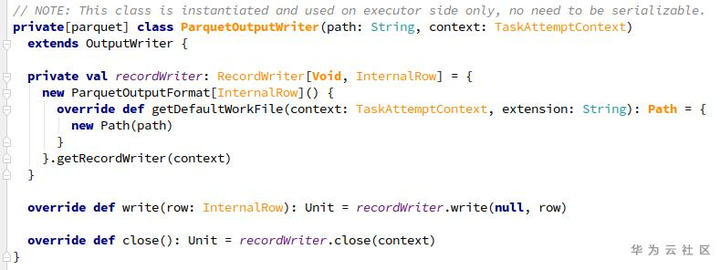
在ParquetOutputWriter中,通过ParquetOutputFormat.getRecordWriter构造一个RecordWriter(ParquetRecordWriter),其中包含了:
- prepareWrite()时设置的WriteSupport:负责转换Spark record并写入parquet结构
- ParquetFileWriter:负责写入文件
ParquetRecordWriter中,其实是把write操作委托给了一个internalWriter(InternalParquetRecordWriter,用WriteSupport和ParquetFileWriter构造)。
现在让我们梳理一下,目前为止的大致流程为:
SingleDirectoryWriteTask/DynamicPartitionWriteTask.execute
-> ParquetOutputWriter.write -> ParquetRecordWriter.write -> InternalParquetRecordWriter.write
接下来,InternalParquetRecordWriter.write里面,就是三件事:
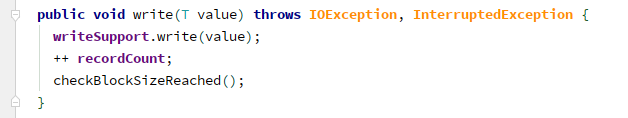
(1)writeSupport.write,即ParquetWriteSupport.write,里面分三个步骤:
- MessageColumnIO.MessageColumnIORecordConsumer.startMessage;
- ParquetWriteSupport.writeFields:写入一行中各个列的值,null值除外;
- MessageColumnIO.MessageColumnIORecordConsumer.endMessage:针对第二步中的missing fields写入null值。
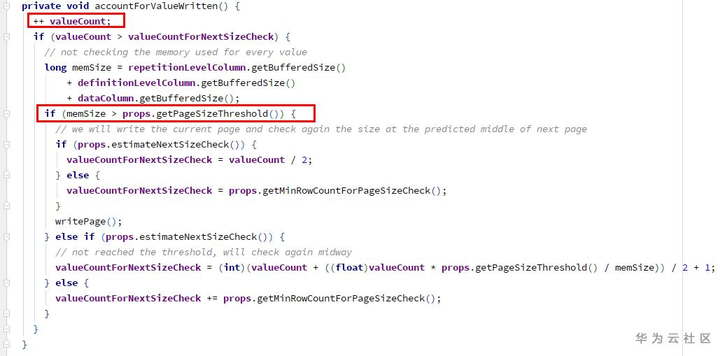
ColumnWriterV1.writeNull -> accountForValueWritten:
1) 增加计数器valueCount (int类型)
2) 检查空间是否已满,需要writePage - 检查点1
(2)增加计数器recordCount(long类型)
(3)检查block size,是否需要flushRowGroupToStore - 检查点2
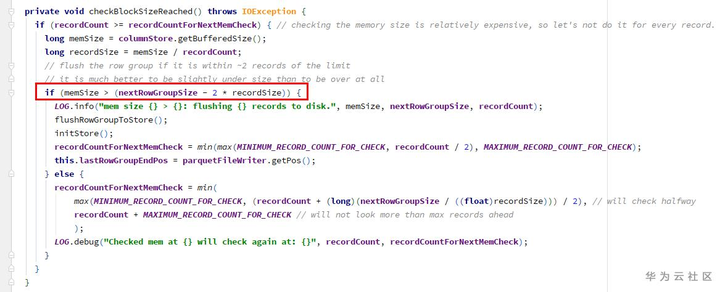
由于写入的值全是null,在1、2两个检查点的memSize都为0,所以不会刷新page和row group。导致的结果就是,一直在往同一个page里增加null值。而ColumnWriterV1的计数器valueCount是int类型,当超过int.max时,溢出,变为了一个负数。
因此,只有当调用close()方法时(task结束时),才会执行flushRowGroupToStore:
ParquetOutputWriter.close -> ParquetRecordWriter.close
-> InternalParquetRecordWriter.close -> flushRowGroupToStore
-> ColumnWriteStoreV1.flush -> for each column ColumnWriterV1.flush
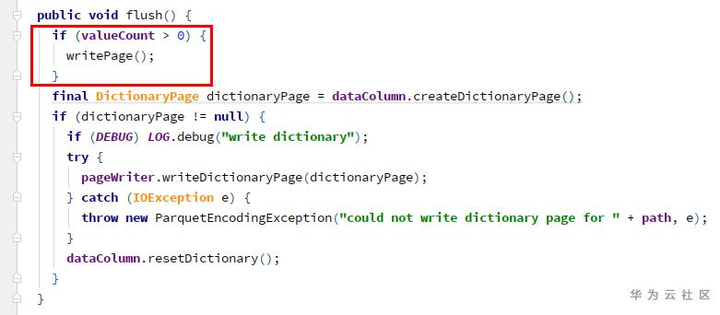
由于valueCount溢出为负,此处也不会写page。
因为未调用过writePage,所以此处的totalValueCount一直为0。
ColumnWriterV1.writePage -> ColumnChunkPageWriter.writePage -> 累计totalValueCount
在write结束时,InternalParquetRecordWriter.close -> flushRowGroupToStore -> ColumnChunkPageWriteStore.flushToFileWriter -> for each column ColumnChunkPageWriter.writeToFileWriter:
- ParquetFileWriter.startColumn:totalValueCount赋值给currentChunkValueCount
- ParquetFileWriter.writeDataPages
- ParquetFileWriter.endColumn:currentChunkValueCount(为0)和其他元数据信息构造出一个ColumnChunkMetaData,相关信息最终会被写入文件。
3.2 Read过程
同样以Spark为入口,进行查看。
初始化阶段:ParquetFileFormat.BuildReaderWithPartitionValues -> VectorizedParquetRecordReader.initialize -> ParquetFileReader.readFooter -> ParquetMetadataConverter.readParquetMetadata -> fromParquetMetadata -> ColumnChunkMetaData.get,其中包含valueCount(为0)。
读取时:VectorizedParquetRecordReader.nextBatch -> checkEndOfRowGroup:
1) ParquetFileReader.readNextRowGroup -> for each chunk, currentRowGroup.addColumn(chunk.descriptor.col, chunk.readAllPages())
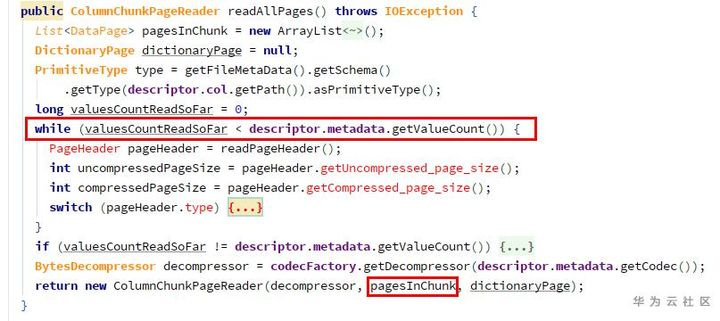
由于getValueCount为0,所以pagesInChunk为空。
2)构造ColumnChunkPageReader:
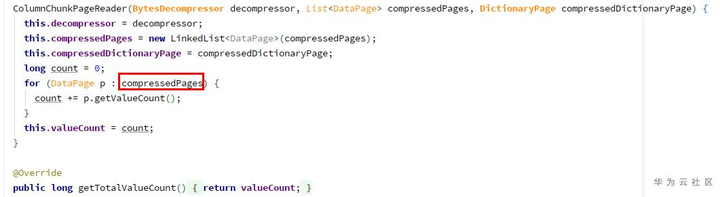
由于page列表为空,所以totalValueCount为0,导致在构造VectorizedColumnReader时报了问题中的错误。
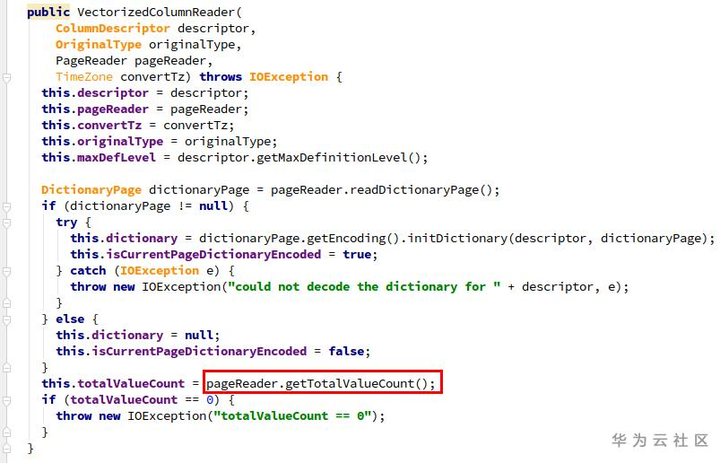
4. 解决方法:Parquet升级(version 1.11.1)
在新版本中,ParquetWriteSupport.write ->
MessageColumnIO.MessageColumnIORecordConsumer.endMessage ->
ColumnWriteStoreV1(ColumnWriteStoreBase).endRecord:
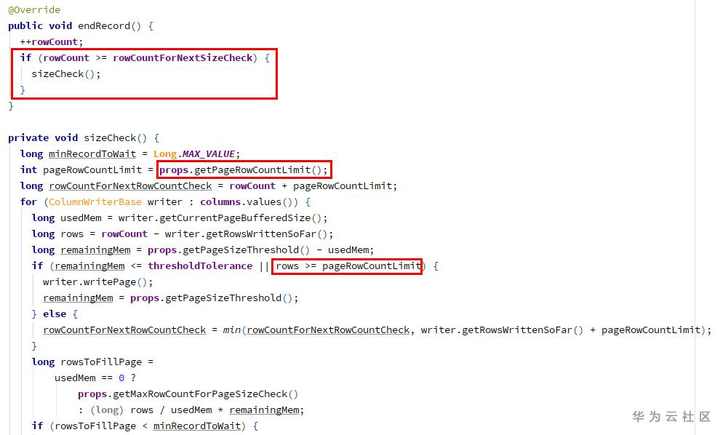
在endRecord中增加了每个page最大记录条数(默认2w条)的属性和检查逻辑,超出限制时会writePage,使得ColumnWriterV1的valueCount不会溢出(每次writePage后会清零)。
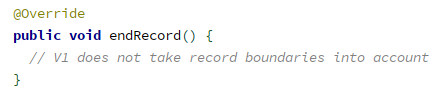
而对比老版本1.8.3中,ColumnWriteStoreV1.endRecord为空函数。
附:Parquet中的一个小trick
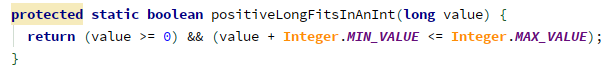
Parquet中为了节约空间,当一个long类型的值,在一定范围内时,会使用int来存储,其方法如下:
- 判断是否可以用int存储:
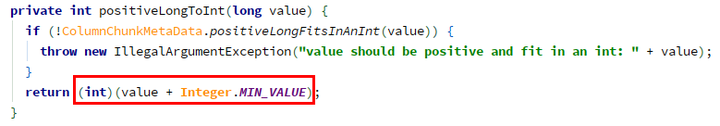
- 如果可以,用IntColumnChunkMetaData代替LongColumnChunkMetaData,构造时转换:
- 使用时,再转回来,IntColumnChunkMetaData.getValueCount -> intToPositiveLong():
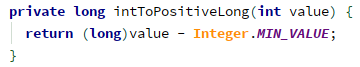
普通的int范围是 -2^31 ~ (2^31 - 1),由于元数据信息(如valueCount等)都是非负整数,那么实际只能存储0 ~ (2^31 - 1) 范围的数。而用这种方法,可以表示0 ~ (2^32 - 1) 范围的数,表达范围也大了一倍。
附件:可用于复现的测试用例代码(依赖Spark部分类,可置于Spark工程中运行)
测试用例代码.txt 1.88KB
你的Parquet该升级了:IOException: totalValueCount == 0问题定位之旅的更多相关文章
- Hadoop-1.2.1 升级到Hadoop-2.6.0 HA
Hadoop-1.2.1到Hadoop-2.6.0升级指南 作者 陈雪冰 修改日期 2015-04-24 版本 1.0 本文以hadoop-1.2.1升级到hadoop-2.6.0 Z ...
- DPA 9.1.85 升级到DPA 10.0.352流程
SolarWinds DPA的升级其实是一件非常简单的事情,这里介绍一下从DPA 9.1.95升级到 DPA 10.0.352版本的流程.为什么要升级呢? DPA给用户发的邮件已经写的非常清楚了(如下 ...
- jackson2.5.0升级到2.7.0
开发环境:spring-mvc4.1.7.jackson2.7.0 问题描述:项目中将原来的jackson2.5.0升级到2.7.0,导致服务调用出错. mvc相关的配置文件如下: <?xml ...
- ORACLE 10升级到10.2.0.5 Patch Set遇到的内核参数检测失败问题
在测试ORACLE 10.2.0.4升级到10.2.0.5 Patch Set的过程中,遇到一个内核参数检查失败的问题,具体错误信息如下所示 实验环境: 操作系统:Oracle Linux Ser ...
- 探索Oracle数据库升级6 11.2.0.4.3 Upgrade12c(12.1.0.1)
探索Oracle数据库升级6 11.2.0.4.3 Upgrade12c(12.1.0.1) 一.前言: Oracle 12c公布距今已经一年有余了,其最大亮点是一个能够插拔的数据库(PD ...
- linux内核升级(ubuntu12.04从3.13.0升级到3.4.0 )
花了一天的时间,终于把ubuntu12.04 的linux内核版本从3.13.0升级到3.4.0 升级后,系统更加稳定.具体步骤:# wget http://www.kernel.org/pub/li ...
- mac版chrome升级到Version 65.0.3325.18后无法打开百度bing搜狗
mac版本chrome升级到Version 65.0.3325.18后发现突然无法访问百度,搜狗,bing,神马等一系列的国内搜索引擎网站.连百度的儿子们比如知道,百度百科都无法访问. 1.首先想到的 ...
- 【Android Studio安装部署系列】三十一、从Android studio3.0.0升级到Android studio3.0.1
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 概述 突然想要升级到较高版本.要跟随潮流嘛,不然就落后了. 下载IDE http://www.wanandroid.com/tools/i ...
- CoreProfiler升级到.NetStandard 2.0
致所有感兴趣的朋友: CoreProfiler和相应的Sample项目cross-app-profiling-demo都已经升级到.NetStandrard 2.0和.NetCore 2.0. 有任何 ...
- maven私库nexus2.11.4迁移升级到nexus3.12.0
nexus简介 nexus是一个强大的maven仓库管理器,它极大的简化了本地内部仓库的维护和外部仓库的访问. nexus是一套开箱即用的系统不需要数据库,它使用文件系统加Lucene来组织数据 .n ...
随机推荐
- kubeadm 工具部署 kubernetes v1.16.2
环境准备 3个节点,以下基于 Centos 7.6 系统, 内核版本:3.10.0-957.12.2.e17.x86_64 HOST NODE CPU MEM 192.168.1.111 master ...
- np.array和np.ndarry 的区别
np.array和np.ndarray都是NumPy中用于创建多维数组的函数. np.ndarray是NumPy中的多维数组类,它是一种可变的数组,可以通过修改数组中的元素来改变其内容.使用np.nd ...
- Html文本学习内容-2
(一)文本 1.大小写转换 text-transform属于处理文本的大小写,有4个值: none(默认值) uppercase(全部大写) lowercase(全部小写) capitalize(首字 ...
- spring---反射(java.lang.reflect)
反射简介 反射是Java的高级特性之一,但是在实际的开发中,使用Java反射的案例却非常的少,但是反射确实在底层框架中被频繁的使用. 比如:JDBC中的加载数据库驱动程序,Spring框架中加载bea ...
- Python 既是解释型语言,也是编译型语言
哈喽大家好,我是咸鱼 不知道有没有小伙伴跟我一样,刚开始学习 Python 的时候都听说过 Python 是一种解释型语言,因为它在运行的时候会逐行解释并执行,而 C++ 这种是编译型语言 不过我今天 ...
- pnpm 管理依赖包是如何节省磁盘空间的?
npm 存在的问题 我们经常使用 npm 来管理 node 项目中的包,从 package.json 中读取配置将依赖下载到本地,以保障项目的正常运行. 当项目数量多时,这样的包管理方式会非常的占用电 ...
- 如何修改Ubuntu的时间与时间同步
1.安装ntpdate,同步标准时间 zce@ubuntu:~$ sudo apt install ntpdate 输入管理员密码确认安装 zce@ubuntu:~$ sudo apt install ...
- CLion安装与配置教程
一.下载并安装CLion 1.下载 1.官网: Download CLion 2.注意: 这里建议使用2021.1.3版本之前,为之后的使用便利而做打算. (这里以Windows系统为例,其他系统类似 ...
- .NET微信网页开发相关文章教程
前言 今天我们主要总结一下.NET微信网页开发的相关文章教程. 微信网页开发详细文档可以看微信官方文档:https://developers.weixin.qq.com/doc/offiaccount ...
- springboot整合kafka,收不到消息,日志输出dead for group解决方法
项目启动以后收不到Kafka发出的消息,日志输出类似: INFO [org.springframework.kafka.KafkaListenerEndpointContainer#1-7-C-1] ...