
Java Springbool敏感词过工具类滤
Java Springbool敏感词过工具类滤
1. 功能描述
利用前缀树这种数据结构,设计并开发出敏感词过滤工具。
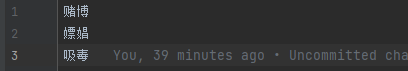
2. 构建敏感词表
resource/sensitive-words.txt
3. 敏感词过滤器
util/SensitiveUtil.java
构建前缀树
定义过滤方法
package com.wlnl.lanaer.service.api.util;

import lombok.extern.slf4j.Slf4j;
import org.apache.commons.lang.CharUtils;
import org.apache.commons.lang.StringUtils;

import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStream;
import java.io.InputStreamReader;
import java.util.HashMap;
import java.util.Map;

@Slf4j
public class SensitiveUtil {

    private static final String FILE_NAME = "sensitive-words.txt";

// 默认替换符
private static final String REPLACEMENT = "***";

// 根节点
private static TrieNode rootNode = new TrieNode();

    static {
        try (
                InputStream is = SensitiveUtil.class.getClassLoader().getResourceAsStream(FILE_NAME);
BufferedReader reader = new BufferedReader(new InputStreamReader(is));
) {
            String keyword;
            while ((keyword = reader.readLine()) != null) {
                // 添加到前缀树
addKeyword(keyword);
}
        } catch (IOException e) {
            log.error("加载敏感词文件失败: " + e.getMessage());
}
    }

    // 将一个敏感词添加到前缀树中
private static void addKeyword(String keyword) {
        TrieNode tempNode = rootNode;
        for (int i = 0; i < keyword.length(); i++) {
            char c = keyword.charAt(i);
TrieNode subNode = tempNode.getSubNode(c);

            if (subNode == null) {
                // 初始化子节点
subNode = new TrieNode();
tempNode.addSubNode(c, subNode);
}

            // 指向子节点,进入下一轮循环
tempNode = subNode;

// 设置结束标识
if (i == keyword.length() - 1) {
                tempNode.setKeywordEnd(true);
}
        }
    }

    /**
     * 判断是否有关键字
* @param text
* @return
*/
public static boolean hasKeyword(String text) {
        if (StringUtils.isBlank(text)) {
            return false;
}

        // 指针1
TrieNode tempNode = rootNode;
// 指针2
int begin = 0;
// 指针3
int position = 0;

        while (position < text.length()) {
            char c = text.charAt(position);

// 跳过符号
if (isSymbol(c)) {
                // 若指针1处于根节点,将此符号计入结果,让指针2向下走一步
if (tempNode == rootNode) {
                    begin++;
}
                // 无论符号在开头或中间,指针3都向下走一步
position++;
                continue;
}

            // 检查下级节点
tempNode = tempNode.getSubNode(c);
            if (tempNode == null) {
                // 进入下一个位置
position = ++begin;
// 重新指向根节点
tempNode = rootNode;
} else if (tempNode.isKeywordEnd()) {
                // 发现敏感词
return true;
} else {
                // 检查下一个字符
position++;
}
        }
        return false;
}

    /**
     * 过滤敏感词
*
     * @param text 待过滤的文本
* @return 过滤后的文本
*/
public static String filter(String text) {
        return filter(text, REPLACEMENT);
}

    /**
     * 过滤敏感词
*
     * @param text 待过滤的文本
* @param substitute 敏感词替换字符串
* @return 过滤后的文本
*/
public static String filter(String text, String substitute) {
        if (StringUtils.isBlank(text)) {
            return null;
}
        if (null == substitute) {
            substitute = REPLACEMENT;
}

        // 指针1
TrieNode tempNode = rootNode;
// 指针2
int begin = 0;
// 指针3
int position = 0;
// 结果
StringBuilder sb = new StringBuilder();

        while (position < text.length()) {
            char c = text.charAt(position);

// 跳过符号
if (isSymbol(c)) {
                // 若指针1处于根节点,将此符号计入结果,让指针2向下走一步
if (tempNode == rootNode) {
                    sb.append(c);
begin++;
}
                // 无论符号在开头或中间,指针3都向下走一步
position++;
                continue;
}

            // 检查下级节点
tempNode = tempNode.getSubNode(c);
            if (tempNode == null) {
                // 以begin开头的字符串不是敏感词
sb.append(text.charAt(begin));
// 进入下一个位置
position = ++begin;
// 重新指向根节点
tempNode = rootNode;
} else if (tempNode.isKeywordEnd()) {
                // 发现敏感词,将begin~position字符串替换掉
sb.append(substitute);
// 进入下一个位置
begin = ++position;
// 重新指向根节点
tempNode = rootNode;
} else {
                // 检查下一个字符
position++;
}
        }

        // 将最后一批字符计入结果
sb.append(text.substring(begin));

        return sb.toString();
}

    // 判断是否为符号
private static boolean isSymbol(Character c) {
        // 0x2E80~0x9FFF 是东亚文字范围
return !CharUtils.isAsciiAlphanumeric(c) && (c < 0x2E80 || c > 0x9FFF);
}

    // 前缀树
private static class TrieNode {

        // 关键词结束标识
private boolean isKeywordEnd = false;

// 子节点(key是下级字符,value是下级节点)
private Map<Character, TrieNode> subNodes = new HashMap<>();

        public boolean isKeywordEnd() {
            return isKeywordEnd;
}

        public void setKeywordEnd(boolean keywordEnd) {
            isKeywordEnd = keywordEnd;
}

        // 添加子节点
public void addSubNode(Character c, TrieNode node) {
            subNodes.put(c, node);
}

        // 获取子节点
public TrieNode getSubNode(Character c) {
            return subNodes.get(c);
}

    }

}
4. 测试过滤敏感词功能
package com.wlnl.lanaer.service.api.mq;

import com.wlnl.lanaer.service.api.KxkdApiServiceApplication;
import com.wlnl.lanaer.service.api.util.BlogKeywordUtil;
import org.junit.jupiter.api.extension.ExtendWith;
import org.springframework.boot.test.autoconfigure.web.servlet.AutoConfigureMockMvc;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.test.context.ActiveProfiles;
import org.springframework.test.context.junit.jupiter.SpringExtension;

@SpringBootTest(webEnvironment = SpringBootTest.WebEnvironment.RANDOM_PORT, classes = {KxkdApiServiceApplication.class})
@AutoConfigureMockMvc
@ExtendWith(SpringExtension.class)
@ActiveProfiles(profiles = "dev")
public class TestSensitiveWords {

    public static void main(String[] args) {
        String text = "这里可以赌博,可以嫖娼,可以吸毒,哈哈哈!";
String text1 = "这里可以-赌-博-,可以,嫖,娼,,可以=吸=毒=,哈哈哈!";
String text2 = "正规正规";
        boolean bool = BlogKeywordUtil.hasKeyword(text);
System.out.println("是否有关键词:" + bool);
System.out.println("过滤后的文本:" + BlogKeywordUtil.filter(text));

System.out.println("是否有关键词:" + BlogKeywordUtil.hasKeyword(text1));
System.out.println("过滤后的文本:" + BlogKeywordUtil.filter(text1));

System.out.println("是否有关键词:" + BlogKeywordUtil.hasKeyword(text2));
System.out.println("过滤后的文本:" + BlogKeywordUtil.filter(text2));
}

}
执行结果

Java Springbool敏感词过工具类滤的更多相关文章
- C++ 简单中文敏感词检测工具类
具体思路: 1->敏感词库,可从数据库读取,也可以从文件加载. 2->将敏感词转化为gbk编码,因为gbk严格按照字符一个字节,汉字两个字节的格式编码,便于容易切分文字段. 3->将 ...
- Java实现敏感词过滤 - IKAnalyzer中文分词工具
IKAnalyzer 是一个开源的,基于java语言开发的轻量级的中文分词工具包. 官网: https://code.google.com/archive/p/ik-analyzer/ 本用例借助 I ...
- java实现敏感词过滤(DFA算法)
小Alan在最近的开发中遇到了敏感词过滤,便去网上查阅了很多敏感词过滤的资料,在这里也和大家分享一下自己的理解. 敏感词过滤应该是不用给大家过多的解释吧?讲白了就是你在项目中输入某些字(比如输入xxo ...
- Java实现敏感词过滤 - DFA算法
Java实现DFA算法进行敏感词过滤 封装工具类如下: 使用前需对敏感词库进行初始化: SensitiveWordUtil.init(sensitiveWordSet); package cn.swf ...
- java 实现敏感词(sensitive word)工具详解使用说明
sensitive-word 平时工作中,只要涉及到用户可以自由发言(博客.文档.论坛),就要考虑内容的敏感性处理. sensitive-word 基于 DFA 算法实现的高性能敏感词工具.工具使用 ...
- Java实现敏感词过滤
敏感词.文字过滤是一个网站必不可少的功能,如何设计一个好的.高效的过滤算法是非常有必要的.前段时间我一个朋友(马上毕业,接触编程不久)要我帮他看一个文字过滤的东西,它说检索效率非常慢.我把它程序拿过来 ...
- Java实现敏感词过滤(转)
敏感词.文字过滤是一个网站必不可少的功能,如何设计一个好的.高效的过滤算法是非常有必要的.前段时间我一个朋友(马上毕业,接触编程不久)要我帮他看一个文字过滤的东西,它说检索效率非常慢.我把它程序拿过来 ...
- 转:Java实现敏感词过滤
敏感词.文字过滤是一个网站必不可少的功能,如何设计一个好的.高效的过滤算法是非常有必要的.前段时间我一个朋友(马上毕业,接触编程不久)要我帮他看一个文字过滤的东西,它说检索效率非常慢.我把它程序拿过来 ...
- Java操作文件夹的工具类
Java操作文件夹的工具类 import java.io.File; public class DeleteDirectory { /** * 删除单个文件 * @param fileName 要删除 ...
- Java汉字转成汉语拼音工具类
Java汉字转成汉语拼音工具类,需要用到pinyin4j.jar包. import net.sourceforge.pinyin4j.PinyinHelper; import net.sourcefo ...
随机推荐
- SPI总线学习笔记
SPI是串行外设接口(Serial Peripheral Interface)的缩写,是一种高速的,全双工,同步的通信总线,并且在芯片的管脚上只占用四根线,节约了芯片的管脚,同时为PCB的布局上节省空 ...
- 【分享】如何才能简洁高效不失优雅的爆破ZIP文件?
0x01 前言 在CTF比赛中,压缩包密码的爆破一直是一个热门话题.在这个过程中,简洁高效的方法是至关重要的.本文将介绍一些实用的技巧和工具,帮助您高效地爆破ZIP文件密码,而不失优雅.我们将探讨一些 ...
- Blazor前后端框架Known-V1.2.11
V1.2.11 Known是基于C#和Blazor开发的前后端分离快速开发框架,开箱即用,跨平台,一处代码,多处运行. Gitee: https://gitee.com/known/Known Git ...
- 使用lame转wav为mp3
使用lame转wav为mp3 由于服务器之前都是直接存储wav格式的录音文件,存储空间总是不够用.网上搜索了一下,可以使用lame这个开源工具,将wav转成MP3 格式,还可以将mp3文件转回wav格 ...
- 2023HWS_RE复现
2023HWS_RE复现 参考wp:https://oacia.cc/hws-2023/ Android 参考这篇文章:https://www.52pojie.cn/thread-1680984-1- ...
- 微服务集成redis并通过redis实现排行榜的功能
默认你已经看过我之前的教程了,并且拥有上个教程完成的项目, 之前的教程 https://www.cnblogs.com/leafstar/p/17638933.html 由于redis的安装网上教程很 ...
- 多重断言插件之pytest-assume的简单使用
背景: pytest-assume是Pytest框架的一个扩展,它允许在单个测试用例中多次断言.通常情况下,当一个断言失败时,测试会立即停止执行,而pytest-assume允许我 们继续执行剩余的断 ...
- mysql到底需不需要容器化?
前言:在容器化的时代,当然一切皆可容器化.在docker官网首页赫然有下面这几个大字.足以知道docker的优势.那么且问,mysql适合跑在docker中吗? 当然,这个问题有人说可以,也有人说不可 ...
- 获取API接口返回的商品详情数据后该如何使用
获取API接口返回的商品详情数据后,我们可以使用以下方式将其处理和利用: 数据展示:我们可以将API接口返回的商品详情数据以列表.表格.图形等形式展示给用户,以便他们更好地了解商品的基本信息.特征.评 ...
- 「joisc2016 - D3T2」回転寿司
题意大概是这样,「每次操作选出区间中的一个 LIS(strictly),满足其开端是极靠近左端点且大于 \(A\) 的位置,答案即这个 LIS 的末尾,做一个轮换后弹出序列末端」. 首先做几个观察. ...