
DQN(Deep Reiforcement Learning) 发展历程(三)
不基于模型(Model-free)的预测
- 无法事先了解状态转移的概率矩阵
蒙特卡罗方法
从开始状态开始,到终结状态,找到一条完整的状态序列,以求解每个状态的值。相比于在整个的状态空间搜索,是一种采样的方法。
- 对于某一状态在同一状态序列中重复出现的,有以下两种方法:
- 只选择第一个状态进行求解,忽略之后的所有相同状态
- 考虑所有的状态,求平均值
- 对于求解每个状态的值,使用平均值代表状态值,根据大数定理,状态数足够多的条件下,该平均值等于状态值。平均值求解有两种方法:
- 存储所有状态后求平均:消耗大量存储空间
- 每次迭代状态都更新当前平均值:
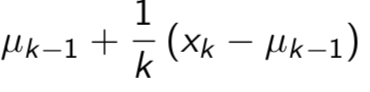
时序差分方法
- 蒙特卡罗方法需要获得从开始到终结的一条完整的状态序列,以求解每个状态的值,时序差分方法则不需要。根据贝尔曼不等式,只需要从当前状态到下一状态求解。
- 时序差分方法每步都更新状态值,而蒙特卡罗方法需要等到所有状态结束才更新。
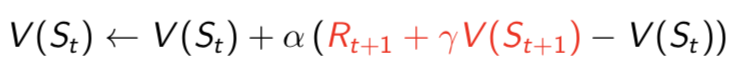
- 蒙特卡罗方法使用最后的目标来求解状态值,而时序差分使用下一状态的估计在每一步调整状态值。
- 蒙特卡罗方法是无偏估计方差较大,时序差分则是有篇估计但估计方差小。
多步的时序差分方法
- 时序差分方法使用当前状态值和下一状态值更新当前状态值,如果使用当前状态值和之后多步的状态值更新当前状态值,就是多步的时序差分方法。
- 当步数到最后的终结状态时,便是蒙特卡罗方法。
- 当步数到下一状态时,便是时序差分方法。
- 多步的时序差分方法,分为前向和后向的时序差分方法。
参考
david siver 课程
https://home.cnblogs.com/u/pinard/
DQN(Deep Reiforcement Learning) 发展历程(三)的更多相关文章
- DQN(Deep Reiforcement Learning) 发展历程(五)
目录 值函数的近似 DQN Nature DQN DDQN Prioritized Replay DQN Dueling DQN 参考 DQN发展历程(一) DQN发展历程(二) DQN发展历程(三) ...
- DQN(Deep Reiforcement Learning) 发展历程(四)
目录 不基于模型的控制 选取动作的方法 在策略上的学习(on-policy) 不在策略上的学习(off-policy) 参考 DQN发展历程(一) DQN发展历程(二) DQN发展历程(三) DQN发 ...
- DQN(Deep Reiforcement Learning) 发展历程(二)
目录 动态规划 使用条件 分类 求解方法 参考 DQN发展历程(一) DQN发展历程(二) DQN发展历程(三) DQN发展历程(四) DQN发展历程(五) 动态规划 动态规划给出了求解强化学习的一种 ...
- DQN(Deep Reiforcement Learning) 发展历程(一)
目录 马尔可夫理论 马尔可夫性质 马尔可夫过程(MP) 马尔可夫奖励过程(MRP) 值函数(value function) MRP求解 马尔可夫决策过程(MDP) 效用函数 优化的值函数 贝尔曼等式 ...
- Deep Reinforcement Learning 基础知识(DQN方面)
Introduction 深度增强学习Deep Reinforcement Learning是将深度学习与增强学习结合起来从而实现从Perception感知到Action动作的端对端学习的一种全新的算 ...
- [DQN] What is Deep Reinforcement Learning
已经成为DL中专门的一派,高大上的样子 Intro: MIT 6.S191 Lecture 6: Deep Reinforcement Learning Course: CS 294: Deep Re ...
- C#与C++的发展历程第三 - C#5.0异步编程巅峰
系列文章目录 1. C#与C++的发展历程第一 - 由C#3.0起 2. C#与C++的发展历程第二 - C#4.0再接再厉 3. C#与C++的发展历程第三 - C#5.0异步编程的巅峰 C#5.0 ...
- 论文笔记之:Dueling Network Architectures for Deep Reinforcement Learning
Dueling Network Architectures for Deep Reinforcement Learning ICML 2016 Best Paper 摘要:本文的贡献点主要是在 DQN ...
- Deep Reinforcement Learning: Pong from Pixels
这是一篇迟来很久的关于增强学习(Reinforcement Learning, RL)博文.增强学习最近非常火!你一定有所了解,现在的计算机能不但能够被全自动地训练去玩儿ATARI(译注:一种游戏机) ...
随机推荐
- 说说gogoTester-nodejs 的实现
一直在使用goagent,所以对于查找google可用ip有了很大的兴趣,在github上面发现有一个项目是gogoTester,是用来查找google ip的,于是突发奇想自己用nodejs写了一个 ...
- 【代码笔记】iOS-动画的跳转
一,工程图. 二,代码. //点击任何处跳转到页面 -(void)touchesBegan:(NSSet *)touches withEvent:(UIEvent *)event { CATransi ...
- 面向对象的JS随笔
Scoping 全局与局部 全局变量可用在所有环境中,局部变量只可用在局部 js中连接变量至一个从未声明的变量,后面的变量自动提升成一个全局变量(不要这样用,不易阅读) 只有function(){中才 ...
- js 匿名函数立即执行问题
js立即执行函数写法理解 这篇真的写得很清楚了,不光括号可以将函数声明转换成函数表达式然后立即执行,!,+,-,=也都可以转换,但是可能会带来意外的结果,因此一般都用括号实现. 还有关于for (va ...
- 纯小白入手 vue3.0 CLI - 2.1 - 组件 ( component )
vue3.0 CLI 真小白入手全教程系列:https://www.cnblogs.com/ndos/category/1295752.html 我的 github 地址 - vue3.0Study ...
- hudson运行出现java.io.IOException Cannot run program的错误分析
作者:朱金灿 来源:http://blog.csdn.net/clever101 在昨天运行每日构建时hudson突然出错,错误信息如下: [MySoft3.1] $ cmd /c call &quo ...
- [基础架构]PeopleSoft Web Server 重要文件说明
我们都知道PeopleSoft是由几个不同的服务组成的,他们在PeopleSoft体系结构中扮演着自己的角色.这些服务具有不同的文件结构并包含重要的可执行文件和配置文件. 以下是Peoplesoft体 ...
- ActiveReports 报表控件V12新特性 -- 可定制的安装设置
ActiveReports是一款专注于 .NET 平台的报表控件,全面满足 HTML5 / WinForms / ASP.NET / ASP.NET MVC / WPF 等平台下报表设计和开发工作需求 ...
- linux 网络和流量监控
1.流量监控 工具iptraf 安装:sudo apt-get install iptraf 运行:sudo iptraf 2.网络监控扫描 参考:https://www.cnblogs.com/ ...
- 腾讯TBS X5 WebView的简单使用
工作中经常涉及H5网页的加载工作,最多使用的就是安卓系统控件WebView,但是当网页内容比较多的时候,需要等待很久才能加载完,加载完后用户才能看到网页中的内容,这样用户需要等很久,体验很差. 那能不 ...