
cuda中threadIdx、blockIdx、blockDim和gridDim的使用
threadIdx是一个uint3类型,表示一个线程的索引。
blockIdx是一个uint3类型,表示一个线程块的索引,一个线程块中通常有多个线程。
blockDim是一个dim3类型,表示线程块的大小。
gridDim是一个dim3类型,表示网格的大小,一个网格中通常有多个线程块。
下面这张图比较清晰的表示的几个概念的关系:
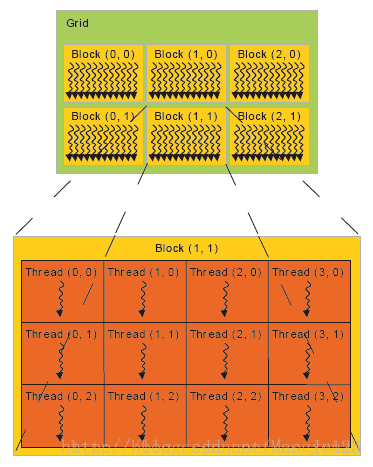
cuda 通过<<< >>>符号来分配索引线程的方式,我知道的一共有15种索引方式。
下面程序展示了这15种索引方式:
#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include <stdio.h>

#include <stdlib.h>

#include <iostream>

using namespace std;

//thread 1D

__global__ void testThread1(int *c, const int *a, const int *b)

{

    int i = threadIdx.x;

    c[i] = b[i] - a[i];

}

//thread 2D

__global__ void testThread2(int *c, const int *a, const int *b)

{

    int i = threadIdx.x + threadIdx.y*blockDim.x;

    c[i] = b[i] - a[i];

}

//thread 3D

__global__ void testThread3(int *c, const int *a, const int *b)

{

    int i = threadIdx.x + threadIdx.y*blockDim.x + threadIdx.z*blockDim.x*blockDim.y;

    c[i] = b[i] - a[i];

}

//block 1D

__global__ void testBlock1(int *c, const int *a, const int *b)

{

    int i = blockIdx.x;

    c[i] = b[i] - a[i];

}

//block 2D

__global__ void testBlock2(int *c, const int *a, const int *b)

{

    int i = blockIdx.x + blockIdx.y*gridDim.x;

    c[i] = b[i] - a[i];

}

//block 3D

__global__ void testBlock3(int *c, const int *a, const int *b)

{

    int i = blockIdx.x + blockIdx.y*gridDim.x + blockIdx.z*gridDim.x*gridDim.y;

    c[i] = b[i] - a[i];

}

//block-thread 1D-1D

__global__ void testBlockThread1(int *c, const int *a, const int *b)

{

    int i = threadIdx.x + blockDim.x*blockIdx.x;

    c[i] = b[i] - a[i];

}

//block-thread 1D-2D

__global__ void testBlockThread2(int *c, const int *a, const int *b)

{

    int threadId_2D = threadIdx.x + threadIdx.y*blockDim.x;

    int i = threadId_2D+ (blockDim.x*blockDim.y)*blockIdx.x;

    c[i] = b[i] - a[i];

}

//block-thread 1D-3D

__global__ void testBlockThread3(int *c, const int *a, const int *b)

{

    int threadId_3D = threadIdx.x + threadIdx.y*blockDim.x + threadIdx.z*blockDim.x*blockDim.y;

    int i = threadId_3D + (blockDim.x*blockDim.y*blockDim.z)*blockIdx.x;

    c[i] = b[i] - a[i];

}

//block-thread 2D-1D

__global__ void testBlockThread4(int *c, const int *a, const int *b)

{

    int blockId_2D = blockIdx.x + blockIdx.y*gridDim.x;

    int i = threadIdx.x + blockDim.x*blockId_2D;

    c[i] = b[i] - a[i];

}

//block-thread 3D-1D

__global__ void testBlockThread5(int *c, const int *a, const int *b)

{

    int blockId_3D = blockIdx.x + blockIdx.y*gridDim.x + blockIdx.z*gridDim.x*gridDim.y;

    int i = threadIdx.x + blockDim.x*blockId_3D;

    c[i] = b[i] - a[i];

}

//block-thread 2D-2D

__global__ void testBlockThread6(int *c, const int *a, const int *b)

{

    int threadId_2D = threadIdx.x + threadIdx.y*blockDim.x;

    int blockId_2D = blockIdx.x + blockIdx.y*gridDim.x;

    int i = threadId_2D + (blockDim.x*blockDim.y)*blockId_2D;

    c[i] = b[i] - a[i];

}

//block-thread 2D-3D

__global__ void testBlockThread7(int *c, const int *a, const int *b)

{

    int threadId_3D = threadIdx.x + threadIdx.y*blockDim.x + threadIdx.z*blockDim.x*blockDim.y;

    int blockId_2D = blockIdx.x + blockIdx.y*gridDim.x;

    int i = threadId_3D + (blockDim.x*blockDim.y*blockDim.z)*blockId_2D;

    c[i] = b[i] - a[i];

}

//block-thread 3D-2D

__global__ void testBlockThread8(int *c, const int *a, const int *b)

{

    int threadId_2D = threadIdx.x + threadIdx.y*blockDim.x;

    int blockId_3D = blockIdx.x + blockIdx.y*gridDim.x + blockIdx.z*gridDim.x*gridDim.y;

    int i = threadId_2D + (blockDim.x*blockDim.y)*blockId_3D;

    c[i] = b[i] - a[i];

}

//block-thread 3D-3D

__global__ void testBlockThread9(int *c, const int *a, const int *b)

{

    int threadId_3D = threadIdx.x + threadIdx.y*blockDim.x + threadIdx.z*blockDim.x*blockDim.y;

    int blockId_3D = blockIdx.x + blockIdx.y*gridDim.x + blockIdx.z*gridDim.x*gridDim.y;

    int i = threadId_3D + (blockDim.x*blockDim.y*blockDim.z)*blockId_3D;

    c[i] = b[i] - a[i];

}

void addWithCuda(int *c, const int *a, const int *b, unsigned int size)

{

    int *dev_a = ;

    int *dev_b = ;

    int *dev_c = ;

    cudaSetDevice();

    cudaMalloc((void**)&dev_c, size * sizeof(int));

    cudaMalloc((void**)&dev_a, size * sizeof(int));

    cudaMalloc((void**)&dev_b, size * sizeof(int));

    cudaMemcpy(dev_a, a, size * sizeof(int), cudaMemcpyHostToDevice);

    cudaMemcpy(dev_b, b, size * sizeof(int), cudaMemcpyHostToDevice);

    //testThread1<<<1, size>>>(dev_c, dev_a, dev_b);

    //uint3 s;s.x = size/5;s.y = 5;s.z = 1;

    //testThread2 <<<1,s>>>(dev_c, dev_a, dev_b);

    //uint3 s; s.x = size / 10; s.y = 5; s.z = 2;

    //testThread3<<<1, s >>>(dev_c, dev_a, dev_b);

    //testBlock1<<<size,1 >>>(dev_c, dev_a, dev_b);

    //uint3 s; s.x = size / 5; s.y = 5; s.z = 1;

    //testBlock2<<<s, 1 >>>(dev_c, dev_a, dev_b);

    //uint3 s; s.x = size / 10; s.y = 5; s.z = 2;

    //testBlock3<<<s, 1 >>>(dev_c, dev_a, dev_b);

    //testBlockThread1<<<size/10, 10>>>(dev_c, dev_a, dev_b);

    //uint3 s1; s1.x = size / 100; s1.y = 1; s1.z = 1;

    //uint3 s2; s2.x = 10; s2.y = 10; s2.z = 1;

    //testBlockThread2 << <s1, s2 >> >(dev_c, dev_a, dev_b);

    //uint3 s1; s1.x = size / 100; s1.y = 1; s1.z = 1;

    //uint3 s2; s2.x = 10; s2.y = 5; s2.z = 2;

    //testBlockThread3 << <s1, s2 >> >(dev_c, dev_a, dev_b);

    //uint3 s1; s1.x = 10; s1.y = 10; s1.z = 1;

    //uint3 s2; s2.x = size / 100; s2.y = 1; s2.z = 1;

    //testBlockThread4 << <s1, s2 >> >(dev_c, dev_a, dev_b);

    //uint3 s1; s1.x = 10; s1.y = 5; s1.z = 2;

    //uint3 s2; s2.x = size / 100; s2.y = 1; s2.z = 1;

    //testBlockThread5 << <s1, s2 >> >(dev_c, dev_a, dev_b);

    //uint3 s1; s1.x = size / 100; s1.y = 10; s1.z = 1;

    //uint3 s2; s2.x = 5; s2.y = 2; s2.z = 1;

    //testBlockThread6 << <s1, s2 >> >(dev_c, dev_a, dev_b);

    //uint3 s1; s1.x = size / 100; s1.y = 5; s1.z = 1;

    //uint3 s2; s2.x = 5; s2.y = 2; s2.z = 2;

    //testBlockThread7 << <s1, s2 >> >(dev_c, dev_a, dev_b);

    //uint3 s1; s1.x = 5; s1.y = 2; s1.z = 2;

    //uint3 s2; s2.x = size / 100; s2.y = 5; s2.z = 1;

    //testBlockThread8 <<<s1, s2 >>>(dev_c, dev_a, dev_b);

    uint3 s1; s1.x = ; s1.y = ; s1.z = ;

    uint3 s2; s2.x = size / ; s2.y = ; s2.z = ;

    testBlockThread9<<<s1, s2 >>>(dev_c, dev_a, dev_b);

    cudaMemcpy(c, dev_c, size*sizeof(int), cudaMemcpyDeviceToHost);

    cudaFree(dev_a);

    cudaFree(dev_b);

    cudaFree(dev_c);

    cudaGetLastError();

}

int main()

{

    const int n = ;

    int *a = new int[n];

    int *b = new int[n];

    int *c = new int[n];

    int *cc = new int[n];

    for (int i = ; i < n; i++)

    {

        a[i] = rand() % ;

        b[i] = rand() % ;

        c[i] = b[i] - a[i];

    }

    addWithCuda(cc, a, b, n);

    FILE *fp = fopen("out.txt", "w");

    for (int i = ; i < n; i++)

        fprintf(fp, "%d %d\n", c[i], cc[i]);

    fclose(fp);

    bool flag = true;

    for (int i = ; i < n; i++)

    {

        if (c[i] != cc[i])

        {

            flag = false;

            break;

        }

    }

    if (flag == false)

        printf("no pass");

    else

        printf("pass");

    cudaDeviceReset();

    delete[] a;

    delete[] b;

    delete[] c;

    delete[] cc;

    getchar();

    return ;

}
这里只保留了3D-3D方式,注释了其余14种方式,所有索引方式均测试通过。
还是能看出一些规律的:)
cuda中threadIdx、blockIdx、blockDim和gridDim的使用的更多相关文章
- GPU CUDA编程中threadIdx, blockIdx, blockDim, gridDim之间的区别与联系
前期写代码的时候都会困惑这个实际的threadIdx(tid,实际的线程id)到底是多少,自己写出来的对不对,今天经过自己一些小例子的推敲,以及找到官网的相关介绍,总算自己弄清楚了. 在启动kerne ...
- CUDA中的常量内存__constant__
GPU包含数百个数学计算单元,具有强大的处理运算能力,可以强大到计算速率高于输入数据的速率,即充分利用带宽,满负荷向GPU传输数据还不够它计算的.CUDA C除全局内存和共享内存外,还支持常量内存,常 ...
- CUDA中关于C++特性的限制
CUDA中关于C++特性的限制 CUDA官方文档中对C++语言的支持和限制,懒得每次看英文文档,自己尝试翻译一下(没有放lambda表达式的相关内容,太过于复杂,我选择不用).官方文档https:// ...
- CUDA中并行规约(Parallel Reduction)的优化
转自: http://hackecho.com/2013/04/cuda-parallel-reduction/ Parallel Reduction是NVIDIA-CUDA自带的例子,也几乎是所有C ...
- OpenCV二维Mat数组(二级指针)在CUDA中的使用
CUDA用于并行计算非常方便,但是GPU与CPU之间的交互,比如传递参数等相对麻烦一些.在写CUDA核函数的时候形参往往会有很多个,动辄达到10-20个,如果能够在CPU中提前把数据组织好,比如使用二 ...
- cuda中当数组数大于线程数的处理方法
参考stackoverflow一篇帖子的处理方法:https://stackoverflow.com/questions/26913683/different-way-to-index-threads ...
- CUDA中多维数组以及多维纹理内存的使用
纹理存储器(texture memory)是一种只读存储器,由GPU用于纹理渲染的图形专用单元发展而来,因此也提供了一些特殊功能.纹理存储器中的数据位于显存,但可以通过纹理缓存加速读取.在纹理存储器中 ...
- cuda中当元素个数超过线程个数时的处理案例
项目打包下载 当向量元素超过线程个数时的情况 向量元素个数为(33 * 1024)/(128 * 128)=2.x倍 /* * Copyright 1993-2010 NVIDIA Corporati ...
- CUDA中使用多维数组
今天想起一个问题,看到的绝大多数CUDA代码都是使用的一维数组,是否可以在CUDA中使用一维数组,这是一个问题,想了各种问题,各种被77的错误状态码和段错误折磨,最后发现有一个cudaMallocMa ...
随机推荐
- python _、__、__xx__之间的差别
默认情况下,Python中的成员函数和成员变量都是公开的(public),在python中没有类public,private等关键词来修饰成员函数和成员变量.其实,Python并没有真正的私有化支持, ...
- 读书笔记(03) - 性能 - JavaScript高级程序设计
作用域链查找 作用域链的查找是逐层向上查找.查找的层次越多,速度越慢.随着硬件性能的提升和浏览器引擎的优化,这个慢我们基本可以忽略. 除了层级查找损耗的问题,变量的修改应只在局部环境进行,尽量避免在局 ...
- 【原】ATI显卡设置双显示器
Ubuntu 12.04系统下加上增加一个显示器后,一直只能镜像显示,或只能用笔记本的屏幕显示,另一个屏幕无法使用了,上网搜索了一下解决办法,通过下面的方法可以解决问题: 编辑/etc/X11/xor ...
- MathType试用期到了如何继续用
1,卸载原来的MathType(不知道需不需要,其实删不删应该无所谓吧) 2,删除注册表中的一个值(不是默认,而是另外一个值) HKEY_CURRENT_USER\Software\Install O ...
- 制作openstack使用的Ubuntu镜像
一.环境准备 OS:Ubuntu-14.04 制作镜像版本:Ubuntu-14.04.4-server-amd64.iso 查看是否支持虚拟化(有输出代表支持,否则在BIOS页面中设置即可): egr ...
- TensorFlow-实战Google深度学习框架 笔记(上)
TensorFlow TensorFlow 是一种采用数据流图(data flow graphs),用于数值计算的开源软件库.在 Tensorflow 中,所有不同的变量和运算都是储存在计算图,所以在 ...
- 读jQuery源码释疑笔记2
本释疑笔记是针对自己在看源码的过程中遇到的一些问题的解答,对大众可能不具有参考性,不过可以看看有没有你也不懂得地方,相互学习,相互进步. 1.函数init <div id="one&q ...
- Spring学习之路-从入门到放弃
后台框架是真难入门啊!!!IDE的使用,环境的搭建,框架下载,上手,每一步都恶心人. 花了整整两天,才学会用idea,并且初步了解了maven(TM就是一个npm),然后跟着下载了对应的jar包,搭建 ...
- MVC应用程序JsonResult()的练习
这次学习MVC应用程序,尝试使用jQuery的获取数据,并显示于视图上,关键技术还是javascript的一个子集Json.我们先去HomeController写一个方法JsonResult GetJ ...
- c#中Socket网络通信的入门
请访问 http://balabiu.com/?p=16 后续本文更新将在这里: 将设计服务器端异步接受客户端连接和客户端消息.