
ELK+Beats日志分析系统部署
一、 名词介绍:
E:ElasticSearch 搜索,简称es
L:Logstash 管理日志和事件的工具
K:Kibana 功能强大的数据显示客户端
Beats 轻量级数据传输组件,这里我们主要使用FileBeat
二、 应用包准备:
elasticsearch-6.1.2.tar.gz
logstash-6.1.2.tar.gz
kibana-6.1.2-linux-x86_64.tar.gz
filebeat-6.1.2-linux-x86_64.tar.gz
jdk-7 以上
三、 部署安装:
1.集群部署

如果logstash 压力很大,那么可以考虑filebeat 和logstash 之间引入redis或kafka作为缓冲。
以后可以使用集群部署,目前先采用如下部署方式:
elasticsearch+ logstash+ kibana 于同一台机器,假设ip为:192.168.1.228
filebeat 和应用服务器或其他需要做日志处理的服务器一起部署
2. 安装JDK 1.7
省略安装步骤,推荐1.7+版本以上
java –version
设置java的环境变量,比如
vim ~/.bashrc
>>
export JAVA_HOME= /home/xiel/Java/jdk1.7.0_45
export JRE_HOME=${JAVA_HOME}/jre
export CLASSPATH=.:${JAVA_HOME}/lib:${JRE_HOME}/lib
export PATH=${JAVA_HOME}/bin:$PATH
>>
source ~/.bashrc
3. 搭建ElasticSearch
安装
解压elasticsearch tar.gz 即可
配置
进入 安装目录,修改conf/ elasticsearch.yml :
修改network.host 为本机ip,如:
network.host: 192.168.1.228
其他:
cluster.name: hyxt_logs_es (集群名称)
node.name: "node1"(集群结点名称)
node.master: true(是否可被选为主结点,默认true)
node.data: true(结点是否存储数据,默认true)
index.number_of_shards: 5(索引分片数)
index.number_of_replicas: 1(索引副本数)
transport.tcp.port: 9300(数据传输IP)
http.port: 9200(对外访问监听IP)
启动
./ bin/elasticsearch -d (-d:后台启动)
测试验证
执行 curl -X GET http://192.168.1.228:9200
{
"name" : "node-1",
"cluster_name" : "hyxt_logs_es",
"cluster_uuid" : "l_31dzUURiWnLUAI60Zm8w",
"version" : {
"number" : "6.1.2",
"build_hash" : "5b1fea5",
"build_date" : "2018-01-10T02:35:59.208Z",
"build_snapshot" : false,
"lucene_version" : "7.1.0",
"minimum_wire_compatibility_version" : "5.6.0",
"minimum_index_compatibility_version" : "5.0.0"
},
"tagline" : "You Know, for Search"
}
表示安装配置成功。
常用基本命令:
查询所有数据:curl http://192.168.1.228:9200/_search?pretty
集群健康状态:curl -XGET http://192.168.1.228:9200/_cluster/health?pretty
删除所有数据:curl -X DELETE 'http://192.168.1.228:9200/_all'
删除指定索引:curl -X DELETE 'http://192.168.1.228:9200/索引名称'
注: 这里最好不要使用localhost,因为我们需要远程访问,所以,我们应该直接使用对应服务器的ip地址
elasticsearch 集群部署:
elasticsearch 配置集群很简单,基本只要简单修改。我们修改elasticsearch.yml文件:
使得:cluster.name 相同和 node.name 唯一就ok了!
4. 搭建Logstash
安装
解压logstash tar.gz
配置
进入安装目录,为logstash新建一个配置文件config/hy_logstash.conf:
vi hy_logstash.conf
配置文件内容如下
input {
beats {
port => 5044
# sincedb_path => "/app/logstash-5.1.1/.sincedb"
}
}
filter {
if [type] == "app_test" {
grok {
match => { "message" => "((?<logdate>%{YEAR}-%{MONTHNUM}-%{MONTHDAY} %{HOUR}:?%{MINUTE}(?::?%{SECOND})) %{WORD:level} (?<srcCode>\[(?:[a-zA-Z0-9-])+\]\[(?:[a-zA-Z0-9-\.])+:%{NUMBER}\]) - )?(?<srcLog>.+)" }
}
mutate {remove_field => [ "@timestamp", "@version", "message" ] }
} else if [type] == "mysql_test" {
grok {
match => { "message" => "((?<logdate>%{YEAR}-%{MONTHNUM}-%{MONTHDAY} %{HOUR}:?%{MINUTE}(?::?%{SECOND})) %{WORD:level} (?<srcCode>\[(?:[a-zA-Z0-9-])+\]\[(?:[a-zA-Z0-9-\.])+:%{NUMBER}\]) - )?(?<srcLog>.+)" }
}
mutate {remove_field => [ "@version", "message" ] }
} else if [type] == "nginx_access_test" {
grok {
match => { "message" => "MAINNGINXLOG %{COMBINEDAPACHELOG} %{QS:x_forwarded_for}" }
# mutate {remove_field => [ "@timestamp", "@version", "message" ] }
}
}
date {
match => ["logdate", "yyyy-MM-dd HH:mm:ss.SSS"]
}
if "_grokparsefailure" in [tags] {
} else {
mutate {remove_field => [ "logdate", "@version", "message" ] }
}
if !([level]) {
mutate {
add_field => { "level" => "other" }
}
}
}
output {
if "_grokparsefailure" in [tags] {
file { path => "/var/log/logstash/grokparsefailure-%{type}-%{+YYYY.MM.dd}.log" }
}
elasticsearch {
hosts => ["ES_IP:9200"]
index => "hy_log_%{type}-%{+YYYY.MM.dd}"
document_type => "%{type}"
template_overwrite => true
}
}
配置文件 必须要以”.conf“以尾缀。上面的文件部分配置了 应用日志,mysql日志,nginx访问日志,nginx错误日志
ES_IP 为安装elasticsearch 服务器的ip
启动
nohup ./bin/logstash -f config/ hy_logstash.conf &
5. 搭建Kibana
安装
解压kibana tar.gz
配置
进入安装目录,默认配置文件为:config/kibana.yml。可以修改kibana.yml必须要正确配置elasticsearch的地址和索引:
主要修改的地方:
server.host: "192.168.1.228"
elasticsearch.url: "http://192.168.1.228:9200"
启动
nohup ./bin/kibana &。
测试验证
登录访问:http://192.168.1.228:5601(默认端口为5601)
6. 搭建FileBeat
安装
解压filebeat tar.gz
配置
进入安装目录,默认配置文件为:filebeat.yml:
配置如下:
- type: log
filebeat.prospectors:
- type: log # 应用日志
fields_under_root: true
fields:
app_id: el_shop_1
type: app_test
paths:
- /www/tomcat-demo/logs/catalina.out
multiline: # 多行合并,将\s+at \w开头的行追加到前一行末尾
pattern: '^\s+at \w'
negate: false
match: after
- type: log # mysql慢查询日志
fields_under_root: true
fields:
app_id: mysql-slow
type: beat_test
paths:
- /usr/local/filebeat-6.1.2-linux-x86_64/slow.log
multiline: # 多行合并
pattern: '^\# User@Host\: '
negate: true
match: after
timeout: 10s
- type: log # nginx访问日志
fields_under_root: true
fields:
app_id: nginx
type: nginx_access
paths:
- /usr/local/filebeat-6.1.2-linux-x86_64/access.log
multiline: # 多行合并
pattern: '^(\d{1,3}){4} \- \- \['
negate: true
match: after
timeout: 10s
- type: log # nginx错误日志
fields_under_root: true
fields:
app_id: nginx
type: nginx_error
paths:
- /usr/local/filebeat-6.1.2-linux-x86_64/error.log
multiline: # 多行合并
pattern: '^\d{4}/\d{2}/\d{2} '
negate: true
match: after
timeout: 10s
output.logstash:
enabled: true
hosts: ["192.168.1.228:5044"]
index: app-%{[type]}
compression_level: 3
#loadbalance: true
注:
上面的文件部分配置了 应用日志,mysql日志,nginx访问日志,nginx错误日志
默认的index 跟踪文件是:data/registry
启动
nohup ./ filebeat &
7. 搭建X-Pack
安装Xpach之前必须先安装好es和kibana
You must install Elasticsearch and Kibana before you install X-Pack. If you plan to use the X-Pack features in Logstash, you must also install Logstash before you install X-Pack
然后分别在es,kibana中安装xpack插件:
es中安装xpack插件
进入es安装目录,执行:
bin/elasticsearch-plugin install x-pack
安装过程中,我们需要进行一些配置,默认统统输入y即可
参考:
https://www.elastic.co/guide/en/elasticsearch/reference/6.2/installing-xpack-es.html
安装完毕需要重启es
kibana中安装xpack插件
进入kibana安装目录,执行:
bin/kibana-plugin install x-pack
参考:
https://www.elastic.co/guide/en/kibana/6.2/installing-xpack-kb.html
安装完毕需要重启kibana
logstash中安装xpack插件(可选)
进入logstash安装目录,执行:
bin/logstash-plugin install x-pack
参考:
https://www.elastic.co/guide/en/logstash/6.2/installing-xpack-log.html
安装完毕需要重启logstash
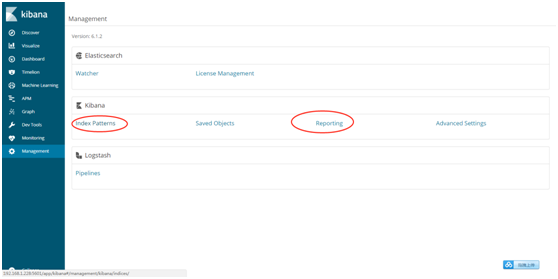
四、 使用Kibana:
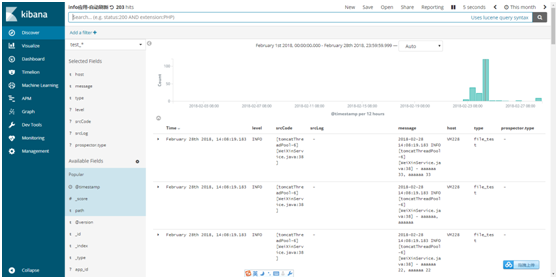
Discover 标签页用于交互式探索你的数据
Visualize 标签页用来设计可视化。你可以保存可视化,以后再用,或者加载合并到dashboard 里。一个可视化可以基于以下几种数据源类型

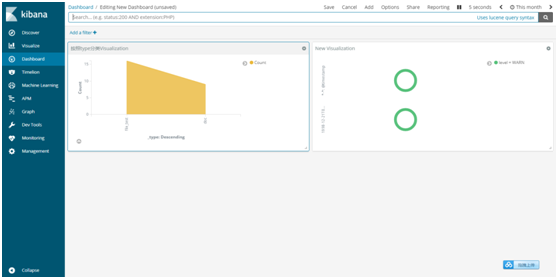
Dashboard 能让你自由排列一组已保存的可视化。然后你可以保存这个仪表板,用来分享或者重载
Timelion一个崭新的 pipeline aggregation 特性

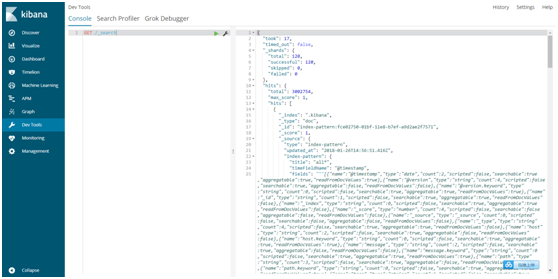
Dev tools 开发工具
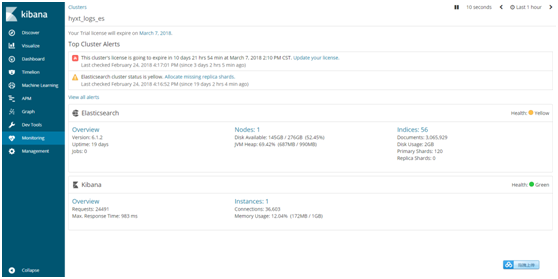
监控:
管理:
ELK+Beats日志分析系统部署的更多相关文章
- [原创]ubuntu14.04部署ELK+redis日志分析系统
ubuntu14.04部署ELK+redis日志分析系统 [环境] host1:172.17.0.4 搭建ELK+redis服务 host2:172.17.0.3 搭建logstash+nginx服务 ...
- ELK + Filebeat 日志分析系统
ELK + Filebeat 日志分析系统 架构图 环境 OS:CentOS 7.4 Filebeat: 6.3.2 Logstash: 6.3.2 Elasticsearch 6.3.2 Kiban ...
- docker:搭建ELK 开源日志分析系统
ELK 是由三部分组成的一套日志分析系统, Elasticsearch: 基于json分析搜索引擎,Elasticsearch是个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片 ...
- ELK日志分析系统部署
======================================================================================= 操作系统 IP地址 主机 ...
- elk实时日志分析平台部署搭建详细实现过程
原文:http://blog.csdn.net/mchdba/article/details/52132663 1.ELK平台介绍 在搜索ELK资料的时候,发现这篇文章比较好,于是摘抄一小段:以下内容 ...
- springboot+ELK+logback日志分析系统demo
之前写的有点乱,这篇整理了一下搭建了一个简单的ELK日志系统 借鉴此博客完成:https://blog.csdn.net/qq_22211217/article/details/80764568 设置 ...
- ELK 集中日志分析 windows部署实战
一步步来 1.下载软件 Elasticsearch: https://download.elasticsearch.org/...p/elasticsearch/2.0.0/elasticsearch ...
- filebeat+redis+logstash+elasticsearch+kibana搭建日志分析系统
filebeat+redis+elk搭建日志分析系统 官网下载地址:https://www.elastic.co/downloads 1.下载安装filebeat wget https://artif ...
- ELK日志分析系统简单部署
1.传统日志分析系统: 日志主要包括系统日志.应用程序日志和安全日志.系统运维和开发人员可以通过日志了解服务器软硬件信息.检查配置过程中的错误及错误发生的原因.经常分析日志可以了解服务器的负荷,性能安 ...
随机推荐
- 《JavaScript Dom 编程艺术》读书笔记-第7章
动态创建标记~内容包括: 1. 传统技术:document.write 和innerHTML 2. 深入剖析DOM方法:createElemen.createTextNode.appendChild和 ...
- HDU1171将多个不同价值不同数量的器材尽可能按等价值均分 第一份的价值尽可能的大 所以sum/2对第二份进行01背包 使其价值尽可能的大
//hdu1171void solve(){ for(int i=1;i<=n;i++) { for(int j=W;j>=w[i];j--) { dp[j]=max(dp[j],dp[j ...
- setfacl语法2
setfacl命令可以用来细分linux下的文件权限. chmod命令可以把文件权限分为u,g,o三个组,而setfacl可以对每一个文件或目录设置更精确的文件权限. 换句话说,setfacl可以更精 ...
- sed语法2
sed命令是一个面向字符流的非交互式编辑器,也就是说sed不允许用户与它进行交互操作.sed是按行来处理文本内容的.在shell中,使用sed来批量修改文本内容是非常方便的. sed命令的选项 sed ...
- css的性质
css两个性质: 1.继承性 2.层叠行(选择器的一种选择能力,谁的权重大就选谁) A.选不中,走继承性,(font系列.color.text系列)权重是0 a)有多个父级都设置了这样的样式 走就 ...
- ReactiveCocoa进阶
1.ReactiveCocoa常见操作方法介绍. 1.1 ReactiveCocoa操作须知 所有的信号(RACSignal)都可以进行操作处理,因为所有操作方法都定义在RACStream.h中,而R ...
- Python多进程并发操作中进程池Pool的应用
Pool类 在使用Python进行系统管理时,特别是同时操作多个文件目录或者远程控制多台主机,并行操作可以节约大量的时间.如果操作的对象数目不大时,还可以直接使用Process类动态的生成多个进程,十 ...
- webpack配置文件--(loader)
这篇写的很详细 https://segmentfault.com/a/1190000012718374#articleHeader9 主要的配置项: test:必须 匹配需要处理的文件的扩展名 use ...
- lvm创建和在线扩容
添加磁盘后创建lvm lsblk 或是fdisk -l 查看添加的磁盘 fdisk -l lsblk 进入到sdb创建分区 n新建p标准分区e扩展分区1序列号 加10G或全给 p查看 要创建lv ...
- OpenCV3 SVM ANN Adaboost KNN 随机森林等机器学习方法对OCR分类
转摘自http://www.cnblogs.com/denny402/p/5032839.html opencv3中的ml类与opencv2中发生了变化,下面列举opencv3的机器学习类方法实例: ...