
scrapy初探(一)-斗鱼TV直播信息抓取
由于有相关需求,最近两天开始学了一下scrapy
这次我们就以爬取斗鱼直播间为例,我们准备爬取斗鱼所有的在线直播信息,
包括1.主播昵称 2.直播领域 3.所在页面数 4.直播观看人数 5.直播间url
开始准备爬取的页面如图
url为:https://www.douyu.com/directory/all

但实际经过查看发现翻页是由ajax响应的,实际的ajax页面为:
https://www.douyu.com/directory/all?page=1&isAjax=1
其中page即为页面数
我们所需要的信息也在页面中,所以直接爬取该页面即可,
先编辑items.py
class ProjectItem(scrapy.Item):

    title=scrapy.Field()

    user=scrapy.Field()

    num=scrapy.Field()

    area=scrapy.Field()

    zhibojian=scrapy.Field()

    index=scrapy.Field()
接着编写spider.py,其中思路比较简单,回调函数即为parse本身,由于网站当页面超过实际页面时,显示的是第一页信息,而且页面是动态的,所以我们对第一页的zhibojian信息保存,保存在box中,并对index>30时进行判断,一旦直播间信息出现在box中,说明为第一页了。
index=1
box=[]

def handlenum(char):
    if u'万' in char[0]:
        char[0] = str(float(char[0].replace(u'万', '')) * 10000)
    return char

class newspider(scrapy.Spider):
    name='ajax'
    allowed_domains = ["www.douyu.com", 'douyucdn.cn']
    start_urls = ["https://www.douyu.com/directory/all?page=1&isAjax=1"]

    def parse(self, response):
        global index,box
        selector=Selector(response)
        for sel in selector.xpath('/html/body/li'):
            item=ProjectItem()
            item['title']=sel.xpath('a/@title').extract()
            item['user']=sel.xpath('a/div/p/span[1]/text()').extract()
            num=sel.xpath('a/div/p/span[2]/text()').extract()
            item['num'] =handlenum(num)
            item['area']=sel.xpath('a/div/div/span/text()').extract()
            zhibojian=sel.xpath('a/@href').extract()
            if index is 1:
                box.append(zhibojian[0])
            elif index>20:
                if zhibojian[0] in box:
                    return
            item['zhibojian']=zhibojian
            item['index']=index
            yield item
        index+=1
        nexturl='https://www.douyu.com/directory/all?page=%s&isAjax=1'%str(index)
        yield scrapy.Request(nexturl,callback=self.parse)
最后设置setting.py,这里我们使用csv格式来保存
FEED_URI=u'file:///C:/Users/tLOMO/Desktop/one.csv'

FEED_FORMAT='CSV'
最后运行即可得到one.csv
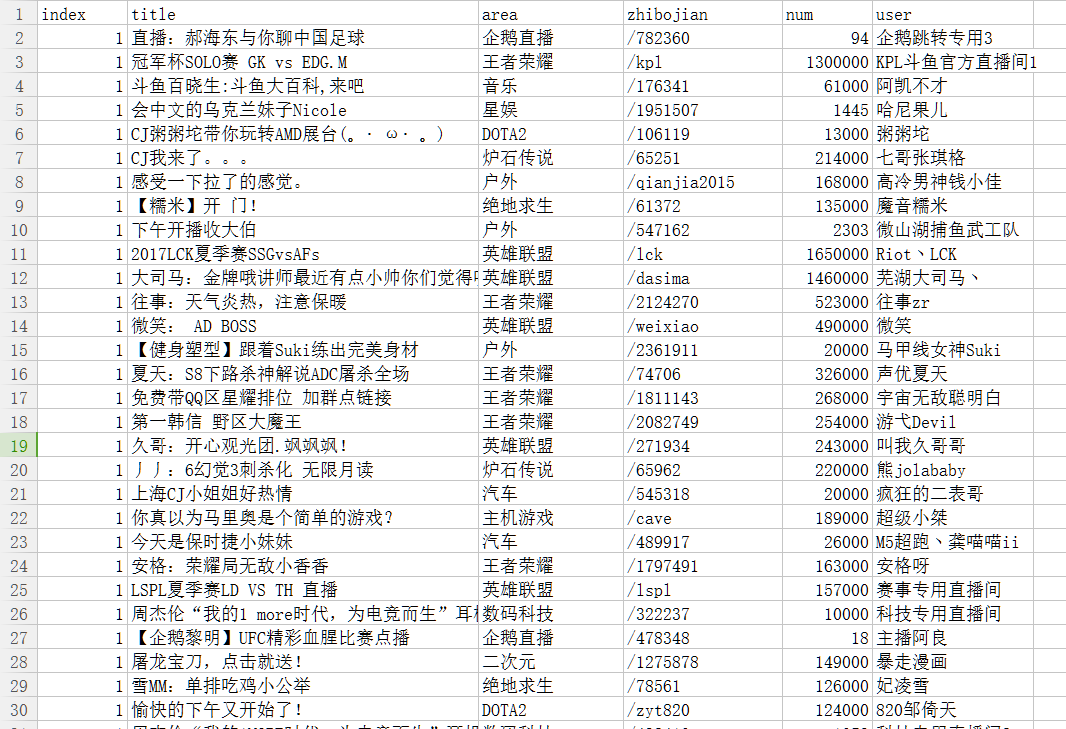
进过统计,我程序跑的时候,所有观看直播的人数为18290373,这个数字可信度我也搞不清啊,简单看了一下,所有的直播中直播农药和LOL的是最多的
scrapy初探(一)-斗鱼TV直播信息抓取的更多相关文章
- [转载]Fiddler为所欲为第四篇 直播源抓取与接口分析 [四]
今天的教程,主要是教大家如何进行“封包逆向”,关键词跳转,接口分析.(怎么样,是不是感觉和OD很像~~~)今天的教程我们以[麻花影视]为例,当然,其他APP的逻辑也是一样,通用的哦~ 首先需要做好准备 ...
- 网页信息抓取进阶 支持Js生成数据 Jsoup的不足之处
转载请标明出处:http://blog.csdn.net/lmj623565791/article/details/23866427 今天又遇到一个网页数据抓取的任务,给大家分享下. 说道网页信息抓取 ...
- Ajax异步信息抓取方式
淘女郎模特信息抓取教程 源码地址: cnsimo/mmtao 网址:https://0x9.me/xrh6z 判断一个页面是不是Ajax加载的方法: 查看网页源代码,查找网页中加载的数据信息,如果 ...
- Atitit.web的自动化操作与信息抓取 attilax总结
Atitit.web的自动化操作与信息抓取 attilax总结 1. Web操作自动化工具,可以简单的划分为2大派系: 1.录制回放 2.手工编写0 U' z; D! s2 d/ Q! ^1 2. 常 ...
- 网页信息抓取 Jsoup的不足之处 httpunit
今天又遇到一个网页数据抓取的任务,给大家分享下. 说道网页信息抓取,相信Jsoup基本是首选的工具,完全的类JQuery操作,让人感觉很舒服.但是,今天我们就要说一说Jsoup的不足. 1.首先我们新 ...
- 网易新闻页面信息抓取(htmlagilitypack搭配scrapysharp)
转自原文 网易新闻页面信息抓取(htmlagilitypack搭配scrapysharp) 最近在弄网页爬虫这方面的,上网看到关于htmlagilitypack搭配scrapysharp的文章,于是决 ...
- 接口测试——fiddler对soapui请求返回信息抓取
原文:接口测试——fiddler对soapui请求返回信息抓取 背景:接口测试的时候,需要对接口的请求和返回信息进行查阅或者修改请求信息,可利用fiddler抓包工具对soapui的请求数据进行抓取或 ...
- Scrapy爬虫框架教程(四)-- 抓取AJAX异步加载网页
欢迎关注博主主页,学习python视频资源,还有大量免费python经典文章 sklearn实战-乳腺癌细胞数据挖掘 https://study.163.com/course/introduction ...
- Windows Phone & Windows App应用程序崩溃crash信息抓取方法
最近有用户反馈,应用有崩溃的情况,可是本地调试却无法重现问题,理所当然的,我想到了微软的开发者仪表盘,可以查看一段时间内的carsh记录,不过仪表盘生成carsh记录不是实时的,而且生成的报告查看非常 ...
随机推荐
- C++ WINDOWS 防多开
我们有些程序是可以同时运行多个进程,典型的像Visual Studio.但有些就能一次运行一个进程.比如Outlook.那你可能会问啥时可以让它同时打开多个应用程序,啥时只能一个啊.这个主要看进程间是 ...
- 论文笔记【一】Chinese NER Using Lattice LSTM
论文:Chinese NER Using Lattice LSTM 论文链接:https://arxiv.org/abs/1805.02023 论文作者:Yue Zhang∗and Jie Yang∗ ...
- javascript Template tmpl
前两天写前端遇到很多table 和 表单需要拼接的问题 , 一堆的字符串 , 页面显得冗长,又不好维护.于是有了下文. 话不多说,上代码: 首先引用一个js文件: <script src=&qu ...
- iOS UIAlertController在iPhone与iPad上的区别
很简单的一段代码: // 首先声明一个UIAlertController对象 private var alertController: UIAlertController! // 初始化UIAlert ...
- FSMC_LCD
1. TFT-LCD(Thin Film Transistor Liquid Crystal Display)[薄膜晶体管液晶显示器] 2. 液晶 物质在熔融状态或在溶液状态下虽然获得了液体物质的流动 ...
- 2018年12月25日 圣诞节快乐 生成器plus
import time#导入时间模块 time.sleep(5)#输入间隔时间5秒 def p_bz():#使用函数 生产包子 for i in range(100): yield "包子% ...
- UVA11019 Matrix Matcher
思路 AC自动机匹配二维模式串的题目 因为如果矩形匹配,则每一行都必须匹配,考虑对于一个点,设count[i][j]记录以它为左上角的与模式矩形大小相同的矩形中有多少行和模式矩形匹配 然后把模式矩形的 ...
- 论文笔记:Visual Question Answering as a Meta Learning Task
Visual Question Answering as a Meta Learning Task ECCV 2018 2018-09-13 19:58:08 Paper: http://openac ...
- python链接Hive
之前一直用thrift链接Hive,但在运行时总出现问题,一直报缺少模块的错误,装了这个模块,又报缺少那个模块,连了半天,全是泪啊! 原来thrift链接Hive的.py文件后续没人维护,是连不上的. ...
- Learning-Python【2】:简单介绍Python基本数据类型及程序交互
人类可以很容易的分清数字与字符的区别,但是计算机并不能,计算机虽然很强大,但在某些方面很笨,你得明确的告诉它,“1”是数字,“我”是文字.否则计算机是分不清的.因此,在每个编程语言中都会有数据类型的概 ...