
【spark】示例:二次排序
我们有这样一个文件
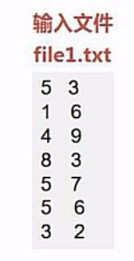
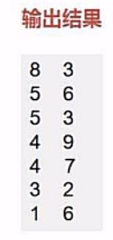
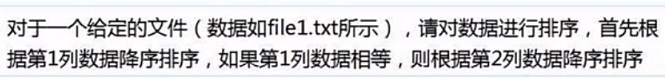
首先我们的思路是把输入文件数据转化成键值对的形式进行比较不就好了嘛!
但是你要明白这一点,我们平时所使用的键值对是不具有比较意义的,也就说他们没法拿来直接比较。
我们可以通过sortByKey,sortBy(pair._2)来进行单列的排序,但是没法进行两列的同时排序。
那么我们该如何做呢?
我们可以自定义一个键值对的比较类来实现比较,
类似于JAVA中自定义类实现可比较性实现comparable接口。
我们需要继承Ordered和Serializable特质来实现自定义的比较类。
1.读取数据创建rdd
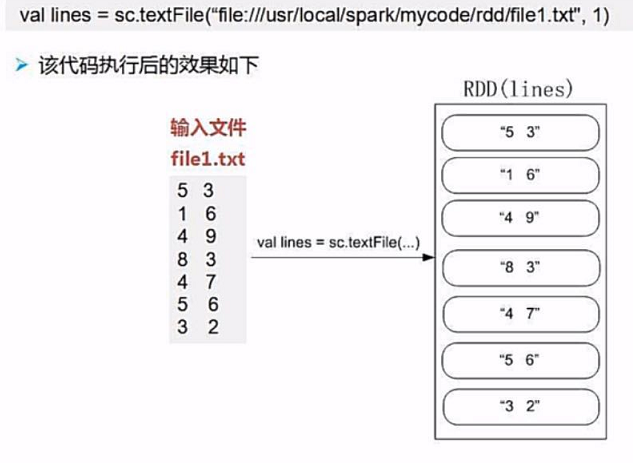
2.根据要求来定义比较类
任务要求,先根据key进行排序,相同再根据value进行排序。
我们可以把键值对当成一个数据有两个数字,先通过第一个数字比大小,再通过第二个数字比大小。
(1)我们定义两个Int参数的比较类
(2)继承Ordered 和 Serializable 接口 实现 compare 方法实现可以比较
class UDFSort (val first:Int,val second:Int) extends Ordered[UDFSort] with Serializable {

    override def compare(that: UDFSort): Int = {

        if(this.first - that.first != 0){//第一个值不相等的时候,直接返回大小

            this.first - that.first //返回值

        }

        else {//第一个值相等的时候,比较第二个值

            this.second - that.second

        }

    }

}
其实,懂java的人能看出来这个跟实现comparable很类似。
3.处理rdd
我们将原始数据按照每行拆分成一个含有两个数字的数组,然后传入我们自定义的比较类中
不是可以通过UDFSort就可以比较出结果了吗,
但是我们不能把结果给拆分掉,也就是说,我们只能排序,不能改数据。
我们这样改怎么办?
我们可以生成键值对的形式,key为UDFSort(line(0),line(1)),value为原始数据lines。
这样,我们通过sortByKey就能完成排序,然后通过取value就可以保持原始数据不变。
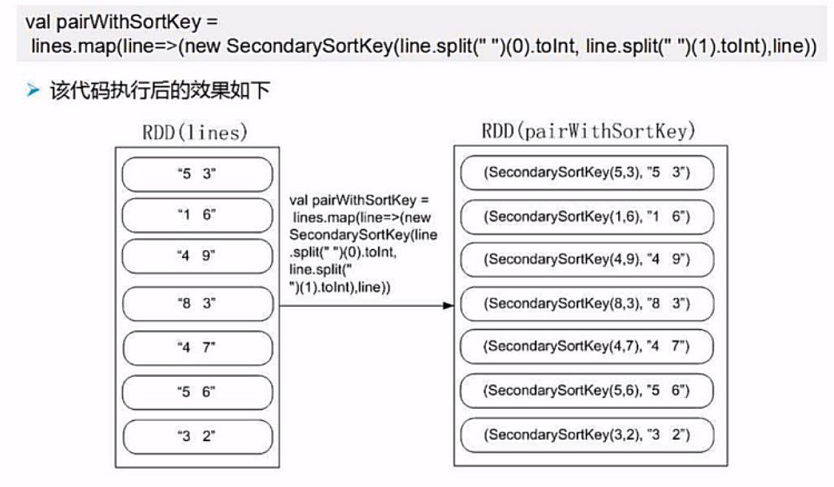
4.排序取结果
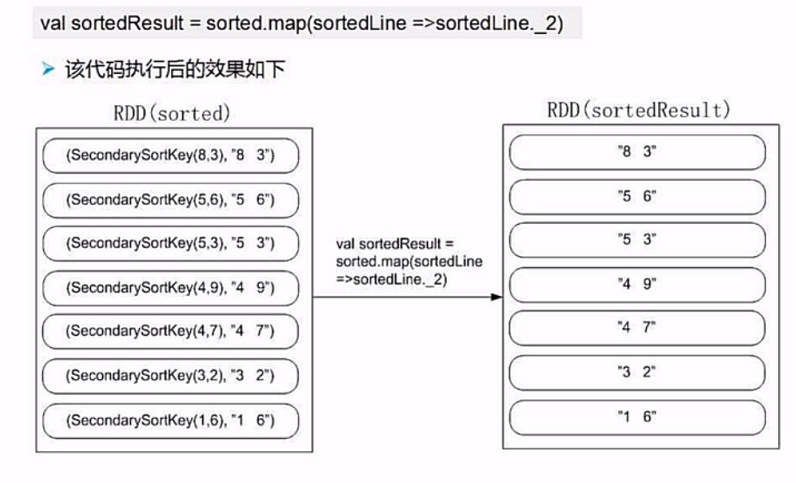
完整代码
package SparkDemo

import org.apache.spark.{SparkConf, SparkContext}

class UDFSort (val first:Int,val second:Int) extends Ordered[UDFSort] with Serializable {//自定义比较类

    override def compare(that: UDFSort): Int = {

        if(this.first - that.first != 0){//第一个值不相等的时候,直接返回大小

            this.first - that.first //返回值

        }

        else {//第一个值相等的时候,比较第二个值

            this.second - that.second

        }

    }

}

object Sort{

    def main(args:Array[String]): Unit ={

        //初始化配置:设置主机名和程序主类的名字

        val conf = new SparkConf().setAppName("UdfSort");

        //通过conf来创建sparkcontext

        val sc = new SparkContext(conf);

        val lines = sc.textFile("file:///...")

        //转换为( udfsort( line(0),line(1) ),line ) 的形式

        val pair = lines.map(line => (new UDFSort(line.split(" ")(0).toInt,line.split(" ")(1).toInt),line))

        //对key进行排序,然后取value

        val result = pair.sortByKey().map( x => x._2)

    }

}
【spark】示例:二次排序的更多相关文章
- 分别使用Hadoop和Spark实现二次排序
零.序(注意本部分与标题无太大关系,可直接调至第一部分) 既然没用为啥会有序?原因不想再开一篇文章,来抒发点什么感想或者计划了,就在这里写点好了: 前些日子买了几本书,打算学习和研究大数据方面的知识, ...
- spark的二次排序
通过scala实现二次排序 package _core.SortAndTopN import org.apache.spark.{SparkConf, SparkContext} /** * Auth ...
- Spark实现二次排序
一.代码实现 package big.data.analyse.scala.secondsort import org.apache.log4j.{Level, Logger} import org. ...
- Spark基础排序+二次排序(java+scala)
1.基础排序算法 sc.textFile()).reduceByKey(_+_,).map(pair=>(pair._2,pair._1)).sortByKey(false).map(pair= ...
- spark函数sortByKey实现二次排序
最近在项目中遇到二次排序的需求,和平常开发spark的application一样,开始查看API,编码,调试,验证结果.由于之前对spark的API使用过,知道API中的sortByKey()可以自定 ...
- 详细讲解MapReduce二次排序过程
我在15年处理大数据的时候还都是使用MapReduce, 随着时间的推移, 计算工具的发展, 内存越来越便宜, 计算方式也有了极大的改变. 到现在再做大数据开发的好多同学都是直接使用spark, hi ...
- Spark(二)算子详解
目录 Spark(二)算子讲解 一.wordcountcount 二.编程模型 三.RDD数据集和算子的使用 Spark(二)算子讲解 @ 一.wordcountcount 基于上次的wordcoun ...
- MapReduce二次排序
默认情况下,Map 输出的结果会对 Key 进行默认的排序,但是有时候需要对 Key 排序的同时再对 Value 进行排序,这时候就要用到二次排序了.下面让我们来介绍一下什么是二次排序. 二次排序原理 ...
- Hadoop Mapreduce分区、分组、二次排序过程详解[转]
原文地址:Hadoop Mapreduce分区.分组.二次排序过程详解[转]作者: 徐海蛟 教学用途 1.MapReduce中数据流动 (1)最简单的过程: map - reduce (2) ...
- Hadoop.2.x_高级应用_二次排序及MapReduce端join
一.对于二次排序案例部分理解 1. 分析需求(首先对第一个字段排序,然后在对第二个字段排序) 杂乱的原始数据 排序完成的数据 a,1 a,1 b,1 a,2 a,2 [排序] a,100 b,6 == ...
随机推荐
- 我的Android进阶之旅------>关于使用Android Studio替换App的launcher图标之后仍然显示默认的ic_launcher图标的解决方法
前言 最近做了一个App,之前开发该App的时候一直以来都是默认的launcher图标启动的, 今天美工换了一个App的launcher 图标,因此在Android Studio中将默认的lanche ...
- JDK源代码学习系列05----LinkedList
JDK源代码学习系列05----LinkedList 1.LinkedList简单介绍 LinkedList是基于双向 ...
- docker中制作自己的JDK+tomcat镜像
方式一 首先,准备好想要的jdk和tomcat,另外,我们需要创建一个Dockerfile文件.下面展示一个Dockerfile文件的完整内容: FROM ubuntu:14.10 MAINTAINE ...
- redis实现cache系统原理(五)
1. 介绍 cache就是人们所说的缓存.我们这里所说的cache是web上的.对用户来说,衡量一个网站是否具有良好的体验,其中一个标准就是响应速度的快慢.可能网站刚上线,功能还较少,数据库的记录也不 ...
- IOS中快速集成短信SDK验证开发(SMSSDK),IOS开发中如何设置手机验证码
[转载请注明出处] sdk是别人的,我只是下载来集成一下. smssdk下载网站:http://www.mob.com/(也有其他很多网站有类似SDK,譬如https://www.juhe.cn/等等 ...
- python16_day07【Socket网络编程】
一.简介 1.理解C/S,B/S 2.IOS七层模型(http://www.cnblogs.com/linhaifeng/articles/5937962.html) 二.什么是Socket 我们看看 ...
- springmvc 需要用到的核心jar包
aopbeanscontextcoreexpressionwebwebmvc
- POJ 1733 Parity game (带权并查集)
题意:有序列A[1..N],其元素值为0或1.有M条信息,每条信息表示区间[L,R]中1的个数为偶数或奇数个,但是可能有错误的信息.求最多满足前多少条信息. 分析:区间统计的带权并查集,只是本题中路径 ...
- javac是啥
javac是java语言编程编译器.全称java compiler. javac工具读有java语言编写的类和接口的定义,并将它们编译成字节代码的class文件.
- windows下线程库的使用
下载PTHREAD的WINDOWS开发包 pthreads-w32-2-4-0-release.exe(任何一个版本均可) http://sourceware.org/pthreads-win32 ...