
nodejs实现拉钩网爬虫
概述
详细
一、准备工作
1、安装最新版本的nodejs,其中npm会被自动安装
2、安装该项目需要的包
npm install cheerio jsdom mysql request -S
其中package.json中的内容为:
"dependencies": {

    "cheerio": "^1.0.0-rc.1",

    "jsdom": "^11.0.0",

    "mysql": "^2.13.0",

    "request": "^2.81.0"

  }
二、程序实现
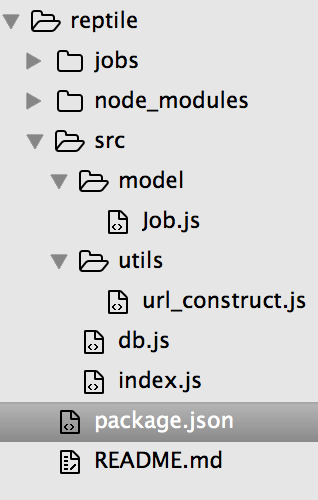
1、程序实现的目录结构如下:
2、实现思路如下:
index.js:程序主文件,各种数据清洗工作,url构造在这个文件中完成
Job.js : 用于构建Job对象,有助于写入数据库
db.js:连接数据库并写入数据
url_construct.js:可以自己配置抓取那些公司的职位信息。如阿里巴巴,百度,腾讯等。部分代码如下:
const companyNames = ["网易","阿里巴巴","百度","腾讯","去哪儿","浪潮"];

const encodedCompanyNames = [];

//转化为urlencoded

for(let i=0;i<companyNames.length;i++){

  encodedCompanyNames.push(encodeURIComponent(companyNames[i]));

}

module.exports = encodedCompanyNames;
3、数据库设计截图
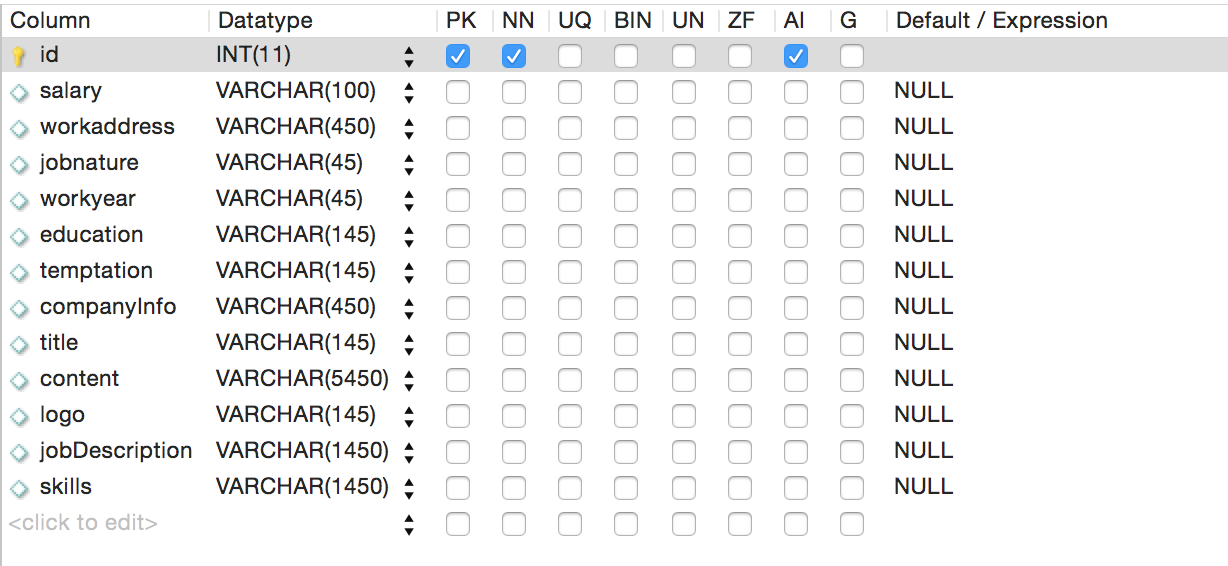
上面是本例子的数据库截图,其中id是主键,同时是自增的。
4、连接数据库注意点
下面的user和password的值是你安装数据库时候设置的,请自己修改
const pool = mysql.createPool({

  connectionLimit:10,

  database:TEST_DATABASE,

  user:"root",

  password:"root"

});
三、运行效果
首先cd到src目录下,然后简单的运行下面的命令就可以了:
node index.js
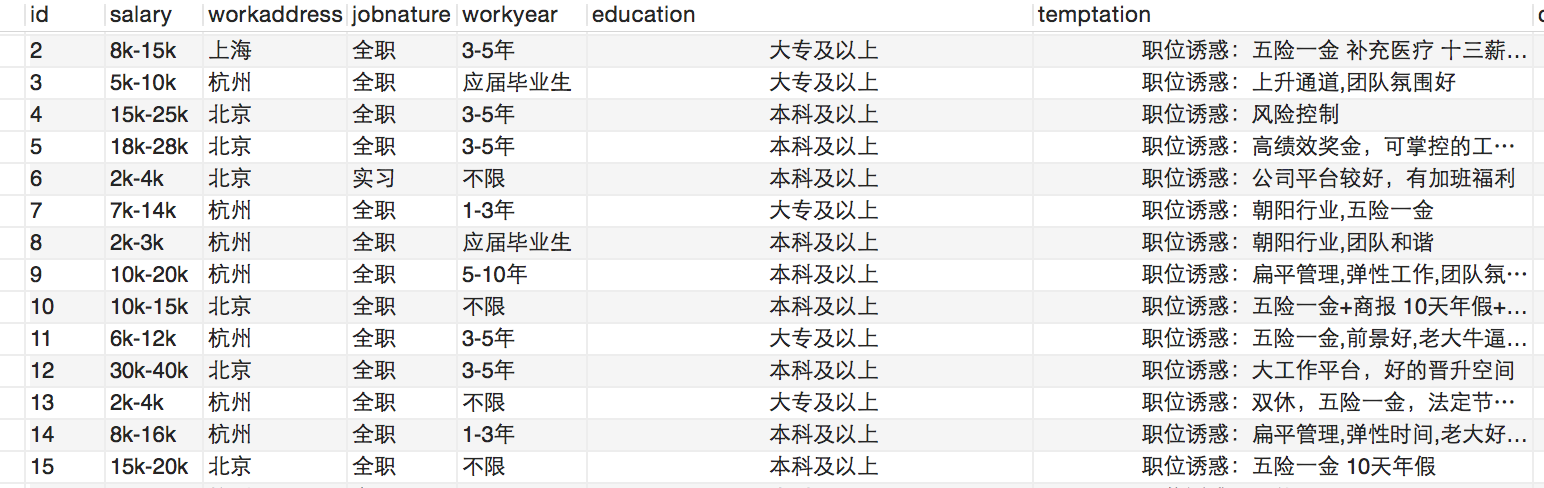
下面是数据库抓取的部分信息截图:
四、其他补充
如果你需要增加更多功能,可以在demo大师的"没有找到例子?"功能提出,我会增加例子,谢谢
注:本文著作权归作者,由demo大师发表,拒绝转载,转载需要作者授权
nodejs实现拉钩网爬虫的更多相关文章
- day 112天,爬虫(拉钩网,斗音,GitHub)第二天
提前准备工作.安装准备工作(day3用) 1. 安装scrapy https://www.cnblogs.com/wupeiqi/articles/6229292.html a. 下载twiste ...
- Python3网络爬虫之requests动态爬虫:拉钩网
操作环境: Windows10.Python3.6.Pycharm.谷歌浏览器目标网址: https://www.lagou.com/jobs/list_Python/p-city_0?px=defa ...
- Python3 Scrapy + Selenium + 阿布云爬取拉钩网学习笔记
1 需求分析 想要一个能爬取拉钩网职位详情页的爬虫,来获取详情页内的公司名称.职位名称.薪资待遇.学历要求.岗位需求等信息.该爬虫能够通过配置搜索职位关键字和搜索城市来爬取不同城市的不同职位详情信息, ...
- 拉钩网爬取所有python职位信息
最近在找工作,所以爬取了拉钩网的全部python职位,以便给自己提供一个方向.拉钩网的数据还是比较容易爬取的,得到json数据直接解析就行,废话不多说, 直接贴代码: import json impo ...
- 使用request爬取拉钩网信息
通过cookies信息爬取 分析header和cookies 通过subtext粘贴处理header和cookies信息 处理后,方便粘贴到代码中 爬取拉钩信息代码 import requests c ...
- selelinum+PhantomJS 爬取拉钩网职位
使用selenium+PhantomJS爬取拉钩网职位信息,保存在csv文件至本地磁盘 拉钩网的职位页面,点击下一页,职位信息加载,但是浏览器的url的不变,说明数据不是发送get请求得到的. 我们不 ...
- 爬取拉钩网上所有的python职位
# 2.爬取拉钩网上的所有python职位. from urllib import request,parse import json,random def user_agent(page): #浏览 ...
- Python 爬取拉钩网工作岗位
如果拉钩网html页面做了调整,需要重新调整代码 代码如下 #/usr/bin/env python3 #coding:utf-8 import sys import json import requ ...
- ruby 爬虫爬取拉钩网职位信息,产生词云报告
思路:1.获取拉勾网搜索到职位的页数 2.调用接口获取职位id 3.根据职位id访问页面,匹配出关键字 url访问采用unirest,由于拉钩反爬虫,短时间内频繁访问会被限制访问,所以没有采用多线程, ...
随机推荐
- ExtJs Ext.data.Store 处理
var storeCpye = new Ext.data.GroupingStore({ proxy : new Ext.data.HttpProxy({ url : 'cxgl_cpye.app?d ...
- Android之NDK开发环境r9
需要的软件: android-ndk-r9-windows-x86_64.zip(我的系统是64位的,所以下载的是64的)下载地址:http://developer.android.com/tools ...
- python笔记28-lxml.etree爬取html内容
前言 本篇继续lxml.etree学习,在线访问接口,通过接口返回的html,解析出想要的text文本内容 环境准备: python 3.6 lxml requets 定位目标 爬取我的博客首页htt ...
- 测试 Nginx 作为前端下各种模式的性能
测试环境: 1:Nginx 独立处理静态面页请求 5000,开了60个线程 2:Nginx作为前端请求转给 Weblogic 12c 处理 (Spring 4.0平台下的动态面页效果如图) 3:Ngi ...
- 转: LDAP有啥子用? 用户认证
认证的烦恼 小明的公司有很多IT系统, 比如邮箱.SVN.Jenkins , JIRA,VPN, WIFI...... 等等 . 新人入职时需要在每个系统中申请一遍账号,每个系统对用户名和密码的要求还 ...
- Android之使用picker打开相应的app
Android之使用picker打开相应的app,如果是music则可以选择是否使用相应打开的app进行播放. 在Manifest中设置,则可在选择音频文件的时候使用配置了以下的app打开 <i ...
- sqlalchemy批量删除数据、全量删除
问题:sqlalchemy如何批量删除多条数据解决:使用参数synchronize_session=False,或for循环方法: users = self.db.query(User) ...
- ffmpeg 2.3版本号, 关于ffplay音视频同步的分析
近期学习播放器的一些东西.所以接触了ffmpeg,看源代码的过程中.就想了解一下ffplay是怎么处理音视频同步的,之前仅仅大概知道通过pts来进行同步,但对于怎样实现却不甚了解,所以想借助这个机会, ...
- Ubuntu 常用命令大全
Ubuntu 常用命令大全查看软件 xxx 安装内容#dpkg -L xxx查找软件#apt-cache search 正则表达式查找文件属于哪个包#dpkg -S filename apt-file ...
- 3D几何图形生成的DEMO
3D几何图形生成的DEMO 可以生成以下几种图形: [1] 平面(Plane)图形的生成算法 [2] 立方体(Box)图形的生成算法 [3] 球(Sphere)图形的生成算法 [4] 圆锥(Cone) ...