
大数据笔记(七)——Mapreduce程序的开发
一.分析Mapreduce程序开发的流程
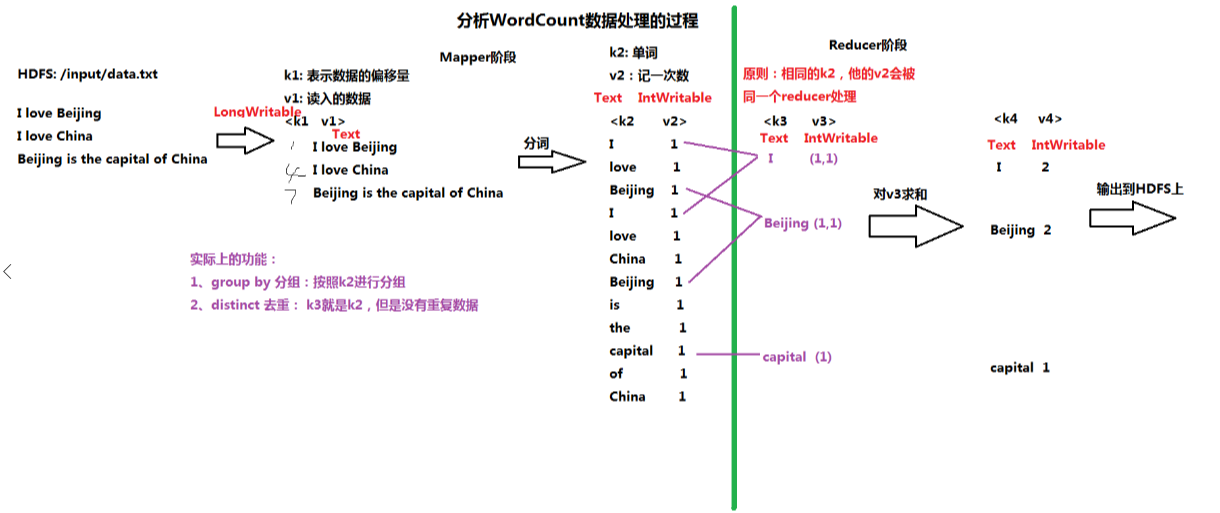
1.图示过程
输入:HDFS文件 /input/data.txt
Mapper阶段:
K1:数据偏移量(以单词记)V1:行数据
K2:单词 V2:记一次数
Reducer阶段 :
K3:单词(=K2) V3:V2计数的集合
K4:单词 V4:V3集合中元素累加和
输出:HDFS
2.开发WordCount程序需要的jar
/root/training/hadoop-2.7.3/share/hadoop/common

/root/training/hadoop-2.7.3/share/hadoop/common/lib

/root/training/hadoop-2.7.3/share/hadoop/mapreduce

/root/training/hadoop-2.7.3/share/hadoop/mapreduce/lib
3.WordCountMapper.java
package demo.wc;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

public class WordCountMapper extends Mapper<LongWritable, Text, Text, LongWritable>{

    @Override

    protected void map(LongWritable k1, Text v1, Context context)

            throws IOException, InterruptedException {

        //Context代表Mapper的上下文 上文:HDFS 下文:Mapper

        //取出数据: I love beijing

        String data = v1.toString();

        //分词

        String[] words = data.split(" ");

        //输出K2 V2

        for (String w : words) {

            context.write(new Text(w), new LongWritable(1));

        }

    }

}
4.WordCountReducer.java
package demo.wc;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

public class WordCountReducer extends Reducer<Text, LongWritable, Text, LongWritable>{

    @Override

    protected void reduce(Text k3, Iterable<LongWritable> v3,

            Context context) throws IOException, InterruptedException {

        //context 代表Reduce的上下文 上文:Mapper 下文:HDFS

        long total = 0;

        for (LongWritable l : v3) {

            //对v3求和

            total = total + l.get();

        }

        //输出K4 V4

        context.write(k3, new LongWritable(total));

    }

}
5.WordCountMain.java
package demo.wc;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WordCountMain {

    public static void main(String[] args) throws Exception {

        //创建一个job = mapper + reducer

        Job job = Job.getInstance(new Configuration());

        //ָ指定任务的入口

        job.setJarByClass(WordCountMain.class);

        //ָ指定任务的mapper和输出的数据类型

        job.setMapperClass(WordCountMapper.class);

        job.setMapOutputKeyClass(Text.class);//指定k2

        job.setMapOutputValueClass(LongWritable.class);//指定v2

        //ָ指定任务的reducer和输出的数据类型

        job.setReducerClass(WordCountReducer.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(LongWritable.class);

        //ָ指定输入的路径(map)、输出的路径(reduce)

        FileInputFormat.setInputPaths(job, new Path(args[0]));

        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        //ִ执行任务

        job.waitForCompletion(true);

    }

}
打包,传到HDFS上:
运行任务:
hadoop jar wc.jar /input/data.txt /output/day0228/wc
日志信息:
18/03/01 00:14:00 INFO client.RMProxy: Connecting to ResourceManager at bigdata11/192.168.153.11:8032

18/03/01 00:14:01 WARN mapreduce.JobResourceUploader: Hadoop command-line option parsing not performed. Implement the Tool interface and execute your application with ToolRunner to remedy this.

18/03/01 00:14:01 INFO input.FileInputFormat: Total input paths to process : 1

18/03/01 00:14:01 INFO mapreduce.JobSubmitter: number of splits:1

18/03/01 00:14:02 INFO mapreduce.JobSubmitter: Submitting tokens for job: job_1519833888534_0001

18/03/01 00:14:02 INFO impl.YarnClientImpl: Submitted application application_1519833888534_0001

18/03/01 00:14:02 INFO mapreduce.Job: The url to track the job: http://bigdata11:8088/proxy/application_1519833888534_0001/

18/03/01 00:14:02 INFO mapreduce.Job: Running job: job_1519833888534_0001

18/03/01 00:14:16 INFO mapreduce.Job: Job job_1519833888534_0001 running in uber mode : false

18/03/01 00:14:16 INFO mapreduce.Job:  map 0% reduce 0%

18/03/01 00:14:24 INFO mapreduce.Job:  map 100% reduce 0%

18/03/01 00:14:31 INFO mapreduce.Job:  map 100% reduce 100%
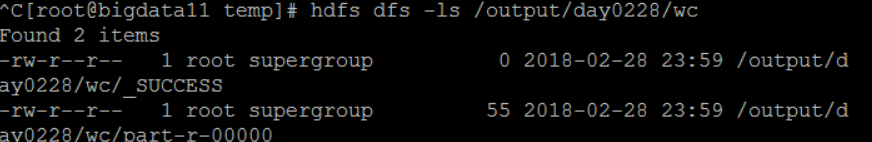
查看结果:
hdfs dfs -ls /output/day0228/wc
hdfs dfs -cat /output/day0228/wc/part-r-00000

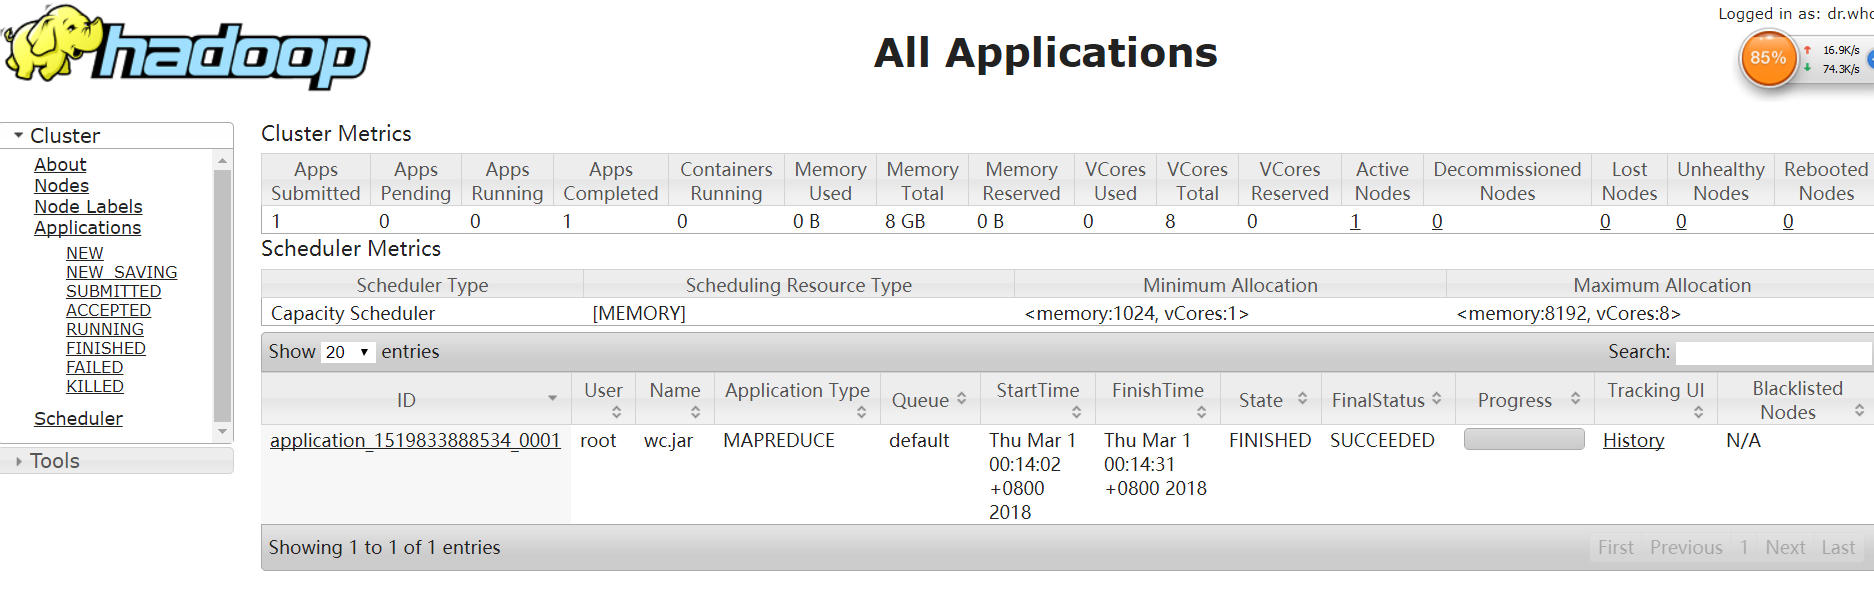
Web Console通过8088端口查看:
大数据笔记(七)——Mapreduce程序的开发的更多相关文章
- 大数据篇:MapReduce
MapReduce MapReduce是什么? MapReduce源自于Google发表于2004年12月的MapReduce论文,是面向大数据并行处理的计算模型.框架和平台,而Hadoop MapR ...
- 《OD大数据实战》MapReduce实战
一.github使用手册 1. 我也用github(2)——关联本地工程到github 2. Git错误non-fast-forward后的冲突解决 3. Git中从远程的分支获取最新的版本到本地 4 ...
- 大数据运算模型 MapReduce 原理
大数据运算模型 MapReduce 原理 2016-01-24 杜亦舒 MapReduce 是一个大数据集合的并行运算模型,由google提出,现在流行的hadoop中也使用了MapReduce作为计 ...
- 大数据笔记(十)——Shuffle与MapReduce编程案例(A)
一.什么是Shuffle yarn-site.xml文件配置的时候有这个参数:yarn.nodemanage.aux-services:mapreduce_shuffle 因为mapreduce程序运 ...
- 大数据笔记(八)——Mapreduce的高级特性(A)
一.序列化 类似于Java的序列化:将对象——>文件 如果一个类实现了Serializable接口,这个类的对象就可以输出为文件 同理,如果一个类实现了的Hadoop的序列化机制(接口:Writ ...
- 基于Hbase数据的Mapreduce程序环境开发
一.实验目标 编写Mapreduce程序,以Hbase表数据为Map输入源,计算结果输出到HDFS或者Hbase表中. 在非CDH5的Hadoop集群环境中,将编写好的Mapreduce程序整个工程打 ...
- 大数据基础总结---MapReduce和YARN技术原理
Map Reduce和YARN技术原理 学习目标 熟悉MapReduce和YARN是什么 掌握MapReduce使用的场景及其原理 掌握MapReduce和YARN功能与架构 熟悉YARN的新特性 M ...
- 大数据笔记01:大数据之Hadoop简介
1. 背景 随着大数据时代来临,人们发现数据越来越多.但是如何对大数据进行存储与分析呢? 单机PC存储和分析数据存在很多瓶颈,包括存储容量.读写速率.计算效率等等,这些单机PC无法满足要求. 2. ...
- 大数据IDEA调试flink程序
Flink在IDEA中开发是一件比较困难的事情,网上没有参考资料,就算就业说的太过笼统,不知道是会了不说还是不会瞎说,为了解决flink这个问题,本人特别做了一遍开发的简单说明.主要考虑两个问题,1. ...
随机推荐
- HTTP请求状态码为400时的原因
2019-11-30 出现这个请求无效说明请求没有进入后台服务器里 原因: (1)前端提交的字段名称或者字段类型和后台的实体类不一样 或者前端提交的参数跟后台需要的参数个数不一致,导致无法封装 (2) ...
- 任务调度之 Quartz
任务调度的背景 在业务系统中有很多这样的场景: 账单日或者还款日上午 10 点,给每个信用卡客户发送账单通知,还款通知.如何判断客户的账单日.还款日,完成通知的发送? 银行业务系统,夜间要完成跑批的一 ...
- 工具使用--Tomcat
一.Tomcat 服务搭建 1.进入apache官网下载tomcat 8.在左手边的菜单区,选择download下的tomcat8 版本: PS:操作系统,文件类型 2.将zip文件下载,解压到本地: ...
- pip找不到的安装包
pip install找不到一些python包 可以访问网址,选择python版本自行下载:http://www.lfd.uci.edu/~gohlke/pythonlibs/#lxml 清华大学开源 ...
- 04: DjangoRestFramework使用
Django其他篇 目录: 1.1 DjangoRestFramework基本使用 1.2 drf认证&权限 模块 1.3 djangorestframework 序列化 1.4 django ...
- pthread.h 的 undefined reference to `pthread_create'
在编译中要加 -lpthread或-pthread参数(不同版本的gcc可能不一样,man gcc可以查阅对应参数). 例如:在加了头文件#include <pthread.h>之后执行 ...
- Node+Express+MySql实现简单增删改查和登录
var express = require('express'); var mysql = require('mysql'); var app = express(); var bodyParser ...
- 客户端通过url向后端传递参数
在前端我们不仅可以通过get请求携带参数的方式向服务端传数据: https://127.0.0.1/index/?id=1&name=alex Django也允许通过,path路径的方式向se ...
- spring boot 枚举使用的坑
java 枚举的功能挺多,但是坑更多,使用的时候要注意.如下面这个枚举. @Getter @AllArgsConstructor public enum EnumExpenseType impleme ...
- k3 cloud凭证过账的时候提示凭证号不连续
解决办法:进入凭证查询页面,点击凭证业务操作下面的凭证整理 提交整理完成即可