
Matplotlib学习---用matplotlib和sklearn画拟合线(line of best fit)
在机器学习中,经常要用scikit-learn里面的线性回归模型来对数据进行拟合,进而找到数据的规律,从而达到预测的目的。用图像展示数据及其拟合线可以非常直观地看出拟合线与数据的匹配程度,同时也可用于后续的解释和阐述工作。
这里利用Nathan Yau所著的《鲜活的数据:数据可视化指南》一书中的数据,学习画图。
数据地址:http://datasets.flowingdata.com/unemployment-rate-1948-2010.csv
准备工作:先导入matplotlib和pandas,用pandas读取csv文件,然后创建一个图像和一个坐标轴
import pandas as pd

from matplotlib import pyplot as plt

unemployment=pd.read_csv(r"http://datasets.flowingdata.com/unemployment-rate-1948-2010.csv")

fig,ax=plt.subplots()
让我们先来看看这个数据文件(此处只截取部分):
       Series id  Year Period  Value

0    LNS14000000  1948    M01    3.4

1    LNS14000000  1948    M02    3.8

2    LNS14000000  1948    M03    4.0

3    LNS14000000  1948    M04    3.9

4    LNS14000000  1948    M05    3.5

..           ...   ...    ...    ...

716  LNS14000000  2007    M09    4.7

717  LNS14000000  2007    M10    4.7

718  LNS14000000  2007    M11    4.7

719  LNS14000000  2007    M12    5.0
这个数据展示的是美国1948年到2010年各月份的失业率。
我们需要先把数据用散点图画出来,再用sklearn对数据进行拟合,最后把拟合线也画出来。
首先,把年份和失业率数据提取出来,画出散点图。这里需要注意的是,年份数据比失业率数据规模大很多(年份以千计,失业率大部分是个位数),因此在拟合前需要进行特征缩放,否则年份这一特征值的影响将远远大于失业率。
其次,从sklearn导入线性回归模块。假设数据模型属于简单线性回归,此时,就是把年份数据当作自变量(通常记为变量x),失业率数据当作因变量(通常记为变量y),找出它们之间的线性关系。然后在散点图上画出此拟合线。需要注意的是:年份数据是一维数组,需要将其转换为二维矩阵(这个矩阵的每一列为各个特征的量化值,每一行为每个样本的观测数据),才可以用sklearn进行拟合。通常通过x.reshape(-1,1)方法或x[:,np.newaxis]方法将其转换。
此时图像如下:
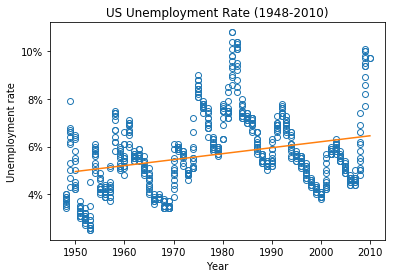
可以看出,这条拟合线并不能很好反映出数据的pattern。
所以接下来,我们再用多项式回归模型来试一试。sklearn里面并没有直接的多项式回归模块可供我们使用,而是需要从sklearn.preprocessing导入PolynomialFeatures,在PolynomialFeatures里确定进行几次多项式变换,将年份自变量转换为多项式形式,然后再用线性模型进行拟合。例如:假设年份自变量为:
[[19]

 [20]

 [21]]
那么将其转换为二次多项式形式(degree=2)后就变成:
[[1  19  361]

 [1  20  400]

 [1  21  441]]
这样就相当于把原有的方程式y=b1x+a转换成了y=b1x+b2x2+1+a。
完整代码如下:
import numpy as np

import pandas as pd

import matplotlib

from matplotlib import pyplot as plt

unemployment=pd.read_csv(r"http://datasets.flowingdata.com/unemployment-rate-1948-2010.csv")

fig,ax=plt.subplots(figsize=(10,6))

#提取年份和对应的失业率数据,由于年份数据都是上千,而失业率大都是个位数,

#因此这里要用到特征缩放,把年份缩小100倍

x=unemployment["Year"].values/100

y=unemployment["Value"].values

#以年份为x轴,失业率为y轴,画出散点图

ax.plot(x,y,"o",markerfacecolor="none")

ax.set(xlabel="Year",ylabel="Unemployment rate",title="US Unemployment Rate (1948-2010)")

ax.yaxis.set_major_formatter(matplotlib.ticker.FormatStrFormatter('%.f%%')) #把y轴刻度值设置为百分比形式

ax.set_xticklabels(np.arange(1940,2011,10)) #设置x轴刻度标签

#假设数据属于简单线性回归,对其进行拟合

from sklearn.linear_model import LinearRegression

linear=LinearRegression()

xfit=x.reshape(-1,1)

yfit=y.reshape(-1,1)

linear.fit(xfit,yfit)

xpre=np.linspace(19.5,20.1,num=50,endpoint=True) #创建用于预测的x值

ypre=linear.predict(xpre[:,np.newaxis])

ax.plot(xpre,ypre,"-",label="degree 1")

#假设数据属于多项式回归,分别对其进行拟合

from sklearn.preprocessing import PolynomialFeatures

for i in [2,4]:

    PF=PolynomialFeatures(degree=i)

    xfit1=PF.fit_transform(xfit)

    linear1=LinearRegression()

    linear1.fit(xfit1,yfit)

    xpre1=PF.fit_transform(xpre[:,np.newaxis])

    ypre1=linear1.predict(xpre1)

    ax.plot(xpre,ypre1,"-",label="degree {}".format(i))

ax.legend()

plt.show()
图像如下:
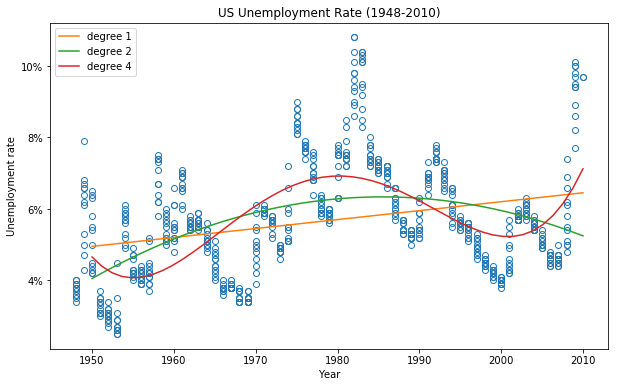
可以看出,用多项式回归模型进行拟合的效果比较好。
Matplotlib学习---用matplotlib和sklearn画拟合线(line of best fit)的更多相关文章
- Matplotlib学习---用matplotlib画箱线图(boxplot)
箱线图通过数据的四分位数来展示数据的分布情况.例如:数据的中心位置,数据间的离散程度,是否有异常值等. 把数据从小到大进行排列并等分成四份,第一分位数(Q1),第二分位数(Q2)和第三分位数(Q3)分 ...
- Matplotlib学习---用matplotlib画直方图/密度图(histogram, density plot)
直方图用于展示数据的分布情况,x轴是一个连续变量,y轴是该变量的频次. 下面利用Nathan Yau所著的<鲜活的数据:数据可视化指南>一书中的数据,学习画图. 数据地址:http://d ...
- Matplotlib学习---用matplotlib画误差线(errorbar)
误差线用于显示数据的不确定程度,误差一般使用标准差(Standard Deviation)或标准误差(Standard Error). 标准差(SD):是方差的算术平方根.如果是总体标准差,那么用σ表 ...
- Matplotlib学习---用matplotlib画阶梯图(step plot)
这里利用Nathan Yau所著的<鲜活的数据:数据可视化指南>一书中的数据,学习画图. 数据地址:http://datasets.flowingdata.com/us-postage.c ...
- Matplotlib学习---用matplotlib画面积图(area chart)
这里利用Nathan Yau所著的<鲜活的数据:数据可视化指南>一书中的数据,学习画图. 数据地址:http://book.flowingdata.com/ch05/data/us-pop ...
- Matplotlib学习---用matplotlib画热图(heatmap)
这里利用Nathan Yau所著的<鲜活的数据:数据可视化指南>一书中的数据,学习画图. 数据地址:http://datasets.flowingdata.com/ppg2008.csv ...
- Matplotlib学习---用matplotlib画饼图/面包圈图(pie chart, donut chart)
我在网上随便找了一组数据,用它来学习画图.大家可以直接把下面的数据复制到excel里,然后用pandas的read_excel命令读取.或者直接在脚本里创建该数据. 饼图: ax.pie(x,labe ...
- Matplotlib学习---用matplotlib画折线图(line chart)
这里利用Jake Vanderplas所著的<Python数据科学手册>一书中的数据,学习画图. 数据地址:https://raw.githubusercontent.com/jakevd ...
- Matplotlib学习---用matplotlib画散点图,气泡图(scatter plot, bubble chart)
Matplotlib里有两种画散点图的方法,一种是用ax.plot画,一种是用ax.scatter画. 一. 用ax.plot画 ax.plot(x,y,marker="o",co ...
随机推荐
- 算法题:合并N个长度为L的有序数组为一个有序数组(JAVA实现)
昨天面试被问到这道算法题,一时没有回答上来,今天思考了一下,参阅了网上的教程,做了一个JAVA版本的实现. 方案一: 新建一个N*L的数组,将原始数组拼接存放在这个大数组中,再调用Arrays.sor ...
- PV、UV、IP、TPS、QPS、RPS、两天、吞吐量、 并发用户数 术语
跟网站打交道,经常可以听到数据分析之类的专有名词,如pv多少.ip多少.tps多少之类的问题.下面就这些常见的数据给出其释义. PV 即 page view,页面浏览量 用户每一次 ...
- flask登录插件 flask-login
Flask-Login为Flask提供了用户会话管理,它处理了日常的登入登出且长时间记住用户的会话 使用: 1.配置,初始化 LoginManager 创建实例 loginManger = Login ...
- javaMail发邮件,激活用户账号
用javamail实现注册用户验证邮箱功能.用户注册后随机生成一个uuid作为用户的标识,传递给用户然后作为路径参数.发送html的内容到用户注册的邮箱里,若用户点击后去往的页面提交username和 ...
- 软件工程启程篇章:C#和四则运算生成与运算
0x01 :序言 I leave uncultivated today, was precisely yestoday perishes tomorrow which the person of th ...
- Diverse Garland CodeForces - 1108D (贪心+暴力枚举)
You have a garland consisting of nn lamps. Each lamp is colored red, green or blue. The color of the ...
- mysql之整合ssm多数据源配置
一,基于SSM框架的多数据源配置 1.创建DynamicDataSourceHolder用于持有当前线程中使用的数据源标识 public class DynamicDataSourceHolder { ...
- echarts使用笔记三:柱子对比
app.title = '坐标轴刻度与标签对齐'; option = { title : { //标题 x : 'center', y : 5, text : '对比图' //换行用 \n }, le ...
- MYSQL 创建数据库SQL
CREATE DATABASE crm CHARACTER SET utf8 COLLATE utf8_general_ci; MySQL :: MySQL 5.7 Reference Manual ...
- 【开讲啦】20181029 oracle教学笔记
--创建表空间 create tablespace waterboss--表空间名称 datafile 'd:\waterboss.dbf'--用于设置物理文件名称 size 100m--用于设置表空 ...