
Pandas 基础(2) - Dataframe 基础
上一节我们已经对 Dataframe 的概念做了一个简单的介绍, 这一节将具体看下它的一些基本用法:
首先, 准备一个 excel 文件, 大致内容如下, 并保存成 .csv 格式.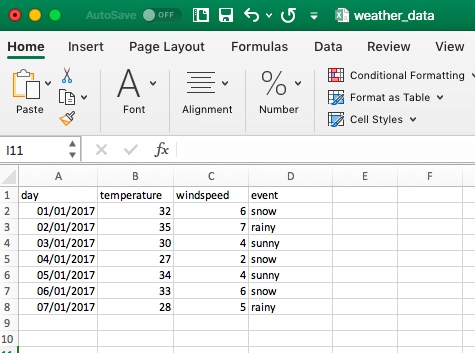
然后, 在 jupyter notebook 里执行如下代码:
#引入 pandas 模型

import pandas as pd

# 读取 csv 文件

df = pd.read_csv('weather_data.csv')

# 打印

df
在 jupyter notebook 里的表现形式大概如下: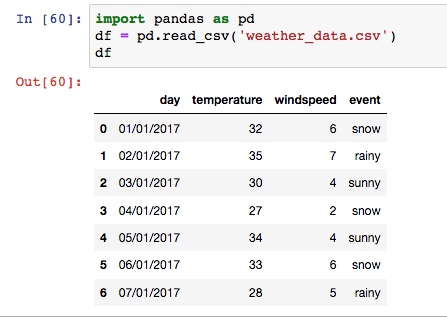
就这么简单, 我们就把一个 csv 文件转换成 dataframe 格式了. 这里大家在操作中可能遇到的一个报错就是找不到文件. 这是路径问题, 解决方法很简单, 打开你运行 jupyter 的终端窗口, 找到如下路径, 把你的 csv 文件丢进去就可以啦. 
OK, 上面介绍了如何将外部文件转换成 dataframe. 下面介绍从 python dictionary 转换成 dataframe:
# python dictionary

weather_data = {

    'day': ['1/1/2017', '1/2/2017', '1/3/2017', '1/4/2017', '1/5/2017', '1/6/2017'],

    'temperature': [32, 35, 27, 25, 24, 30],

    'windspeed': [6, 7, 2, 5, 4, 6],

    'event': ['Rain', 'Sunny', 'Snow', 'Snow', 'Rain', 'Sunny']

}

# 转换

df = pd.DataFrame(weather_data)

打印

df
运行结果:
可以说, 两种方式都非常的简便, 下面就基于上面的数据看一下 dataframe 有哪些属性可以供我们使用.
df.shape
输出:
(6, 4)
这里是查看这个 dataframe 的行数和列数, 显然, 我们这个例子中, 有 6 行, 4 列. 那么我们还可以把这个结果同时赋值给两个变量, 再分别查看这两个变量的值:
rows, columns = df.shape

rows
输出:
6
columns
输出:
4
# 查看前5行数据

df.head()

# 查看后5行数据

df.tail()

# 查看后 3 行数据

df.tail(3)

# 查看 第 2,3,4 行的数据

df[2:5]

# 查看所有数据

df[:]

# 查看所有列

df.columns

# 查看某一列方法一, 只适用于列名中间没有空格的

df.day

# 查看某一列方法二, 适用于所有列名

df['event']

# 查看某一列的类型, 这里输出的结果是 pandas.core.series.Series, 表示每一列都是一个 series

type(df['event'])

# 查看两个列以上的数据, 注意这里要用两个中括号

df[['event', 'day']]
以上就是 dataframe 的一些基本属性. 下面介绍一些操作命令
# 求某一列里的最大值

df['temperature'].max()

# 求某一列的平均值

df.temperature.mean()

# 查看 temperature 大于 30 的数据

df[df.temperature>30]

# 查看 temperature 等于最大值的数据

df[df.temperature==df.temperature.max()]

# 只查看 temperature 等于最大值的日期, 有下面两种写法

df['day'][df.temperature==df.temperature.max()]

df.day[df.temperature==df.temperature.max()]

# 查看 temperature 等于最大值的日期和温度

df[['day', 'temperature']][df.temperature==df.temperature.max()]

# 查看目前的索引

df.index

# 设置索引, 这里注意必须加上第二个参数, 以确保真正更改到 df 的索引

df.set_index('day', inplace=True)

# 基于上面把 'day' 设为索引, 就可以具体查看某一行的数据

df.loc['1/4/2017']

# 重置索引

df.reset_index(inplace=True)

# 把索引设置为 'event', 这里要说明两个问题, 第一, 更新索引必须在重置索引的前提下, 否则 'day'列就消失了, 第二, 任何列都可以被设置为索引

df.set_index('event', inplace=True)
最后再介绍一个命令, 这里就是会输出所有数字内容的列, 并且罗列出一些基本常用的运算结果.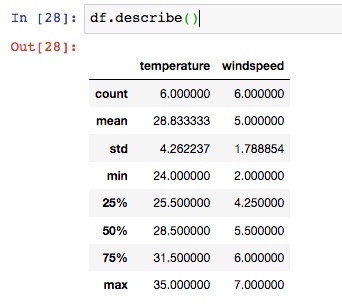
OK, 以上就是对 dataframe 的基本用法的介绍.
大家如果有任何问题或者意见或者不同看法, 欢迎留言呦. 期待跟大家一起学习讨论.
See you!!!
Pandas 基础(2) - Dataframe 基础的更多相关文章
- 小白学 Python 数据分析(6):Pandas (五)基础操作(2)数据选择
人生苦短,我用 Python 前文传送门: 小白学 Python 数据分析(1):数据分析基础 小白学 Python 数据分析(2):Pandas (一)概述 小白学 Python 数据分析(3):P ...
- MYSQL、PHP基础、面向对象基础简单复习总结
一.MYSQL 1.配置MySql 第一步安装服务器(apache). 第二部安装MySql界面程序 2 ...
- pandas 学习(2): pandas 数据结构之DataFrame
DataFrame 类型类似于数据库表结构的数据结构,其含有行索引和列索引,可以将DataFrame 想成是由相同索引的Series组成的Dict类型.在其底层是通过二维以及一维的数据块实现. 1. ...
- Jmeter基础之---jmeter基础概念
Jmeter基础之---jmeter基础概念 JMeter 介绍: 一个非常优秀的开源的性能测试工具. 优点:你用着用着就会发现它的重多优点,当然不足点也会呈现出来. JMeter 介绍: 一个非常优 ...
- [.net 面向对象编程基础] (3) 基础中的基础——数据类型
[.net 面向对象编程基础] (3) 基础中的基础——数据类型 关于数据类型,这是基础中的基础. 基础..基础..基础.基本功必须要扎实. 首先,从使用电脑开始,再到编程,电脑要存储数据,就要按类型 ...
- [.net 面向对象编程基础] (4) 基础中的基础——数据类型转换
[.net面向对象编程基础] (4)基础中的基础——数据类型转换 1.为什么要进行数据转换? 首先,为什么要进行数据转换,拿值类型例子说明一下, 比如:我们要把23角零钱,换成2.30元,就需要把整形 ...
- [.net 面向对象编程基础] (5) 基础中的基础——变量和常量
[.net面向对象编程基础] (5) 基础中的基础——变量和常量 1.常量:在编译时其值能够确定,并且程序运行过程中值不发生变化的量. 通俗来说,就是定义一个不能改变值的量.既然不能变动值,那就必须 ...
- [.net 面向对象编程基础] (6) 基础中的基础——运算符和表达式
[.net 面向对象编程基础] (6) 基础中的基础——运算符和表达式 说起C#运算符和表达式,小伙伴们肯定以为很简单,其实要用好表达式,不是一件容易的事.一个好的表达式可以让你做事半功倍的效果,比如 ...
- [.net 面向对象编程基础] (7) 基础中的基础——流程控制语句
[.net 面向对象编程基础] (7) 基础中的基础——流程控制语句 本来没有这一节的内容,后来考虑到既然是一个系列文章,那么就尽可能写的详细一些,本节参考了网上朋友所写的例子,为的是让更多小伙伴学习 ...
随机推荐
- [转载]localStorage使用总结
一.什么是localStorage.sessionStorage 在HTML5中,新加入了一个localStorage特性,这个特性主要是用来作为本地存储来使用的,解决了cookie存储空间不足的问题 ...
- Django后端项目----restful framework 认证源码流程
一.请求到来之后,都要先执行dispatch方法,dispatch方法方法根据请求方式的不同触发get/post/put/delete等方法 注意,APIView中的dispatch方法有很多的功能 ...
- Python爬虫——小说
#encoding:utf8 import re import urllib2 url = 'http://www.23us.com/html/55/55304/' request = urllib2 ...
- ES6知识整理(10)--class的继承
(这是es6的第10篇文章.说真的这样的总结之后虽然直观了许多,但是消耗的时间有点长,或许是知识比较复杂的原因吧) 类的继承 有个A类,B类继承A类,那B类实例就可以使用A类实例的所以属性和方法.不包 ...
- scrapy 自定义图片路径保存,并存到数据库中
scrapy中有个自带的pipeline工具,ImagesPipeline,可以专门用来储存图片到本地. 但默认储存地址无法配置,所以我们需要写一个自己的pipeline用于储存图片. 先分析一下我们 ...
- 【Selenium专题】元素定位之CssSelector
CssSelector是我最喜欢的元素定位方法,Selenium官网的Document里极力推荐使用CSS locator,而不是XPath来定位元素,原因是CSS locator比XPath loc ...
- Python3 自定义请求头消息headers
Python3 自定义请求头消息headers 使用python爬虫爬取数据的时候,经常会遇到一些网站的反爬虫措施,一般就是针对于headers中的User-Agent,如果没有对headers进行设 ...
- tcpdump 抓包工具使用
1. 常用命令 监听p4p1网卡上来自 192.168.162.14 的包 tcpdump -i p4p1 src host 192.168.162.14 tcpdump -i p4p1 dst po ...
- mariadb的flashback到底怎么样???防误删可以,但算不上真正的闪回--再看mariadb 10.3的System-Versioned Tables
mariadb 在10.2.4引入闪回特性,支持DML(INSERT, DELETE, UPDATE)操作的闪回,不支持DDL语句,使用闪回,必须设置binlog_row_image=FULL. 其原 ...
- 非关系型数据库&&缓存
面试其他篇 目录: 1.1