
学习进度-16 python爬虫
爬虫是一个程序,这个程序的目的就是为了抓取万维网信息资源,比如你日常使用的谷歌等搜索引擎,搜索结果就全都依赖爬虫来定时获取
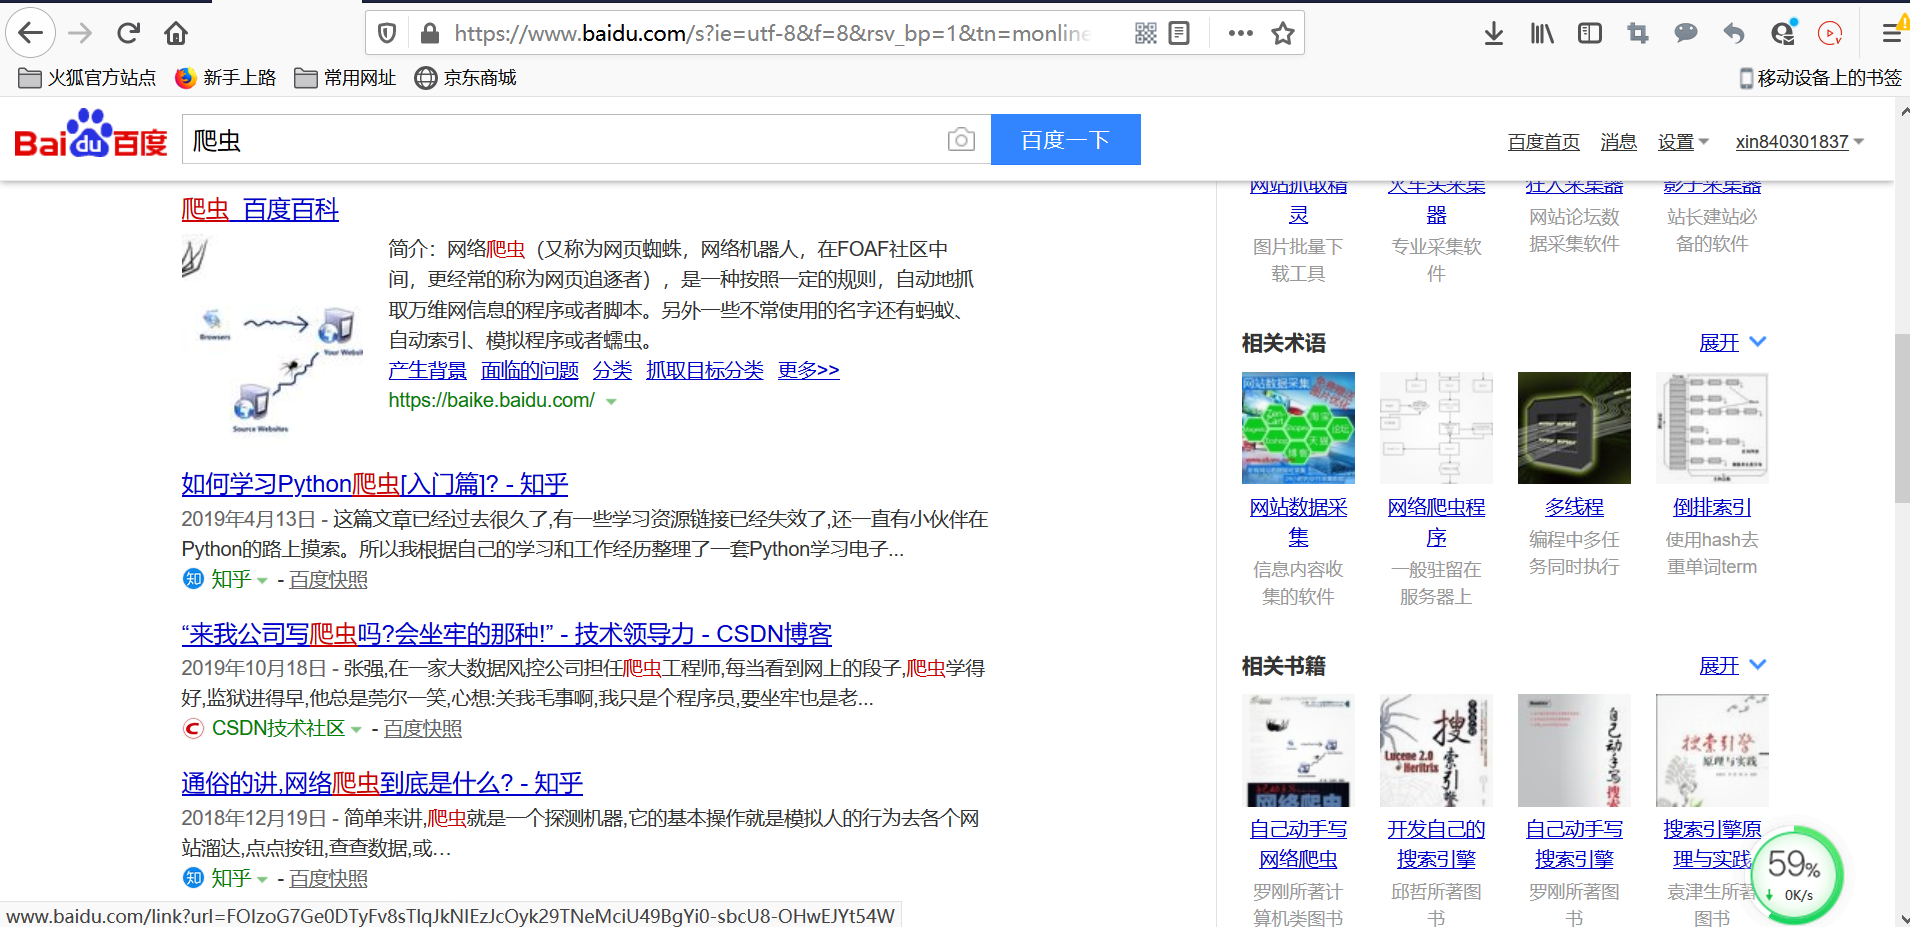
从百度可以看出来 爬虫与python关系很紧密,
爬虫的目标对象也很丰富,不论是文字、图片、视频,任何结构化非结构化的数据爬虫都可以爬取,爬虫经过发展,也衍生出了各种爬虫类型:
通用网络爬虫:爬取对象从一些种子 URL 扩充到整个 Web,搜索引擎干的就是这些事
垂直网络爬虫:针对特定领域主题进行爬取,比如专门爬取小说目录以及章节的垂直爬虫
增量网络爬虫:对已经抓取的网页进行实时更新
深层网络爬虫:爬取一些需要用户提交关键词才能获得的 Web 页面
要爬虫必须掌握:
网页的结构是HTML,爬虫的目标就是解析HTML,获取目标字段并保存
爬虫得步骤为:
模拟请求网页资源
从HTML提取目标元素
数据持久化
例如:
import requests

from bs4 import BeautifulSoup

target_url = 'http://www.baidu.com/s?wd=爬虫'

# 第一步 发起一个GET请求

res = requests.get(target_url)

# 第二步 提取HTML并解析想获取的数据 比如获取 title

soup = BeautifulSoup(res.text, "lxml")

# 输出 soup.title.text

title = soup.title.text

# 第三步 持久化 比如保存到本地

with open('title.txt', 'w') as fp:

    fp.write(title)
这就是一个简单得爬虫
参考网址:https://www.jianshu.com/p/c92dae931098
学习进度-16 python爬虫的更多相关文章
- 学习进度-10 python爬虫
学习爬虫的第一个案例是小说爬虫. 小说爬虫首先是解析小说页面源代码,在页面源代码中可以看到小说每章节的内容链接 爬虫的代码: import requests import re url = 'http ...
- 学习笔记之Python爬虫
Python 爬虫介绍 | 菜鸟教程 http://www.runoob.com/w3cnote/python-spider-intro.html https://blog.csdn.net/sina ...
- 吴裕雄--天生自然python学习笔记:python爬虫PM2.5 实时监测显示器
PM2.5 对人体的健康影响很大,所以空气中的 PM2.5 实时信息受到越来越多的关注. Python 的 Pandas 套件不但可以自动读取网页中的表格 数据 , 还可对数据进行修改.排序等处理,也 ...
- Python学习:16.Python面对对象(三、反射,构造方法,静态字段,静态方法)
一.构造方法 在使用类创建对象的时候(就是类后面加括号)就自动执行__init__方法. class A: def __init__(self): print('A') class B: def __ ...
- 吴裕雄--天生自然python学习笔记:python爬虫与网页分析
我们所抓取的网页源代码一般都是 HTML 格式的文件,只要研究明白 HTML 中 的标签( Tag )结构,就很容易进行解析并取得所需数据 . HTML 网页结构 HTML 网 页是由许多标签( Ta ...
- 【Python爬虫】入门知识
爬虫基本知识 这阵子需要用爬虫做点事情,于是系统的学习了一下python爬虫,觉得还挺有意思的,比我想象中的能干更多的事情,这里记录下学习的经历. 网上有关爬虫的资料特别多,写的都挺复杂的,我这里不打 ...
- python爬虫小实例
1.python爬取贴吧壁纸 1.1.获取整个页面数据 #coding=utf-8 import urllib def getHtml(url): page = urllib.urlopen(url) ...
- 【学习笔记】PYTHON网络爬虫与信息提取(北理工 嵩天)
学习目的:掌握定向网络数据爬取和网页解析的基本能力the Website is the API- 1 python ide 文本ide:IDLE,Sublime Text集成ide:Pychar ...
- 第三次作业-MOOC学习笔记:Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 第一周 Requests库的爬 ...
随机推荐
- C语言:将形参s所指字符串中所有ASCII码值小于97的字符存入形参t所指字符数组中,
//将形参s所指字符串中所有ASCII码值小于97的字符存入形参t所指字符数组中,形成一个新串,并统计出符合条件的字符个数返回. //关注点:使用*(t+n)的方式可以不改变指针的指向,像数组一样处理 ...
- C语言:将3*4矩阵中找出行最大,列最小的那个元素。-将低于平均值的人数作为函数返回值,将低于平均分的分数放入below数组中。
//将3*4矩阵中找出行最大,列最小的那个元素. #include <stdio.h> #define M 3 #define N 4 void fun(int (*a)[N]) { ,j ...
- 【代码审计】VAuditDemo 前台搜索功能反射型XSS
在 search.php中 $_GET['search']未经过任何过滤就被输出 可能存在反射型XSS
- 样式计算的几种方式与兼容写法:getComputedStyle¤tStyle&style
window.getComputedStyle(element,[string]) 1参为需要获取样式的元素,2参指定伪元素字符串(如“::after”,不需要则为null),设置2参可获取eleme ...
- java 第三次课后作业
1.java字段初始化的规律 public class gouzao { public static void main(String[] args) { test te=new test(); Sy ...
- 【PAT甲级】1039 Course List for Student (25 分)(vector嵌套于map,段错误原因未知)
题意: 输入两个正整数N和K(N<=40000,K<=2500),分别为学生和课程的数量.接下来输入K门课的信息,先输入每门课的ID再输入有多少学生选了这门课,接下来输入学生们的ID.最后 ...
- 前端开发:javascript中的面向对象
前端开发:面向对象与javascript中的面向对象实现(一) 面向对象理解: 面向对象是一种对现实世界理解和抽象的方法,是一种先进的程序设计理念,是一种比较抽象的,多形态的设计模式.我们可以这么理解 ...
- springboot集成拦截器
一.首先对HandlerInterceptor进行封装,封装为MappingInterceptor.封装的方法里添加拦截器起作用的路径addPathPatterns(),及需要排除路径的方法exclu ...
- php 基础知识 SESSION 和 COOKIE 的区别
1,session 在服务器端,cookie 在客户端(浏览器)2,session 默认被存在在服务器的一个文件里(不是内存)3,session 的运行依赖 session id,而 session ...
- 当在命令行中执行virtualenv venv时报此错误:'utf-8' codec can't decode byte 0xd5 in position 38: invalid continuation by
1.windows中安装虚拟环境virtualenv时, 当在命令行中执行virtualenv venv时报此错误:'utf-8' codec can't decode byte 0xd5 in po ...