
学习进度-10 python爬虫
学习爬虫的第一个案例是小说爬虫。
小说爬虫首先是解析小说页面源代码,在页面源代码中可以看到小说每章节的内容链接
爬虫的代码:
import requests

import re

url = 'http://www.92kshu.cc/69509/'

response = requests.get(url)

response.encoding = 'gbk'

html = response.text

title = re.findall(r'<meta property="og:novel:book_name" content="(.*?)"/>', html)[0]

fb = open('%s.txt' % title, 'w', encoding='utf-8')

# 获取每章的内容

# print(html)

dl = re.findall(r'<dl><dt><i class="icon"></i>正文</dt>(.*?)</dl>', html)[0]

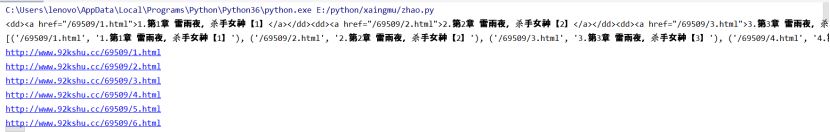
print(dl)

chapter_info_list = re.findall(r'<dd><a href="(.*?)">(.*?)</a></dd>', dl)

print(chapter_info_list)

for chapter_info in chapter_info_list:

    chapter_url, chapter_title = chapter_info

    chapter_url = "http://www.92kshu.cc%s" % chapter_url

    # print(chapter_url)

    chapter_response = requests.get(chapter_url)

    chapter_response.encoding = 'gbk'

    chapter_html = chapter_response.text

    chapter_content = re.findall(r'<div class="chapter">(.*?)><br>', chapter_html)[0]

    # print(chapter_content)

    chapter_content = chapter_content.replace('<p>', '')

    chapter_content = chapter_content.replace('</p>', '')

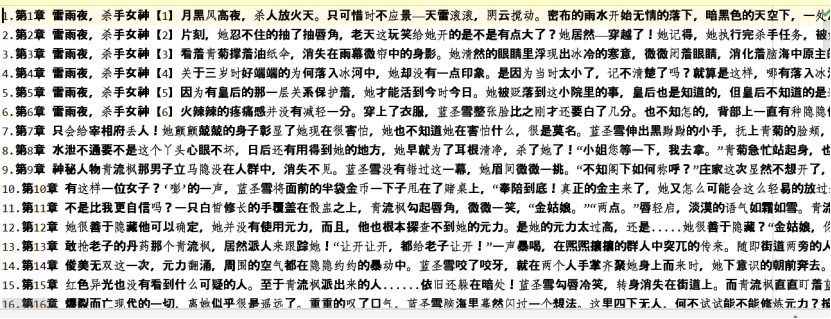
    fb.write(chapter_title)

    fb.write(chapter_content)

    fb.write('\n')

    print(chapter_url)
爬虫结果:

学习进度-10 python爬虫的更多相关文章
- 学习进度-16 python爬虫
爬虫是一个程序,这个程序的目的就是为了抓取万维网信息资源,比如你日常使用的谷歌等搜索引擎,搜索结果就全都依赖爬虫来定时获取 从百度可以看出来 爬虫与python关系很紧密, 爬虫的目标对象也很丰富,不 ...
- 学习笔记之Python爬虫
Python 爬虫介绍 | 菜鸟教程 http://www.runoob.com/w3cnote/python-spider-intro.html https://blog.csdn.net/sina ...
- Python学习:10.Python装饰器讲解(一)
情景介绍 一天,在你正在努力加班的时候,老板给交给你了一个任务,就是在这段代码里将所有函数开始输出一个‘hello’最后输出当前时间,再输出一个“end”,这段代码里包含了大量的函数,你会怎么做? d ...
- 学习笔记10—Python 绘图集
ordered_data = np.load('ordered_data_just_TD_mae.npy')results = pd.Series(np.squeeze(np.load('result ...
- 吴裕雄--天生自然python学习笔记:python爬虫PM2.5 实时监测显示器
PM2.5 对人体的健康影响很大,所以空气中的 PM2.5 实时信息受到越来越多的关注. Python 的 Pandas 套件不但可以自动读取网页中的表格 数据 , 还可对数据进行修改.排序等处理,也 ...
- 吴裕雄--天生自然python学习笔记:python爬虫与网页分析
我们所抓取的网页源代码一般都是 HTML 格式的文件,只要研究明白 HTML 中 的标签( Tag )结构,就很容易进行解析并取得所需数据 . HTML 网页结构 HTML 网 页是由许多标签( Ta ...
- 【Python爬虫】入门知识
爬虫基本知识 这阵子需要用爬虫做点事情,于是系统的学习了一下python爬虫,觉得还挺有意思的,比我想象中的能干更多的事情,这里记录下学习的经历. 网上有关爬虫的资料特别多,写的都挺复杂的,我这里不打 ...
- python爬虫小实例
1.python爬取贴吧壁纸 1.1.获取整个页面数据 #coding=utf-8 import urllib def getHtml(url): page = urllib.urlopen(url) ...
- 【学习笔记】PYTHON网络爬虫与信息提取(北理工 嵩天)
学习目的:掌握定向网络数据爬取和网页解析的基本能力the Website is the API- 1 python ide 文本ide:IDLE,Sublime Text集成ide:Pychar ...
随机推荐
- vue.js 强行赋值、刷新数组或者对象 方法之 $.set()
实际开发过程中,数据交互的的时候需要赋值,刷新,但是不可能每次赋值之后都刷新整个页面,所以就要用到 vue.js方法 $.set(),能实现赋值对象的局部刷新 语法:Vue.set(object, k ...
- 【摘录自MDN】对事件冒泡和捕捉的解释
当一个事件触发了一个有父元素的元素(例如我们的<video>时),现代浏览器运行两个不同的阶段 - 捕获阶段和冒泡阶段. 在捕获阶段: 浏览器检查元素的最外层祖先(<html> ...
- String类为什么是不可变的
String类为啥是final的? 我们找到string的jdk源码 1.看到String类被final修饰.这里你就要说出被final修饰的类不能被继承,方法不能被重写,变量不能被修改. 2.看到f ...
- win10 免安装版本的MySQL的下载安装和配置
一.概述 网上找了好多,发现好多不是linux系统的就是与现在新版本有出入,自己做小项目亲手实践了一下,供大家借鉴. MySQL版本:mysql-5.7.17 下载方法: 1.MySQL官方网址htt ...
- day5-2正则表达式
正则表达式: 正则表达式对象的创建 1,构造函数 var pattern =new RegExp("正则表达式","修饰符") var pattern =new ...
- navicat连接数据库报错:未发现数据源名称并且未指定默认驱动程序
解决方法:安装navicat自带sqlncli_x64.msi,在navicat安装目录下
- spring demo
参考: https://www.tutorialspoint.com/spring/spring_applicationcontext_container.htm
- Python中的进制表示方式及转换方法
在Python中,非十进制数字的表示方式为: 二进制:前面加0b,如0b1001 八进制:前面加0o,如0o3562 十六进制:前面加0x,如0x2af3 不同进制数字可直接进行数学计算,结果返回十进 ...
- NB-IOT学习
一 信号穿透力强,覆盖面广(基站少成本低).低功耗(eDRX/PSM省电技术).适合小流量时延要求不高(10s.) 二 主要芯片: 华为:Hi2110/2115,基于此的模组有:中移的M5310 移芯 ...
- Session 'app': Error Installing APKs app 在手机或虚拟机上调试报错
解决方案: build --clean project