
Spark SQL大数据处理并写入Elasticsearch
SparkSQL(Spark用于处理结构化数据的模块)
通过SparkSQL导入的数据可以来自MySQL数据库、Json数据、Csv数据等,通过load这些数据可以对其做一系列计算
下面通过程序代码来详细查看SparkSQL导入数据并写入到ES中:
数据集:北京市PM2.5数据
Spark版本:2.3.2
Python版本:3.5.2
mysql-connector-java-8.0.11 下载
ElasticSearch:6.4.1
Kibana:6.4.1
elasticsearch-spark-20_2.11-6.4.1.jar 下载
具体代码:
 # coding: utf-8

 import sys

 import os

 pre_current_dir = os.path.dirname(os.getcwd())

 sys.path.append(pre_current_dir)

 from pyspark.sql import SparkSession

 from pyspark.sql.types import *

 from pyspark.sql.functions import udf

 from settings import ES_CONF

 current_dir = os.path.dirname(os.path.realpath(__file__))

 spark = SparkSession.builder.appName("weather_result").getOrCreate()

 def get_health_level(value):

     """

     PM2.5对应健康级别

     :param value:

     :return:

     """

     if 0 <= value <= 50:

         return "Very Good"

     elif 50 < value <= 100:

         return "Good"

     elif 100 < value <= 150:

         return "Unhealthy for Sensi"

     elif value <= 200:

         return "Unhealthy"

     elif 200 < value <= 300:

         return "Very Unhealthy"

     elif 300 < value <= 500:

         return "Hazardous"

     elif value > 500:

         return "Extreme danger"

     else:

         return None

 def get_weather_result():

     """

     获取Spark SQL分析后的数据

     :return:

     """

     # load所需字段的数据到DF

     df_2017 = spark.read.format("csv") \

         .option("header", "true") \

         .option("inferSchema", "true") \

         .load("file://{}/data/Beijing2017_PM25.csv".format(current_dir)) \

         .select("Year", "Month", "Day", "Hour", "Value", "QC Name")

     # 查看Schema

     df_2017.printSchema()

     # 通过udf将字符型health_level转换为column

     level_function_udf = udf(get_health_level, StringType())

     # 新建列healthy_level 并healthy_level分组

     group_2017 = df_2017.withColumn(

         "healthy_level", level_function_udf(df_2017['Value'])

     ).groupBy("healthy_level").count()

     # 新建列days和percentage 并计算它们对应的值

     result_2017 = group_2017.select("healthy_level", "count") \

         .withColumn("days", group_2017['count'] / 24) \

         .withColumn("percentage", group_2017['count'] / df_2017.count())

     result_2017.show()

     return result_2017

 def write_result_es():

     """

     将SparkSQL计算结果写入到ES

     :return:

     """

     result_2017 = get_weather_result()

     # ES_CONF配置 ES的node和index

     result_2017.write.format("org.elasticsearch.spark.sql") \

         .option("es.nodes", "{}".format(ES_CONF['ELASTIC_HOST'])) \

         .mode("overwrite") \

         .save("{}/pm_value".format(ES_CONF['WEATHER_INDEX_NAME']))

 write_result_es()

 spark.stop()
将mysql-connector-java-8.0.11和elasticsearch-spark-20_2.11-6.4.1.jar放到Spark的jars目录下,提交spark任务即可。
注意:
(1) 如果提示:ClassNotFoundException Failed to find data source: org.elasticsearch.spark.sql.,则表示spark没有发现jar包,此时需重新编译pyspark:
cd /opt/spark-2.3.2-bin-hadoop2.7/python

python3 setup.py sdist

pip install dist/*.tar.gz
(2) 如果提示:Multiple ES-Hadoop versions detected in the classpath; please use only one ,
则表示ES-Hadoop jar包有多余的,可能既有elasticsearch-hadoop,又有elasticsearch-spark,此时删除多余的jar包,重新编译pyspark 即可
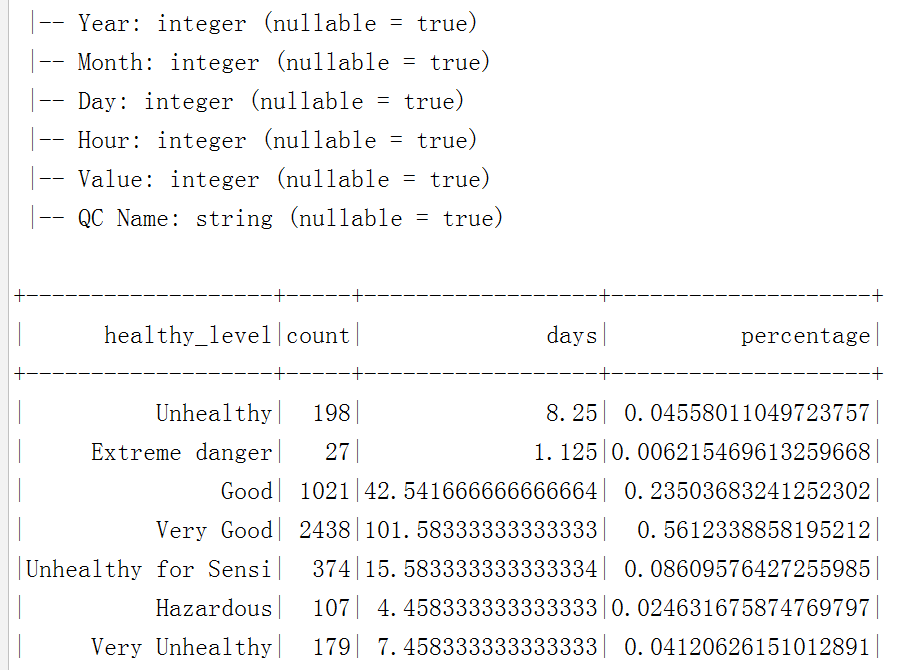
执行效果:
更多源码请关注我的github, https://github.com/a342058040/Spark-for-Python ,Spark相关技术全程用python实现,持续更新
Spark SQL大数据处理并写入Elasticsearch的更多相关文章
- Spark SQL JSON数据处理
背景 这一篇可以说是“Hive JSON数据处理的一点探索”的兄弟篇. 平台为了加速即席查询的分析效率,在我们的Hadoop集群上安装部署了Spark Server,并且与我们的Hive数据仓 ...
- 大数据实时处理-基于Spark的大数据实时处理及应用技术培训
随着互联网.移动互联网和物联网的发展,我们已经切实地迎来了一个大数据 的时代.大数据是指无法在一定时间内用常规软件工具对其内容进行抓取.管理和处理的数据集合,对大数据的分析已经成为一个非常重要且紧迫的 ...
- Spark官方1 ---------Spark SQL和DataFrame指南(1.5.0)
概述 Spark SQL是用于结构化数据处理的Spark模块.它提供了一个称为DataFrames的编程抽象,也可以作为分布式SQL查询引擎. Spark SQL也可用于从现有的Hive安装中读取数据 ...
- [转] Spark sql 内置配置(V2.2)
[From] https://blog.csdn.net/u010990043/article/details/82842995 最近整理了一下spark SQL内置配.加粗配置项是对sparkSQL ...
- 第五章 大数据平台与技术 第12讲 大数据处理平台Spark
Spark支持多种的编程语言 对比scala和Java编程上节课的计数程序.相比之下,scala简洁明了. Hadoop的IO开销大导致了延迟高,也就是说任务和任务之间涉及到I/O操作.前一个任务完成 ...
- 流式大数据处理的三种框架:Storm,Spark和Samza
许多分布式计算系统都可以实时或接近实时地处理大数据流.本文将对三种Apache框架分别进行简单介绍,然后尝试快速.高度概述其异同. Apache Storm 在Storm中,先要设计一个用于实时计算的 ...
- [转载]流式大数据处理的三种框架:Storm,Spark和Samza
许多分布式计算系统都可以实时或接近实时地处理大数据流.本文将对三种Apache框架分别进行简单介绍,然后尝试快速.高度概述其异同. Apache Storm 在Storm中,先要设计一个用于实时计算的 ...
- 《Spark大数据处理:技术、应用与性能优化 》
基本信息 作者: 高彦杰 丛书名:大数据技术丛书 出版社:机械工业出版社 ISBN:9787111483861 上架时间:2014-11-5 出版日期:2014 年11月 开本:16开 页码:255 ...
- Spark大数据处理技术
全球首部全面介绍Spark及Spark生态圈相关技术的技术书籍 俯览未来大局,不失精细剖析,呈现一个现代大数据框架的架构原理和实现细节 透彻讲解Spark原理和架构,以及部署模式.调度框架.存储管理及 ...
随机推荐
- 电脑重装系统后如何恢复 Mysql 数据库
电脑重装系统后如何恢复 Mysql 数据库 一.[设置mysql的path] 比如:我的mysql在:D:\DataBase\mysql-5.7.13-winx64,可以在环境变量中重新新建一个环境变 ...
- GitHub最基本使用总结
GitHub最基本使用入门 入门必看博客:https://mp.weixin.qq.com/s/LbzSwl4dYwrSPze0w10l8w 一.Git Linux安装 Git Linux安装教程:h ...
- VScode中python环境配置
vscode中python环境配置 想要在vscode中运行python代码必须要告诉vscode使用哪个解释器才行 方法1. 打开命令面板(Ctrl+Shift+P)输入Python: Select ...
- emwin 之模态窗口
@2019-02-27 [小记] emwin 窗口被模态之后,创建子窗口则原模态窗口变为非模态
- 【.net】ASP.Net设置和取消设置web项目起始页
#在visual studio中设置和取消web项目的起始页 方法一:在所要设置的页面上右键->设为起始页 方法二:web项目上右键->属性页 website项目: tips:如果取消要取 ...
- linux下安装与配置Redis
1.安装 (1)获取源代码 wget http://download.redis.io/releases/redis-4.0.8.tar.gz (2)解压 tar xzvf redis-4.0.8.t ...
- [再寄小读者之数学篇](2014-06-27 向量公式: The Hall term)
$$\bex \n\cdot{\bf b}=0\ra \n\times [(\n\times {\bf b})\times {\bf b}]=\n\times [\n\cdot ({\bf b}\ot ...
- 【webpack】中file-loader和url-loader使用方法
file-loader 可以指定要复制和放置资源文件的位置,以及如何使用版本哈希命名以获得更好的缓存.此外,这意味着 你可以就近管理图片文件,可以使用相对路径而不用担心部署时 URL 的问题.使用正确 ...
- PYthon3:函数实现“自动售卖机”功能
题目: 自动贩卖机: # 只接受1元.5元.10元的纸币或硬币,可以1块,5元,10元.# 饮料只有橙汁.椰汁.矿泉水.早餐奶,售价分别是3.5,4,2,4.5# 写一个函数用来表示贩卖机的功能:用户 ...
- 【Java编程思想笔记】注解1-简单了解注解
文章参考:https://www.cnblogs.com/xuningchuanblogs/p/7763225.html https://www.cnblogs.com/xdp-gacl/p/3622 ...