
流式大数据处理的三种框架:Storm,Spark和Samza
Apache Storm

Apache Spark

Apache Samza
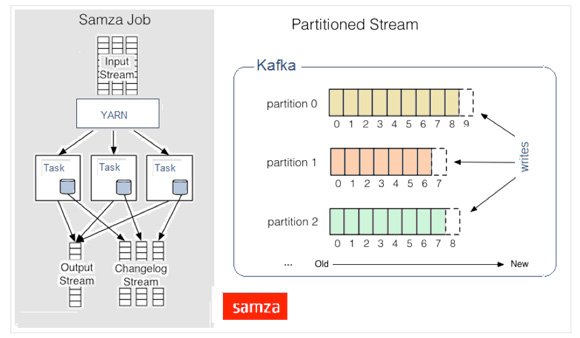
共同之处

对比图
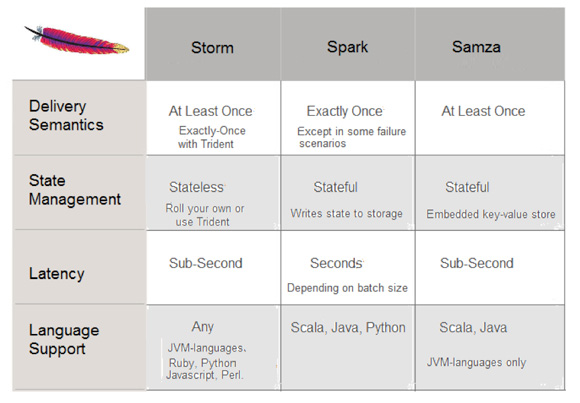
- 最多一次(At-most-once):消息可能会丢失,这通常是最不理想的结果。
- 最少一次(At-least-once):消息可能会再次发送(没有丢失的情况,但是会产生冗余)。在许多用例中已经足够。
- 恰好一次(Exactly-once):每条消息都被发送过一次且仅仅一次(没有丢失,没有冗余)。这是最佳情况,尽管很难保证在所有用例中都实现。
用例

使用Storm的公司有:Twitter,雅虎,Spotify还有The Weather Channel等。
使用Spark的公司有:亚马逊,雅虎,NASA JPL,eBay还有百度等。
使用Samza的公司有:LinkedIn,Intuit,Metamarkets,Quantiply,Fortscale等。
结论
流式大数据处理的三种框架:Storm,Spark和Samza的更多相关文章
- [转载]流式大数据处理的三种框架:Storm,Spark和Samza
许多分布式计算系统都可以实时或接近实时地处理大数据流.本文将对三种Apache框架分别进行简单介绍,然后尝试快速.高度概述其异同. Apache Storm 在Storm中,先要设计一个用于实时计算的 ...
- 大数据处理的三种框架:Storm,Spark和Samza
许多分布式计算系统都可以实时或接近实时地处理大数据流.下面对三种Apache框架分别进行简单介绍,然后尝试快速.高度概述其异同. Apache Storm 在Storm中,先要设计一个用于实时计算的图 ...
- 翻译-In-Stream Big Data Processing 流式大数据处理
相当长一段时间以来,大数据社区已经普遍认识到了批量数据处理的不足.很多应用都对实时查询和流式处理产生了迫切需求.最近几年,在这个理念的推动下,催生出了一系列解决方案,Twitter Storm,Yah ...
- storm流式大数据处理流行吗
在如今这个信息高速增长的今天,信息实时计算处理能力已经是一项专业技能了,正是因为有了这些需求的存在才使得分布式,同时具备高容错的实时计算系统Storm才变得如此受欢迎,为什么这么说呢?下面看看新霸哥的 ...
- flink 流式处理中如何集成mybatis框架
flink 中自身虽然实现了大量的connectors,如下图所示,也实现了jdbc的connector,可以通过jdbc 去操作数据库,但是flink-jdbc包中对数据库的操作是以ROW来操作并且 ...
- 流式大数据计算实践(1)----Hadoop单机模式
一.前言 1.从今天开始进行流式大数据计算的实践之路,需要完成一个车辆实时热力图 2.技术选型:HBase作为数据仓库,Storm作为流式计算框架,ECharts作为热力图的展示 3.计划使用两台虚拟 ...
- 国内常用的三种框架:ionic/mui/framework7对比
国内常用的三种框架:ionic/mui/framework7对比 原文连接:http://zhihu.com/question/19558750/answer/91179040
- Struts中的数据处理的三种方式
Struts中的数据处理的三种方式: public class DataAction extends ActionSupport{ @Override public String execute() ...
- 流式大数据计算实践(6)----Storm简介&使用&安装
一.前言 1.这一文开始进入Storm流式计算框架的学习 二.Storm简介 1.Storm与Hadoop的区别就是,Hadoop是一个离线执行的作业,执行完毕就结束了,而Storm是可以源源不断的接 ...
随机推荐
- mySQL中如何给某一IP段的用户授权?
给一个用用户use ip: 192.168.0.1 语句是: grant all on *.* to root@192.168.0.1 identified by 'pass' 来授权 其中:root ...
- AFNetworking请求设置请求头
NSString *url = @"INPUT URL HERE"; AFHTTPRequestOperationManager *manager = [AFHTTPRequest ...
- C#4.0图解教程 - 第24章 反射和特性 - 1.反射
24.1 元数据和反射 有关程序及类型的数据被成为 元数据.他们保存在程序集中. 程序运行时,可以查看其他程序集或其本身的元数据.一个运行的程序查看本身元数据或其他程序的元数据的行为叫做 反射. 24 ...
- 【javascript】 for循环小技巧
最近在读[Jquery技术内幕],里面介绍了一种js for循环的实用写法. 一般写for循环是这么写的: var elemts = [1,2,3,4,5]; for(var i=0; i<el ...
- Power BI for Office 365介绍
微软在七月份发布了一个新产品,它建立在微软的云的第一个数据平台- Power BI for Office 365.Satya Nadella,服务器和工具业务总裁,在当天的上午在微软的年度全球合作伙伴 ...
- 攻城狮在路上(壹) Hibernate(十一)--- 映射实体关联关系
本文以Customer和Address类的关系为例说明一对一关联映射:以Category和Item类的关系说明多对多关联关系.一.映射一对一关联: 分两种情况:按照外键映射和按照主键映射.这两种方式的 ...
- Linux下修改默认字符集--->解决Linux下Java程序种中文文件夹file.isDirectory()判断失败的问题
一.问题描述: 一个项目中为了生成树状目录,调用了file.listFiles()方法,然后利用file.isDirectory()方法判断是否为目录,该程序在windows下运行无问题,在Linux ...
- 初识VSTO Addin开发
这篇博客将简单介绍一些VSTO Addin开发的知识. 1. VSTO是什么?我们可以用VSTO做什么? VSTO全称Visual Studio Tool for Office,是可以让我们针对现有的 ...
- ubuntu中禁用华硕S550C触摸屏的方法
华硕S550C的触摸屏被我一不小心弄了一条裂缝,导致屏幕一直会莫名其妙自动进行点击,严重影响了使用.在windows 系统下通过FN+F7的快捷键可以直接禁用触摸屏,但是换成ubuntu 系统之后,快 ...
- 如何在Salesforce中进行代码开发
两种方式: 1):用Salesforce自带的在线开发模式 Setup --> App Setup --> Develop --> than you can select 'Page ...