
Lucene 分词
在Lucene中很多数据是通过Attribute进行存储的
步骤是同过TokenStrem获取文本信息流
TokenStream stream = a.tokenStream("content", new StringReader(str)); (a:指的是Analyzer)
而在这里对这个由不同的分词的话之需要实现Analyer,并重写里面的tokenStream 方法
public TokenStream tokenStream(String fieldName, Reader reader) {
Dictionary dic = Dictionary.getInstance("F:\\CheckOut\\Lucene\\03_lucene_analyzer\\mmseg4j-1.8.4\\data");
return new MySameTokenFilter(new MMSegTokenizer(new MaxWordSeg(dic), reader),samewordContext);
}
然后这里获取他的Tokenizer 并可以实现自己的过滤器,以及相应的同义词删减
public class MySameTokenFilter extends TokenFilter{

    private CharTermAttribute cta = null;

    private PositionIncrementAttribute pia = null;

    private AttributeSource.State current = null;

    private Stack<String> sames = null;

    private SamewordContext samewordContext;

    protected MySameTokenFilter(TokenStream input,SamewordContext samewordContext) {

        super(input);

        cta = this.addAttribute(CharTermAttribute.class);

        pia = this.addAttribute(PositionIncrementAttribute.class);

        sames = new Stack<String>();

        this.samewordContext=samewordContext;

    }

    /**

     * 思想如下:

     * 其实每个同义词都要放在CharTermAttribute里面,但是如果直接cta.append("大陆");的话

     * 那会直接把原来的词和同义词连接在同一个语汇单元里面[中国大陆],这样是不行的

     * 要的是这样的效果[中国][大陆]

     * 那么就要在遇到同义词的时候把当前的状态保存一份,并把同义词的数组放入栈中,

     * 这样在下一个语汇单元的时候判断同义词数组是否为空,不为空的话把之前的保存的一份状态

     * 还原,然后在修改之前状态的值cta.setEmpty(),然后在把同义词的值加入cta.append("大陆")

     * 再把位置增量设为0,pia.setPositionIncrement(0),这样的话就表示是同义词,

     * 接着把该同义词的语汇单元返回

     */

    @Override

    public boolean incrementToken() throws IOException {

        System.out.println("yaobo");

        while(sames.size() > ){

            //将元素出栈,并获取这个同义词

            String str = sames.pop();

            //还原状态

            restoreState(current);

            cta.setEmpty();

            cta.append(str);

            //设置位置

            pia.setPositionIncrement();

            return true;

        }

        if(!input.incrementToken()) return false;

        if(addSames(cta.toString())){

            //如果有同义词将当前状态先保存

            current = captureState();

        }

        return true;

    }

/*

 * 使用这种方式是不行的,这种会把的结果是[中国]替换成了[大陆]

 * 而不是变成了[中国][大陆]

    @Override

    public boolean incrementToken() throws IOException {

        if(!input.incrementToken()) return false;

        if(cta.toString().equals("中国")){

            cta.setEmpty();

            cta.append("大陆");

        }

        return true;

    }

*/

    private boolean addSames(String name){

        String[] sws = samewordContext.getSamewords(name);

        if(sws != null){

            for(String s : sws){

                sames.push(s);

            }

            return true;

        }

        return false;

    }

}
其思想如下
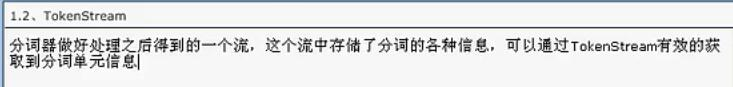
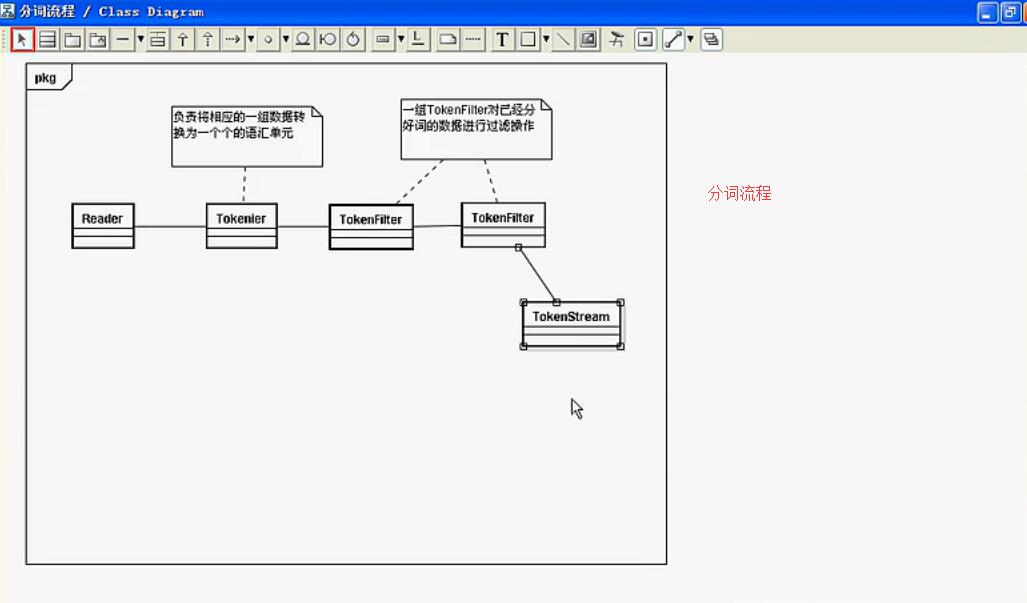
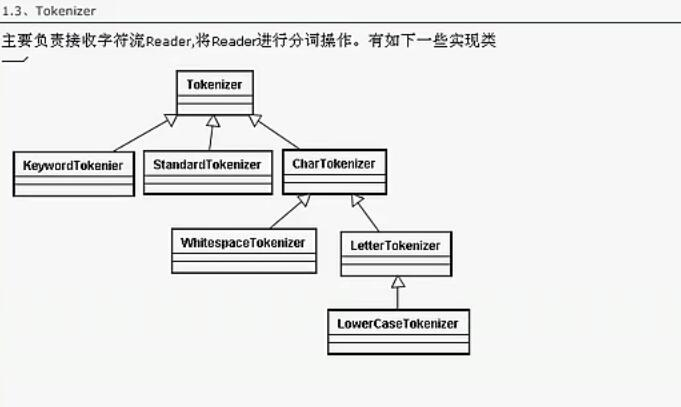

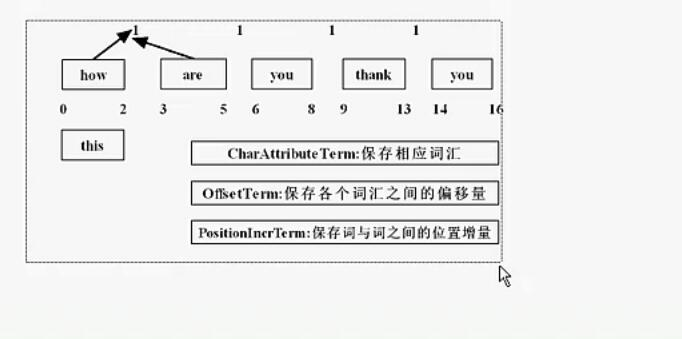
然后通过不同的Attribute进行分割
TokenStream stream = a.tokenStream("content", new StringReader(str));
//位置增量
PositionIncrementAttribute pia = stream.addAttribute(PositionIncrementAttribute.class);
//偏移量
OffsetAttribute oa = stream.addAttribute(OffsetAttribute.class);
//词元
CharTermAttribute cta = stream.addAttribute(CharTermAttribute.class);
//分词的类型
TypeAttribute ta = stream.addAttribute(TypeAttribute.class);
Lucene 分词的更多相关文章
- Lucene学习-深入Lucene分词器,TokenStream获取分词详细信息
Lucene学习-深入Lucene分词器,TokenStream获取分词详细信息 在此回复牛妞的关于程序中分词器的问题,其实可以直接很简单的在词库中配置就好了,Lucene中分词的所有信息我们都可以从 ...
- Hibernate Search集与lucene分词查询
lucene分词查询参考信息:https://blog.csdn.net/dm_vincent/article/details/40707857
- Lucene系列三:Lucene分词器详解、实现自己的一个分词器
一.Lucene分词器详解 1. Lucene-分词器API (1)org.apache.lucene.analysi.Analyzer 分析器,分词器组件的核心API,它的职责:构建真正对文本进行分 ...
- WebGIS中兴趣点简单查询、基于Lucene分词查询的设计和实现
文章版权由作者李晓晖和博客园共有,若转载请于明显处标明出处:http://www.cnblogs.com/naaoveGIS/. 1.前言 兴趣点查询是指:输入框中输入地名.人名等查询信息后,地图上可 ...
- lucene 分词实现
一.概念认识 1.常用的Analyer SimpleAnalyzer.StopAnalyzer.WhitespaceAnalyzer.StandardAnalyzer 2.TokenStream 分词 ...
- lucene分词器与搜索
一.分词器 lucene针对不同的语言和虚伪提供了许多分词器,我们可以针对应用的不同的需求使用不同的分词器进行分词.我们需要注意的是在创建索引时使用的分词器与搜索时使用的分词器要保持一致.否则搜索的结 ...
- 全文索引(三)lucene 分词 Analyzer
分词: 将reader通过阅读对象Analyzer字处理,得到TokenStream处理流程被称为分割. 该解释可能是太晦涩.查看示例,这个东西是什么感性的认识. 样品:一段文本"this ...
- lucene分词多种方法
目前最新版本的lucene自身提供的StandardAnalyzer已经具备中文分词的功能,但是不一定能够满足大多数应用的需要.另外网友谈的比较多的中文分词器还有:CJKAnalyzerChinese ...
- Lucene分词详解
分词和查询都是以词项为基本单位,词项是词条化的结果.在Lucene中分词主要依靠Analyzer类解析实现.Analyzer类是一个抽象类,分词的具体规则是由子类实现的,所以对于不同的语言规则,要有不 ...
- 学习笔记(三)--Lucene分词器详解
Lucene-分词器API org.apache.lucene.analysi.Analyzer 分析器,分词器组件的核心API,它的职责:构建真正对文本进行分词处理的TokenStream(分词处理 ...
随机推荐
- 针对shiro框架authc拦截器认证成功后跳转到根目录,而非指定路径问题
一.针对shiro框架authc拦截器认证成功后跳转到根目录,而非指定路径问题 首先,我们先来了解一下authc登录拦截器工作原理 authc拦截器有2个作用: 1>登录认证 请求进来时 ...
- [译]C语言实现一个简易的Hash table(7)
上一章我们讲了如何根据需要动态设置hash表的大小,在第四章中,我们使用了双重哈希来解决hash表的碰撞,其实解决方法有很多,这一章我们来介绍下其他方法. 本章将介绍两种解决hash表碰撞的方法: 拉 ...
- Python学习之——Python安装
环境:Centos6.5+python2.7.5 1.centons6.5系统中是已经安装了python的,先查看版本是不是需要的 python --version 2.安装一些必要的包,防止后面需要 ...
- 20155202张旭 2016-2017-2 《Java程序设计》第2周学习总结
20155202张旭 2016-2017-2 <Java程序设计>第2周学习总结 教材学习内容总结 第一,二章知识小节: git log 命令来查看 :提交历史 查看当前所处位置: pwd ...
- 20155235 2016-2017-2 《Java程序设计》第十周学习总结
20155235 2016-2017-2 <Java程序设计>第十周学习总结 教材学习内容总结 计算机网络 计算机网络由若干结点和连接这些结点的链路组成.网络中的结点可以是计算机.集线器. ...
- 20155316 2016-2017-2 《Java程序设计》第1周学习总结
学习内容总结 在linux的环境下学习怎么安git.jdk.Intellj IDEA 精读教材1.2章 课前准备部分 git的学习 学习进度 系统学习学到创建版本库-廖雪峰的官方网站 git推送学到最 ...
- sougoupinyin for linux 安装步骤(精简版)
download deb double-click to install select fcitx reboot click it in the bar and choose the"tex ...
- Wiki版产品需求---产品需求文档到底是谁的?产品到底是谁的?
在听了测试的一通唠叨之后,"内部实现一堆逻辑,只有一句话的需求文档","文档那么简单,我们怎么测试啊",心中突然想起来自己曾经干的一件当时觉得还不错的事情,但是 ...
- Android开发——支付宝和微信支付快速接入流程
一.Android快速实现支付宝支付 1.首先,我们需要前往支付宝开放平台,申请我们的支付功能:https://open.alipay.com/platform/home.htm 支付宝首页 这里 有 ...
- [arc067F]Yakiniku Restaurants[矩阵差分]
Description 传送门 Solution 假如我们确定了烧烤店区间[l,r],则票j必定会选择在B[i][j](l<=i<=r)最大的烧烤店使用. 反过来想,我们想要票j在第i个烧 ...