
lucene分词器与搜索
一、分词器
lucene针对不同的语言和虚伪提供了许多分词器,我们可以针对应用的不同的需求使用不同的分词器进行分词。我们需要注意的是在创建索引时使用的分词器与搜索时使用的分词器要保持一致。否则搜索的结果就不是我们期望的结果。lucene提供的常规分词器如下:
相关分词器示例如下:
 package com.test.lucene;

 import java.io.IOException;

 import java.io.StringReader;

 import org.apache.lucene.analysis.Analyzer;

 import org.apache.lucene.analysis.TokenStream;

 import org.apache.lucene.analysis.cjk.CJKAnalyzer;

 import org.apache.lucene.analysis.cn.smart.SmartChineseAnalyzer;

 import org.apache.lucene.analysis.core.KeywordAnalyzer;

 import org.apache.lucene.analysis.core.SimpleAnalyzer;

 import org.apache.lucene.analysis.core.StopAnalyzer;

 import org.apache.lucene.analysis.core.WhitespaceAnalyzer;

 import org.apache.lucene.analysis.standard.StandardAnalyzer;

 import org.apache.lucene.analysis.tokenattributes.CharTermAttribute;

 /**

  * 分词器

  */

 public class AnalyzerStudy {

     /**

      * 分词并打印分词结果

      *

      * @param analyzer

      *            分词器种类

      * @param content

      *            需要分词的内容

      */

     private static void print(Analyzer analyzer, String content) {

         StringReader reader = new StringReader(content);

         try {

             TokenStream tokenStream = analyzer.tokenStream("", reader);

             tokenStream.reset();

             CharTermAttribute term = tokenStream.getAttribute(CharTermAttribute.class);

             System.out.println("分词技术" + analyzer.getClass());

             while (tokenStream.incrementToken()) {

                 System.out.print(term.toString() + "|");

             }

             System.out.println();

         } catch (IOException e) {

             e.printStackTrace();

         }

     }

     public static void main(String[] args) {

         String content = "上海广州, lucene 软件 开发";

         Analyzer analyzer = null;

         // 标准分词

         analyzer = new StandardAnalyzer();

         print(analyzer, content);

         // 空格分词

         analyzer = new WhitespaceAnalyzer();

         print(analyzer, content);

         // 简单分词

         analyzer = new SimpleAnalyzer();

         print(analyzer, content);

         // 二分法分词

         analyzer = new CJKAnalyzer();

         print(analyzer, content);

         // 关键字分词

         analyzer = new KeywordAnalyzer();

         print(analyzer, content);

         // 被忽略词分词

         analyzer = new StopAnalyzer();

         print(analyzer, content);

         // 中文分词

         analyzer = new SmartChineseAnalyzer();

         print(analyzer, content);

     }

 }
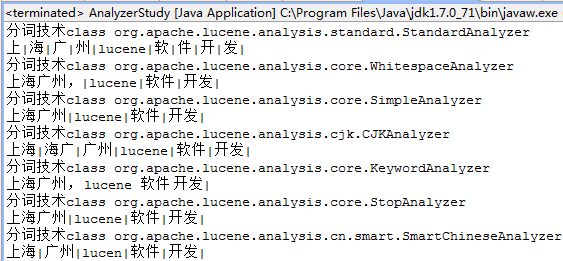
运行结果如下:
二、搜索条件
在有些应用场景中,我们需要在搜索的时候,使用多个条件进行查询。此时我们可以使用lucene提供的搜索条件进行搜索。如对多个域进行查询、前缀查询、通配符查询等。
相关示查询例如下:
 package com.test.lucene;

 import org.apache.lucene.analysis.Analyzer;

 import org.apache.lucene.analysis.standard.StandardAnalyzer;

 import org.apache.lucene.index.Term;

 import org.apache.lucene.queryparser.classic.MultiFieldQueryParser;

 import org.apache.lucene.queryparser.classic.ParseException;

 import org.apache.lucene.queryparser.classic.QueryParser;

 import org.apache.lucene.search.BooleanClause.Occur;

 import org.apache.lucene.search.BooleanQuery;

 import org.apache.lucene.search.PhraseQuery;

 import org.apache.lucene.search.PrefixQuery;

 import org.apache.lucene.search.Query;

 import org.apache.lucene.search.TermQuery;

 import org.apache.lucene.search.TermRangeQuery;

 /**

  * 查询条件

  */

 public class QueryStudy {

     public static void main(String[] args) {

         // 搜索关键词

         String keyword = "上海";

         // 搜索域名

         String field = "name";

         // 搜索多个域的域名数组

         String[] fields = { "name", "content" };

         // Query 创建过程中的分词技术

         Analyzer analyzer = new StandardAnalyzer();

         Query query = null;

         // 对单个域创建查询语句

         QueryParser parser = new QueryParser(field, analyzer);

         try {

             query = parser.parse(keyword);

         } catch (ParseException e) {

             e.printStackTrace();

         }

         System.out.println(QueryParser.class + " " + query.toString());

         // 对多个域创建查询语句

         MultiFieldQueryParser parser2 = new MultiFieldQueryParser(fields, analyzer);

         try {

             query = parser2.parse(keyword);

         } catch (ParseException e) {

             e.printStackTrace();

         }

         System.out.println(MultiFieldQueryParser.class + " " + query.toString());

         // 词条查询语句

         query = new TermQuery(new Term(field, keyword));

         System.out.println(TermQuery.class + " " + query.toString());

         // 前缀查询语句

         query = new PrefixQuery(new Term(field, keyword));

         System.out.println(PrefixQuery.class + " " + query.toString());

         // 多余查询语句

         PhraseQuery query2 = new PhraseQuery();

         // 设置短语之间的最大距离

         query2.add(new Term(field, "上海"));

         query2.add(new Term(field, "lucene开发"));

         System.out.println(PhraseQuery.class + " " + query2.toString());

         // 通配符查询语句,Lucene中有 * ? 两个通配符, *表示任意多个字符,?表示一个任意字符

         query = TermRangeQuery.newStringRange(field, "abc", "azz", false, false);

         System.out.println(TermRangeQuery.class + " " + query.toString());

         // 布尔查询

         BooleanQuery query3 = new BooleanQuery();

         query3.add(new TermQuery(new Term(field, "上海")), Occur.SHOULD);

         query3.add(new TermQuery(new Term(field, "lucene")), Occur.SHOULD);

         query3.add(new TermQuery(new Term(field, "案例")), Occur.MUST_NOT);

         System.out.println(BooleanQuery.class + " " + query3.toString());

     }

 }
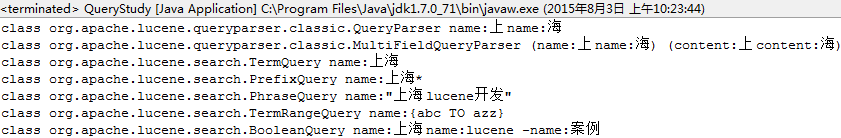
运行结果如下:
lucene分词器与搜索的更多相关文章
- Lucene学习-深入Lucene分词器,TokenStream获取分词详细信息
Lucene学习-深入Lucene分词器,TokenStream获取分词详细信息 在此回复牛妞的关于程序中分词器的问题,其实可以直接很简单的在词库中配置就好了,Lucene中分词的所有信息我们都可以从 ...
- Lucene系列三:Lucene分词器详解、实现自己的一个分词器
一.Lucene分词器详解 1. Lucene-分词器API (1)org.apache.lucene.analysi.Analyzer 分析器,分词器组件的核心API,它的职责:构建真正对文本进行分 ...
- lucene全文搜索之四:创建索引搜索器、6种文档搜索器实现以及搜索结果分析(结合IKAnalyzer分词器的搜索器)基于lucene5.5.3
前言: 前面几章已经很详细的讲解了如何创建索引器对索引进行增删查(没有更新操作).如何管理索引目录以及如何使用分词器,上一章讲解了如何生成索引字段和创建索引文档,并把创建的索引文档保存到索引目录,到这 ...
- lucene 分词器
分词器 作用:切分关键词的. 在什么地方使用到了:在建立索引和搜索时. 原文:An IndexWriter creates and maintains an index. 1,切分: An Index ...
- lucene分词器中的Analyzer,TokenStream, Tokenizer, TokenFilter
分词器的核心类: Analyzer:分词器 TokenStream: 分词器做优点理之后得到的一个流.这个流中存储了分词的各种信息,能够通过TokenStream有效的获取到分词单元. 下面是把文件流 ...
- 学习笔记(三)--Lucene分词器详解
Lucene-分词器API org.apache.lucene.analysi.Analyzer 分析器,分词器组件的核心API,它的职责:构建真正对文本进行分词处理的TokenStream(分词处理 ...
- Lucene分词器
Lucene分析器的基类为Analyzer,Analyzer包含两个核心组件:Tokenizer和 TokenFilter.自定义分析器必须实现Analyzer类的抽象方法createComponen ...
- Lucene.net(4.8.0)+PanGu分词器问题记录一:分词器Analyzer的构造和内部成员ReuseStategy
前言:目前自己在做使用Lucene.net和PanGu分词实现全文检索的工作,不过自己是把别人做好的项目进行迁移.因为项目整体要迁移到ASP.NET Core 2.0版本,而Lucene使用的版本是3 ...
- Lucene 03 - 什么是分词器 + 使用IK中文分词器
目录 1 分词器概述 1.1 分词器简介 1.2 分词器的使用 1.3 中文分词器 1.3.1 中文分词器简介 1.3.2 Lucene提供的中文分词器 1.3.3 第三方中文分词器 2 IK分词器的 ...
随机推荐
- 2016 年青岛网络赛---Family View(AC自动机)
题目链接 http://acm.hdu.edu.cn/showproblem.php?pid=5880 Problem Description Steam is a digital distribut ...
- ADO.NET(数据访问技术)
简单的说,C#已经内置了一些类,我们可以利用这些类来访问数据库.在这里,我们假设读者已经熟悉SqlServer数据库或者其它数据库(我以后也会补上相关内容).我们如何来实现这项技术呢?大致可以分为三个 ...
- 为友盟消息推送开发的PHP SDK(composer版):可以按省发Android push
一直以来APP希望按省市县推送Android push,只能自己分析用户经纬度,打tag发送. 现在终于有服务商提供了. 友盟消息推送 可以“按省推送”,很方便. 我为友盟做了PHP SDK(comp ...
- Xamarin 手动安装步骤+破解(最新版Xamarin V3)
Create native iOS, Android, Mac and Windows apps in C#. 看到这句话,你就知道Xamarin是什么了,对于C#开发者,这样的标语还是会让你激动一下 ...
- bootstrap源码分析之Carousel
源码文件: Carousel.scssCarousel.js 实现原理: 隐藏所有要显示的元素,然后指定当前要显示的为block,宽.高自适应 源码分析: 1.Html结构:主要分为以四个部分 1. ...
- 高性能javascript学习笔记系列(1) -js的加载和执行
这篇笔记的内容主要涉及js的脚本位置,如何加载js脚本和脚本文件执行的问题,按照自己的理解结合高性能JavaScript整理出来的 javascript是解释性代码,解释性代码需要经历转化成计算机指令 ...
- .net学习之路——调试程序
没有人的程序是完美的,这条规则对所有的程序员来说也成立.没有人能在第一次就写出完美的程序来. 调试工具分为两类,一类是被动的,你等待它们告诉你问题:还有一类是主动的,允许你在程序运行时深入观察,并在逐 ...
- javascript 函数初探 (六)--- 闭包初探#1
首先我们来看一个函数: var a = 'global variable'; var F = function(){ var b = 'local variable'; var N = functio ...
- HTML <base> 标签 为页面上的所有链接规定默认地址或默认目标
定义和用法 <base> 标签为页面上的所有链接规定默认地址或默认目标. 通常情况下,浏览器会从当前文档的 URL 中提取相应的元素来填写相对 URL 中的空白. 使用 <base& ...
- .NET破解之图片下载器
自去年五月加入吾爱后,学习了三个月,对逆向破解产生了深厚的兴趣,尤其是对.NET方面的分析:但由于这一年,项目比较忙,事情比较多,破解这方面又停滞了许久,不知道还要好久. 前些天,帮忙批量下载QQ相册 ...