
Pandas常用函数入门
一.Pandas
Python Data Analysis Library或Pandas是基于NumPy的一种工具,该工具是为了解决数据分析任务而创建的。Pandas纳入了大量库和一些标准的数据模型,提供了高效地操作大型数据集所需的工具。Pandas提供了大量能使我们快速便捷地处理数据的函数和方法。
二.Series
Series是一维数组,与Numpy中的一维array类似。二者与Python基本的数据结构List也很相近,其区别是List中的元素可以是不同的数据类型,而Array和Series中则只允许存储相同的数据类型。
1.创建
# 通过list创建Series

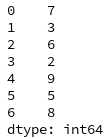
s1 = pd.Series([7, 3, 6, 2, 9, 5, 8])

# 通过dict创建Series

s2 = pd.Series({"a":1, "b":2, "c":3})

# 通过list创建Series,并指定index

s3 = pd.Series([5, 2, 7, 4],["a", "b", "c", "b"])
2.选取
# 获取前3个数据

s1.head(3)

# 获取后3个数据

s1.tail(3)

# 获取index为2的数据

s1[2]

# 获取1<=index<4的数据

s1[1:4]

# 获取index>3的数据

s1[s1.index>3]

# 获取数据值>5的数据

s1[s1>5]
3.增加、删除、修改
# 增加数据index=8

s1[8] = -1

# 删除数据index=3,不修改原Series

s1 = s1.drop(3)

# 对1<=index<3的数据赋值30

s1[1:3] = 30

# 对index为4,6的数据赋值50

s1[4, 6] = 50
三.DataFrame
DataFrame是二维的表格型数据结构。可以将DataFrame理解为Series的容器。
1.创建
# 通过dict创建DataFrame

data = {'name':["google", "amazon", "apple", "youtube", "oracle"], 'age':[33, 44, 11, 66, 44], "money" : [400, 200, 100, 800, 500]}

df1 = pd.DataFrame(data, columns = ["name", "age", "money"])

2.时间序列类型index
# 月

dates = pd.date_range('2017-10-08', periods = 10, freq = "M")

# 天

dates = pd.date_range('2017-10-08', periods = 10, freq = "D")

# 时

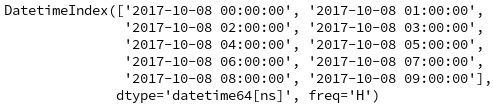
dates = pd.date_range('2017-10-08', periods = 10, freq = "H")
3.选取
# 获取前3行数据

df1.head(3)

# 获取后3行数据

df1.tail(3)

# 获取列

df1.name, df1['name'], df1[["name", "money"]]

# 获取行

df1[0:3], df1.loc[0:3]

# 同时获取行列

df1.loc[0:3, ["name", "money"]]
4.增加、删除、修改
# 增加列

df1["new"] = 6

# 删除列,不修改原DataFrame

df1 = df1.drop("new", axis = 1)

# 增加行,修改原DataFrame

df1.loc[df1.index.max() + 1] = {"name": "microsoft", "age": 70, "money": 300}

# 增加行,不修改原DataFrame

df1 = df1.append([{"name": "facebook", "age": 701, "money": 900}], ignore_index = True)

# 删除行,不修改原DataFrame

df1 = df1.drop([2])

# 修改数据

df1.loc[5,"age"] = 888

df1.loc[8:10, ["age", "money"]] = [11, 222]
5.WHERE
# 过滤数据,使用DataFrame.dtypes查看数据类型

df1[df1["age"] > 30]

df1[(df1["age"] > 30) & (df1["money"] < 600)], df1[(df1.age > 40) & (df1.money < 600)]

df1[df1["name"].isin(["amazon", "youtube"])]
6.DISTINCT
# 去重

df1.age.drop_duplicates()

df1[["age", "money"]].drop_duplicates()
7.JOIN
# 联接

df3 = pd.merge(df1, df2, how="left", left_on = "name", right_on = "name")

df3 = pd.merge(df1, df2, how="right", left_on = "name", right_on = "name")
8.GROUP BY
# 分组

df1.groupby("age")["money"].sum()

df1.groupby(["age", "name"])["money"].count()
9.ORDER BY
# 排序

df1.sort_values("age", ascending=True)

df1.sort_values(["age", "money"], ascending=[True, False])
10.UNION
# 合并

df2 = df1.copy(True)

df3 = pd.concat([df1,df2], ignore_index = True)

df3 = df1.append(df2, ignore_index = True)
11.导入和保存
Excel格式需要安装openpyxl、xlrd包
# 保存为csv格式

df1.to_csv("data.csv", encoding="utf-8")

# 从csv文件读取

df1 = pd.read_csv("data.csv")

# 保存为excel格式

df1.to_excel("data.xlsx", sheet_name = "Sheet1", encoding="utf-8")

# 从excel文件读取

df1 = pd.read_excel("data.xlsx", sheet_name = "Sheet1")
Pandas常用函数入门的更多相关文章
- pandas常用函数之shift
shift函数是对数据进行移动的操作,假如现在有一个DataFrame数据df,如下所示: index value1 A 0 B 1 C 2 D 3 那么如果执行以下代码: df.shift() 就会 ...
- pandas常用函数之diff
diff函数是用来将数据进行某种移动之后与原数据进行比较得出的差异数据,举个例子,现在有一个DataFrame类型的数据df,如下: index value1 A 0 B 1 C 2 D 3 如果执行 ...
- pandas 常用函数整理
pandas常用函数整理,作为个人笔记. 仅标记函数大概用途做索引用,具体使用方式请参照pandas官方技术文档. 约定 from pandas import Series, DataFrame im ...
- 【转载】pandas常用函数
原文链接:https://www.cnblogs.com/rexyan/p/7975707.html 一.import语句 import pandas as pd import numpy as np ...
- pandas常用函数
1. df.head(n): 显示数据前n行,不指定n,df.head则会显示所有的行 2. df.columns.values获取所有列索引的名称 3. df.column_name: 直接获取列c ...
- 整理 pandas 常用函数
1. df.head(n): 显示数据前n行,不指定n,df.head则会显示所有的行 2. df.columns.values获取所有列索引的名称 3. df.column_name: 直接获取列c ...
- 5.2 pandas 常用函数清单
文件读取 df = pd.read_csv(path='file.csv') 参数:header=None 用默认列名,0,1,2,3... names=['A', 'B', 'C'...] 自定义列 ...
- python,pandas常用函数
一.rename,更改df的列名和行索引 df=pd.DataFrame(np.arange(,).reshape(,)) print(df) print(type(df)) 结果为: <cla ...
- pandas 常用函数
随机推荐
- HDFS概述(3)————HDFS Federation
本指南概述了HDFS Federation功能以及如何配置和管理联合集群. 当前HDFS背景 HDFS主要有两层: 1.Namespace (1)包含目录,文件和块. (2)它支持所有命名空间相关的文 ...
- Python in/not in --- if not/if + for...[if]...构建List+ python的else子句
区分几个容易出错的地方: in 成员运算符 - 如果字符串中包含给定的字符返回 True >>>"H" in a True not in 成员运算符 - 如果字符 ...
- (Java后端 Java web)面试时如何展示自己非技术方面的能力(其实就是综合能力)
这篇文章的适用范围其实不仅限于Java后端或Java Web,不过其中有些是拿这方面举例的,在其它方面,大家可以举一反三,应该也能得到些启示. 我们在面试时,会发现有些候选人技术不错,比如在Java ...
- Block使用的简单总结
一.Block简单的使用 1.block当作参数来传递 如下定义一个没有返回值无参数的block,并把它作为参数,让系统调用,注意:这里是系统在调用,不是我们调用 那么为什么需要把block当作参数去 ...
- MySql中 where IN 字符串
正常where IN 字符串的时候会有问题 但是我们经常会有一个字段中存了好几个甚至一堆的值 ,例如 字段IDs(字符串类型)里面存了1,2,3,4 此时 FIND_IN_SET 就能解决我们这个棘 ...
- jsp web JavaBean MVC 架构 EL表达式 EL函数 JSTL
一.JavaBean概念(非常重要) 1.JavaBean就是遵循一定书写规范的Java类型(开发中:封装数据) a.必须有默认的构造方法,类必须是public的 public class ...
- 虚拟机+桥接模式+Host-only模式 搭建完美的Windows下Linux开发环境
相信有很多鞋童和我一个样是一枚Linux码农(我现在还是嵌入式方向). 做Linux开发势必需要一个Linux环境, 大多数开发者会首先选择一个Linux发行版, 其中Ubuntu LTS版本应该是选 ...
- MVC调用部分视图PartialView
using System; using System.Collections.Generic; using System.Linq; using System.Web; namespace Demo2 ...
- Intel Core Microarchitecture Pipeline
Intel微处理器近20年从Pentium发展到Skylake,得益于制作工艺上的巨大发展,处理器的性能得到了非常大的增强,功能模块增多,不过其指令处理pipeline的主干部分算不上有特别大的变化, ...
- 【学习】js学习笔记:对象的遍历和封装特性
1.对象的属性访问: 对象.属性 对象[属性],但中括号中必须是字符串 2.属性的遍历: for in方法举例: var ren={}; ren.name="名字"; ren.ea ...