
Neighborhood Attention Transformer概述
0.前言
1.针对的问题
1.之前的视觉Transformer关于嵌入维数(不包括线性投影)是线性的,但相对于token的数量是二次的,而在视觉范围内,token的数量通常与图像分辨率呈线性相关。因此,在严格使用自注意力的模型(如ViT)中,较高的图像分辨率会导致复杂度和内存使用量的二次增长。
2.卷积受益于一些归纳偏置,如局部性,平移不变性和二维邻域结构,而点积自注意力操作是一维全局操作,虽然视觉转换器中的MLP层是局部的和平移等变的,但其余的归纳偏差必须通过大量数据或高级训练技术和增强来学习。
2.主要贡献
1.提出邻域注意(NA):一种简单而灵活的视觉注意机制,它将每个标记的接受域定位到其邻域。将该模块的复杂性和内存使用与自注意、窗口自注意和卷积进行了比较。
2.引入了邻域注意Transformer(NAT),这是一种新型的高效、准确、可扩展的分层Transformer。每一层之后都有一个下采样操作,将空间大小减少了一半。类似的设计也可以在最近许多基于注意力的模型中看到,比如Swin。与这些模型不同,NAT利用小核重叠卷积进行嵌入和下采样,而不是非重叠卷积。与Swin等现有技术相比,NAT还引入了一套更有效的架构配置。
3.证明了NAT在分类和下游视觉任务上的有效性,包括目标检测和语义分割。我们观察到,NAT不仅可以超越Swin,而且还可以超越新的卷积竞争者。NAT-Tiny仅使用4.3个GFLOPs和28M参数,在NmageNet上的准确率达到83.2%,在MS-COCO上的边界框mAP为51.4%,在ADE20k上的mIoU为48.4%
4.开放一个新的CUDA支持的PyTorch扩展,用于快速和高效地计算基于窗口的注意机制。除了支持2D邻域注意模块外,该扩展还将允许定制的padding值,strides和dilated neighborhoods,以及1D和3D数据。
3.方法
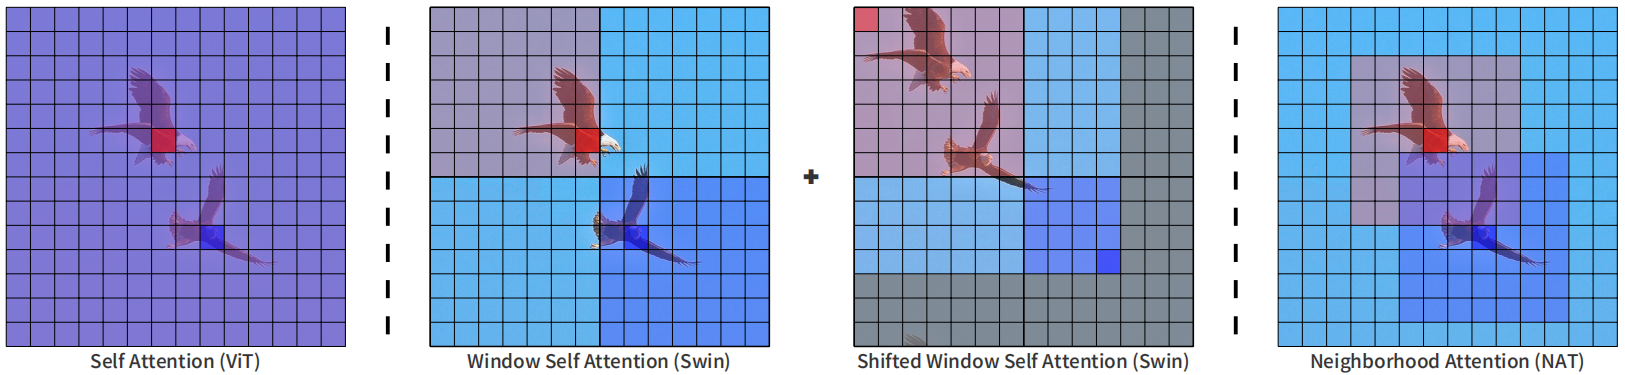
下面这个图展示了ViT,Swin和NAT的区别,标准VIT的attention计算是全局的,像第一图中红色的 token 和蓝色的 token 会全局的和所有的 token 进行计算。swin 是中间的两个图,第一步 token 的特征交互限制在局部窗口内。第二步窗口有shift,但 token 的特征交互仍然在局部的窗口内。最后一个图就是这个论文提出的 neighborhood attention transformer,NAT,所有 attention 的计算在7X7的邻域里进行。看起来和convolution一样,只是在一个 kernel 里面的范围内去做操作。但是和 convolution 不同的是,NAT里面是计算 attention,所以每一个 value 出来的权重是根据输入的这个值来决定的,而不是像卷积核里面那样训练好就固定的一个值。
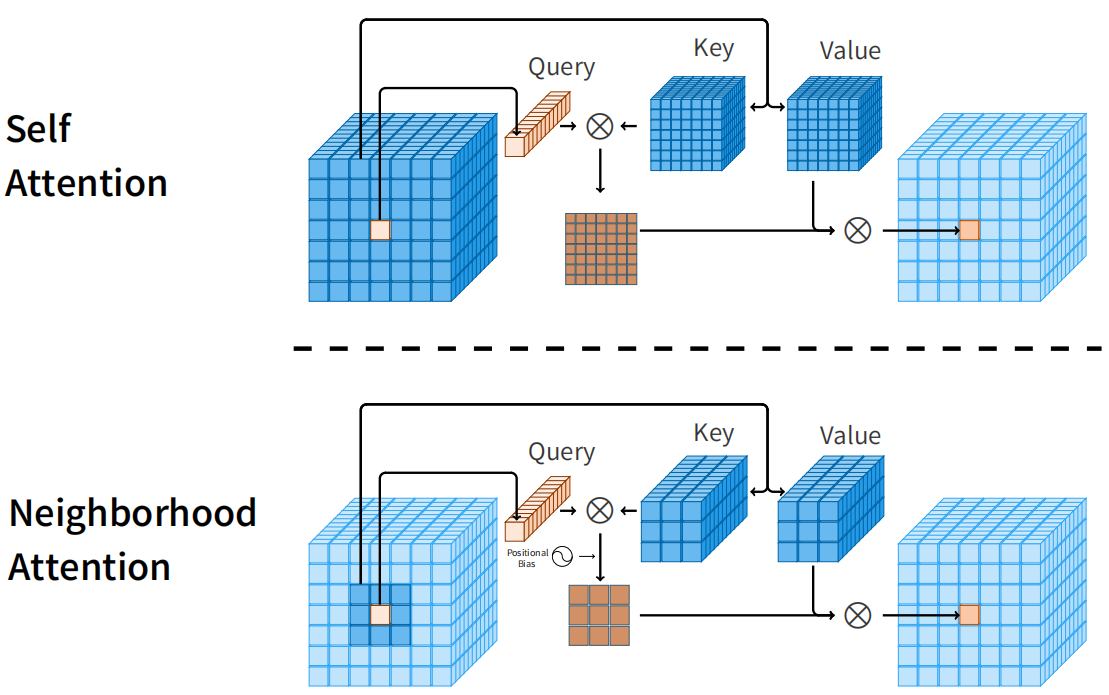
下面是自注意力与邻域注意力的比较,自注意力允许每个tokens关注所有其他tokens,而邻域注意力将每个tokens的接受域定位到其周围的邻域。对于CHW的输入矩阵,Query 是某个位置一个 1XC的向量, key 是一个 3x3xC 的矩阵,两个矩阵逐元素相乘(尺寸不同进行 broadcast ),结果是 3x3xC,最后在 C 这个维度求和,得到3X3的相似度矩阵。用这个矩阵给 value 分配权重 ,最后合并为一个 1x1xC 的向量,就是 attention 的计算结果。
将(i,j)像素位置的邻域定义为ρ(i,j),每个像素的NA计算公式为
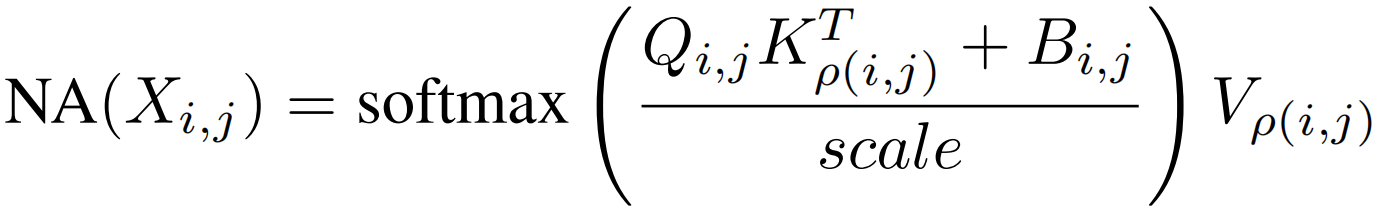
Q,K,V是X的线性投影,Bi,j表示相对位置偏差,当邻域超过输入大小时,就成了带额外位置偏差的自注意力。
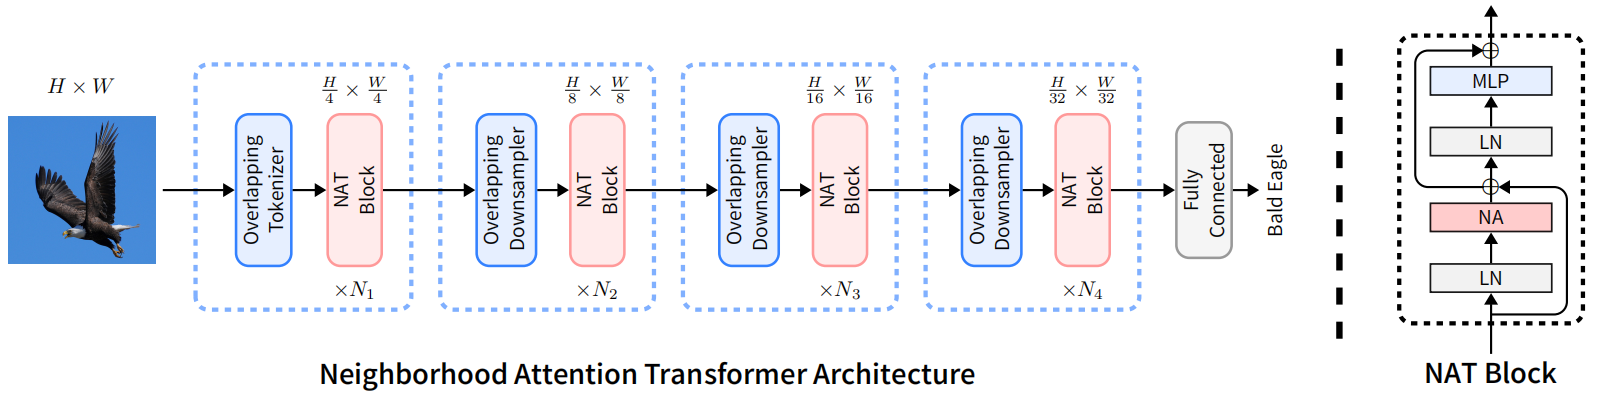
网络的整体架构和当前方法一样,都是4阶段。每个阶段分辨率降低一半。不过,降分辨率使用的是 步长为2的 3X3 卷积。第一步 overlapping tokenizer 使用的是2个3x3卷积,每个卷积的步长为2。
Neighborhood Attention Transformer概述的更多相关文章
- Attention & Transformer
Attention & Transformer seq2seq; attention; self-attention; transformer; 1 注意力机制在NLP上的发展 Seq2Seq ...
- 2. Attention Is All You Need(Transformer)算法原理解析
1. 语言模型 2. Attention Is All You Need(Transformer)算法原理解析 3. ELMo算法原理解析 4. OpenAI GPT算法原理解析 5. BERT算法原 ...
- 深度学习之Attention Model(注意力模型)
1.Attention Model 概述 深度学习里的Attention model其实模拟的是人脑的注意力模型,举个例子来说,当我们观赏一幅画时,虽然我们可以看到整幅画的全貌,但是在我们深入仔细地观 ...
- [深度概念]·Attention Model(注意力模型)学习笔记
此文源自一个博客,笔者用黑体做了注释与解读,方便自己和大家深入理解Attention model,写的不对地方欢迎批评指正.. 1.Attention Model 概述 深度学习里的Attention ...
- 深入浅出Transformer
Transformer Transformer是NLP的颠覆者,它创造性地用非序列模型来处理序列化的数据,而且还获得了大成功.更重要的是,NLP真的可以"深度"学习了,各种基于tr ...
- [NLP] REFORMER: THE EFFICIENT TRANSFORMER
1.现状 (1) 模型层数加深 (2) 模型参数量变大 (3) 难以训练 (4) 难以fine-tune 2. 单层参数量和占用内存分析 层 参数设置 参数量与占用内存 1 layer 0.5Bill ...
- 文本建模、文本分类相关开源项目推荐(Pytorch实现)
Awesome-Repositories-for-Text-Modeling repo paper miracleyoo/DPCNN-TextCNN-Pytorch-Inception Deep Py ...
- 关于NLP和深度学习,准备好好看看这个github,还有这篇介绍
这个github感觉很不错,把一些比较新的实现都尝试了: https://github.com/brightmart/text_classification fastText TextCNN Text ...
- BERT解析及文本分类应用
目录 前言 BERT模型概览 Seq2Seq Attention Transformer encoder部分 Decoder部分 BERT Embedding 预训练 文本分类试验 参考文献 前言 在 ...
- ACNet: 特别的想法,腾讯提出结合注意力卷积的二叉神经树进行细粒度分类 | CVPR 2020
论文提出了结合注意力卷积的二叉神经树进行弱监督的细粒度分类,在树结构的边上结合了注意力卷积操作,在每个节点使用路由函数来定义从根节点到叶子节点的计算路径,结合所有叶子节点的预测值进行最终的预测,论文的 ...
随机推荐
- python 实现AES加解密
AES 只是个基本算法,实现 AES 有几种模式,主要有 ECB.CBC.CFB 和 OFB CTR,直接上代码,此处为AES加密中的CBC模式,EBC模式与CBC模式相比,不需要iv. impor ...
- 2022年7月13日,第四组,周鹏,JS做计算器代码
代码不难,看了我前面笔记的应该能看懂. 没看?(= ̄ω ̄=)喵了个咪(๑‾᷅^‾᷅๑) 嫌弃你 还看啥,去看啊!要不直接复制代码吧!( ̄へ ̄)( ̄へ ̄)( ̄へ ̄) Document 0 / * - 7 ...
- [R语言] ggplot2入门笔记4—前50个ggplot2可视化效果
文章目录 通用教程简介(Introduction To ggplot2) 4 ggplot2入门笔记4-前50个ggplot2可视化效果 1 相关性(Correlation) 1.1 散点图(Scat ...
- Spark详解(06) - SparkSQL
Spark详解(06) - SparkSQL Spark SQL概述 什么是Spark SQL Spark SQL是Spark用于结构化数据(Structured Data)处理的Spark模块. ( ...
- Windows下使用vscode连接Linux服务器进行C++代码运行与调试
参考链接: vscode + SSH 配置 https://blog.csdn.net/irober/article/details/112724986 launch.json + tasks.jso ...
- Jekyll + GitHub Pages + Vercel纯免费搭建独立博客
大家一定不要随便立flag 10月份发了个朋友圈,有好兄弟留言说写个教程,我说好 然后一忙起来就忘了,昨天好兄弟追到知识星球,在一个新flag帖子下催更了 写个无废话极简 VSCode 从这下载:ht ...
- 绝对路径和相对路径-file类的构造方法
绝对路径和相对路径 路径:绝对路径:是一个完整的路径以盘符(c:,D:)开始的路径c:lla.txtC; llUserslitcastllIdeaProjects 1lshungyuan {\123. ...
- 论文翻译:2022_PercepNet+: A Phase and SNR Aware PercepNet for Real-Time Speech Enhancement
博客地址:凌逆战 (转载请注明出处) 论文地址:PercepNet+: 用于实时语音增强的相位和信噪比感知 PercepNet 引用格式: Ge X, Han J, Long Y, et al. Pe ...
- 力扣每日一题2023.1.16---1813. 句子相似性 III
一个句子是由一些单词与它们之间的单个空格组成,且句子的开头和结尾没有多余空格.比方说,"Hello World" ,"HELLO" ,"hello w ...
- 【LeetCode字符串#06】KMP巩固练习:重复子串
重复的子字符串 力扣题目链接(opens new window) 给定一个非空的字符串,判断它是否可以由它的一个子串重复多次构成.给定的字符串只含有小写英文字母,并且长度不超过10000. 示例 1: ...