
(数据科学学习手札136)Python中基于joblib实现极简并行计算加速
本文示例代码及文件已上传至我的
Github仓库https://github.com/CNFeffery/DataScienceStudyNotes
1 简介
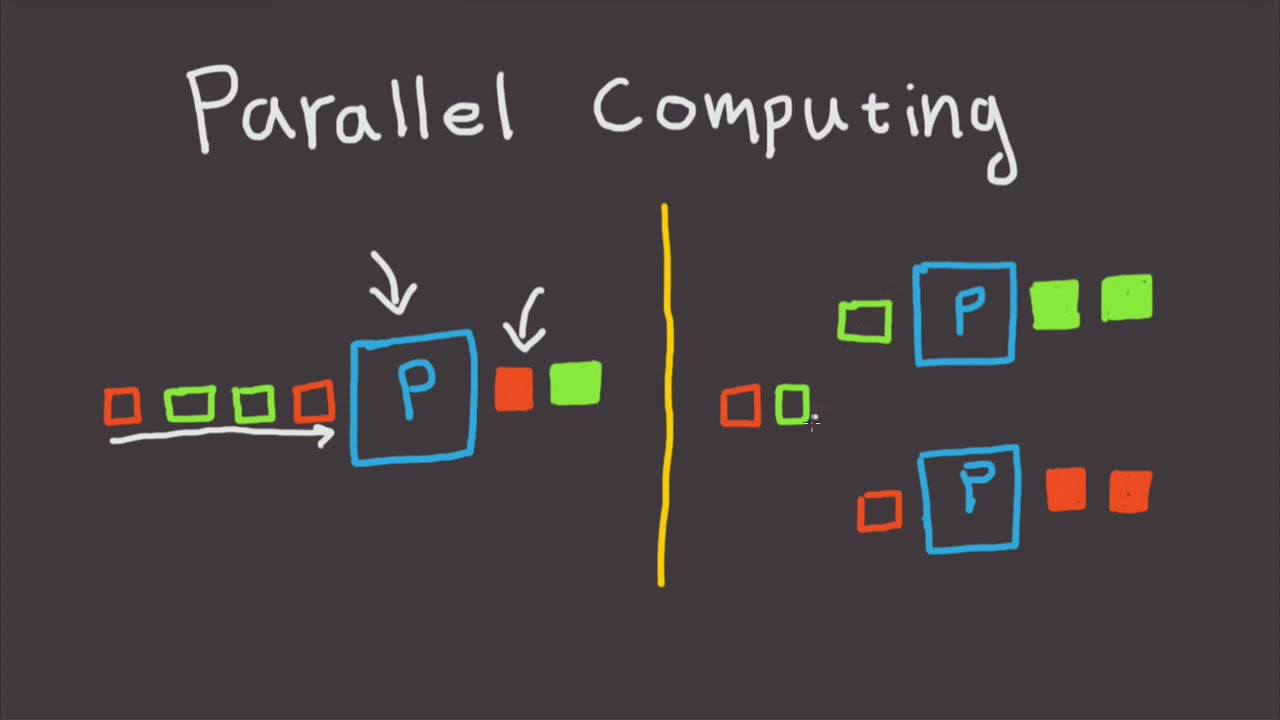
我们在日常使用Python进行各种数据计算处理任务时,若想要获得明显的计算加速效果,最简单明了的方式就是想办法将默认运行在单个进程上的任务,扩展到使用多进程或多线程的方式执行。
而对于我们这些从事数据分析工作的人员而言,以最简单的方式实现等价的加速运算的效果尤为重要,从而避免将时间过多花费在编写程序上。而今天的文章费老师我就来带大家学习如何利用joblib这个非常简单易用的库中的相关功能,来快速实现并行计算加速效果。
2 使用joblib进行并行计算
作为一个被广泛使用的第三方Python库(譬如scikit-learn项框架中就大量使用joblib进行众多机器学习算法的并行加速),我们可以使用pip install joblib对其进行安装,安装完成后,下面我们来学习一下joblib中有关并行运算的常用方法:
2.1 使用Parallel与delayed进行并行加速
joblib中实现并行计算只需要使用到其Parallel和delayed方法即可,使用起来非常简单方便,下面我们直接以一个小例子来演示:
joblib实现并行运算的思想是将一组通过循环产生的串行计算子任务,以多进程或多线程的方式进行调度,而我们针对自定义的运算任务需要做的仅仅是将它们封装为函数的形式即可,譬如:
import time

def task_demo1():

    time.sleep(1)

    return time.time()
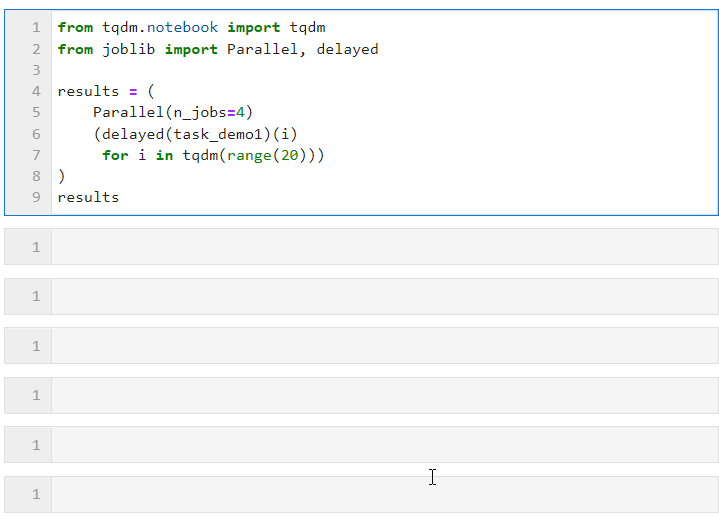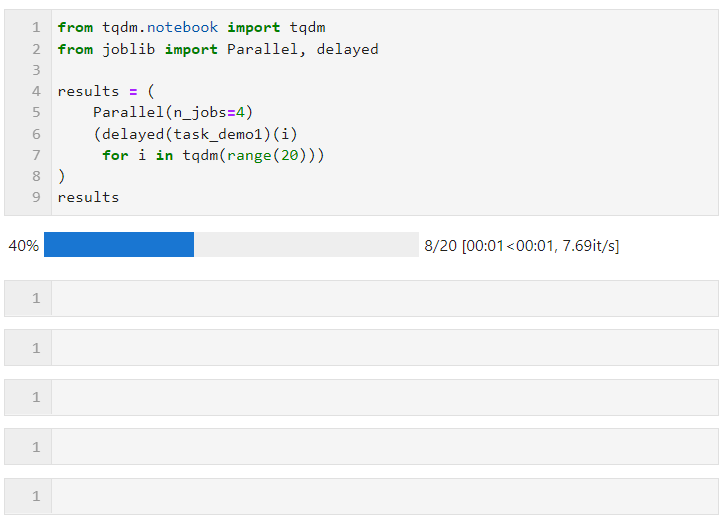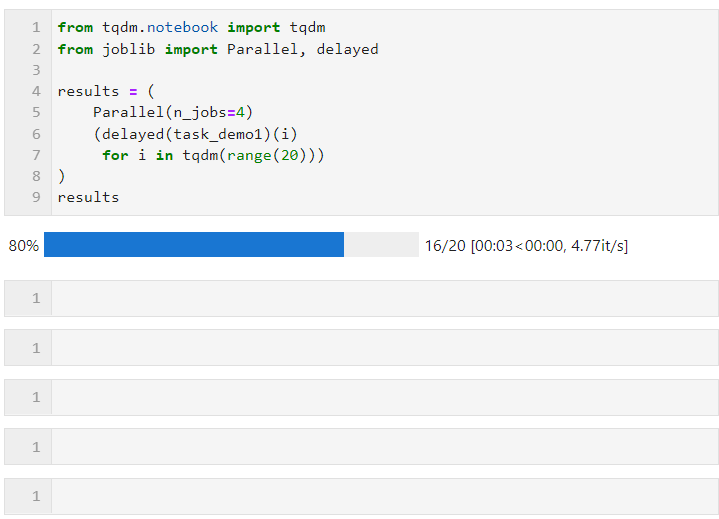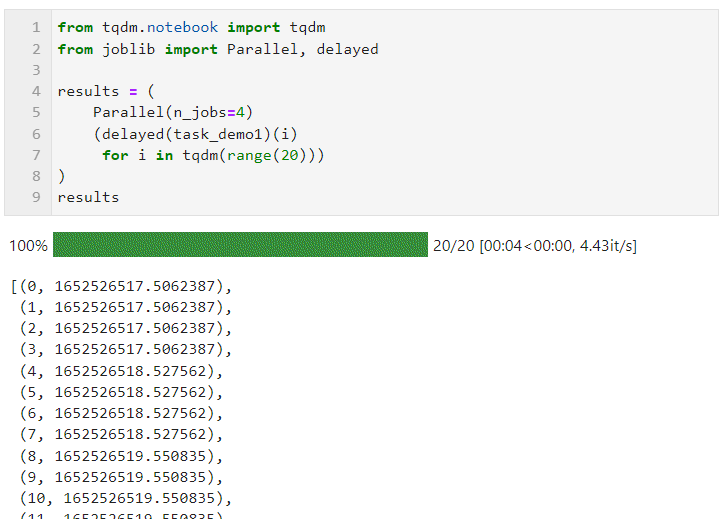
接着只需要像下面的形式一样,为Parallel()设置相关参数后,衔接循环创建子任务的列表推导过程,其中利用delayed()包裹自定义任务函数,再衔接()传递任务函数所需的参数即可,其中n_jobs参数用于设置并行任务同时执行的worker数量,因此在这个例子中可以看到进度条是按照4个一组递增的,可以看到最终时间开销也达到了并行加速效果:
其中可以根据计算任务以及机器CPU核心数具体情况为Parallel()调节参数,核心参数有:
- backend:用于设置并行方式,其中多进程方式有
'loky'(更稳定)和'multiprocessing'两种可选项,多线程有'threading'一种选项。默认为'loky' - n_jobs:用于设置并行任务同时执行的worker数量,当并行方式为多进程时,
n_jobs最多可设置为机器CPU逻辑核心数量,超出亦等价于开启全部核心,你也可以设置为-1来快捷开启全部逻辑核心,若你不希望全部CPU资源均被并行任务占用,则可以设置更小的负数来保留适当的空闲核心,譬如设置为-2则开启全部核心-1个核心,设置为-3则开启全部核心-2个核心
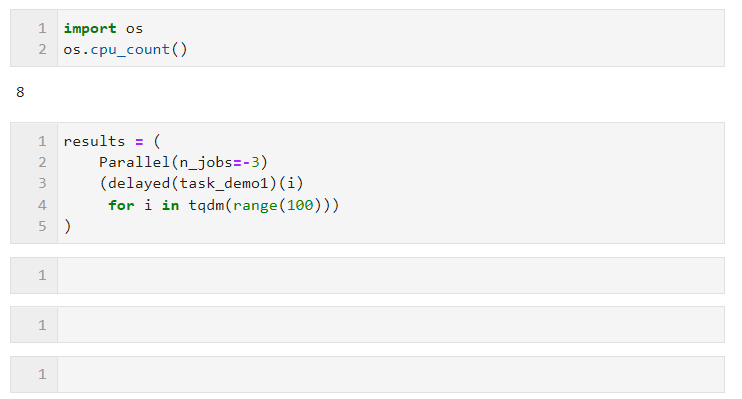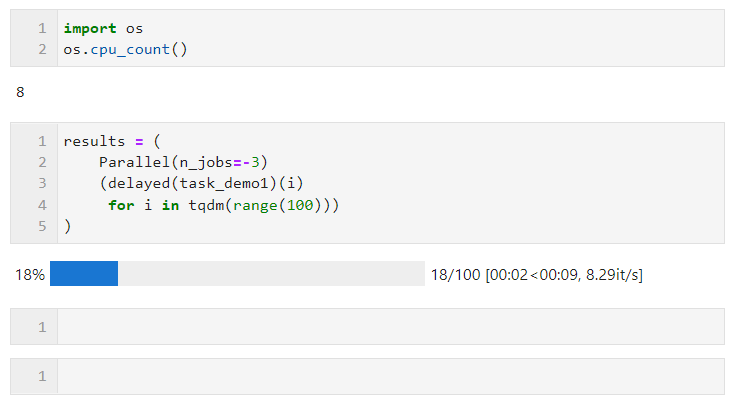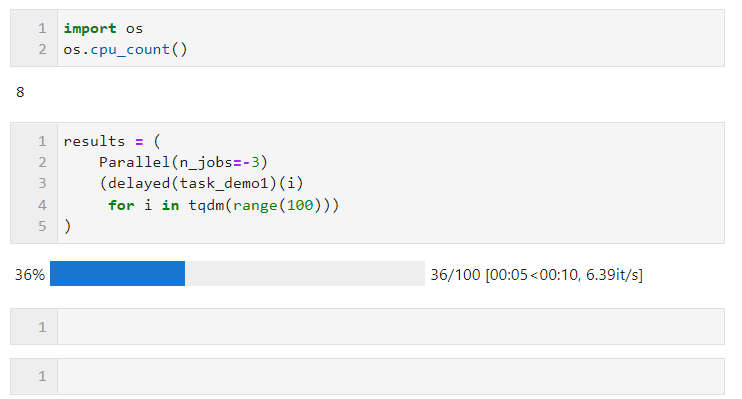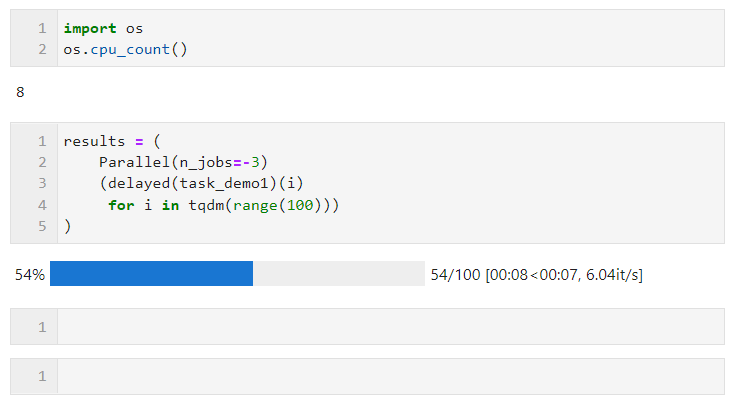
譬如下面的例子,在我这台逻辑核心数为8的机器上,保留两个核心进行并行计算:
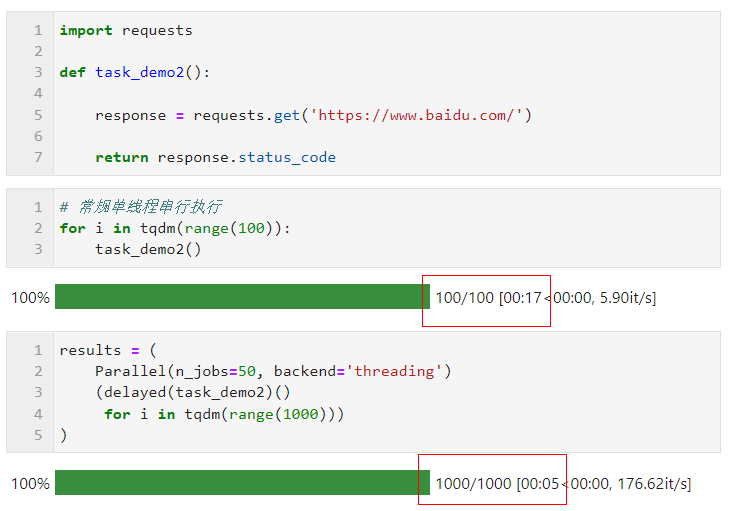
关于并行方式的选择上,由于Python中多线程时全局解释器锁的限制,如果你的任务是计算密集型,则推荐使用默认的多进程方式加速,如果你的任务是IO密集型譬如文件读写、网络请求等,则多线程是更好的方式且可以将n_jobs设置的很大,举个简单的例子,可以看到,通过多线程并行,我们在5秒的时间里完成了1000次请求,远快于单线程17秒请求100次的成绩:
你可以根据自己实际任务的不同,好好利用joblib来加速你的日常工作。
以上就是本文的全部内容,欢迎在评论区与我进行讨论~
(数据科学学习手札136)Python中基于joblib实现极简并行计算加速的更多相关文章
- (数据科学学习手札32)Python中re模块的详细介绍
一.简介 关于正则表达式,我在前一篇(数据科学学习手札31)中已经做了详细介绍,本篇将对Python中自带模块re的常用功能进行总结: re作为Python中专为正则表达式相关功能做出支持的模块,提供 ...
- (数据科学学习手札42)folium进阶内容介绍
一.简介 在上一篇(数据科学学习手札41)中我们了解了folium的基础内容,实际上folium在地理信息可视化上的真正过人之处在于其绘制图像的高度可定制化上,本文就将基于folium官方文档中的一些 ...
- (数据科学学习手札50)基于Python的网络数据采集-selenium篇(上)
一.简介 接着几个月之前的(数据科学学习手札31)基于Python的网络数据采集(初级篇),在那篇文章中,我们介绍了关于网络爬虫的基础知识(基本的请求库,基本的解析库,CSS,正则表达式等),在那篇文 ...
- (数据科学学习手札47)基于Python的网络数据采集实战(2)
一.简介 马上大四了,最近在暑期实习,在数据挖掘的主业之外,也帮助同事做了很多网络数据采集的内容,接下来的数篇文章就将一一罗列出来,来续写几个月前开的这个网络数据采集实战的坑. 二.马蜂窝评论数据采集 ...
- (数据科学学习手札69)详解pandas中的map、apply、applymap、groupby、agg
*从本篇开始所有文章的数据和代码都已上传至我的github仓库:https://github.com/CNFeffery/DataScienceStudyNotes 一.简介 pandas提供了很多方 ...
- (数据科学学习手札80)用Python编写小工具下载OSM路网数据
本文对应脚本已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 我们平时在数据可视化或空间数据分析的过程中经常会 ...
- (数据科学学习手札49)Scala中的模式匹配
一.简介 Scala中的模式匹配类似Java中的switch语句,且更加稳健,本文就将针对Scala中模式匹配的一些基本实例进行介绍: 二.Scala中的模式匹配 2.1 基本格式 Scala中模式匹 ...
- (数据科学学习手札44)在Keras中训练多层感知机
一.简介 Keras是有着自主的一套前端控制语法,后端基于tensorflow和theano的深度学习框架,因为其搭建神经网络简单快捷明了的语法风格,可以帮助使用者更快捷的搭建自己的神经网络,堪称深度 ...
- (数据科学学习手札75)基于geopandas的空间数据分析——坐标参考系篇
本文对应代码已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 在上一篇文章中我们对geopandas中的数据结 ...
随机推荐
- snippet,让你编码效率翻倍
为什么谈到Snippet 今天下午在用vscode做小程序的时候,发现很不方便,因为商店里提供的代码片段极为有限,而且平时几乎每天都需要用到代码片段,所以就在思考他们是怎么做到给别人提供代码的,我可以 ...
- c++实现中介者模式--虚拟聊天室
内容: 在"虚拟聊天室"实例中增加一个新的具体聊天室类和一个新的具体会员类,要求如下: 1. 新的具体聊天室中发送的图片大小不得超过20M. 2. 新的具体聊天室中发送的文字长度不 ...
- 大数据学习之路之ambari的安装
之前按照正常方式安装的hbase不能插入数据 所以今天来尝试下ambari能不能行 已经打了快照 如果不能还能恢复之前的样子
- 搭建 LNMP 环境
搭建 LNMP 环境 搭建 Nginx 静态服务器 安装 Nginx 使用 yum 安装 Nginx: yum install nginx -y 修改 /etc/nginx/conf.d/defaul ...
- Taro下拉刷新,上拉加载更多
1.引入插件 import Taro, { Component } from '@tarojs/taro' import { View, Text, ScrollView } from '@taroj ...
- css3,css的基础全局运用
浮动 1.浮动起来的盒子不占用位置,浮动了一个盒子下面的标准流的盒子会顶上来 可用清除浮动的方法来解决标准流会顶替位置的问题 清除浮动给父盒子加overflow: hidden; 鼠标经过事件 : ...
- Python接口自动化——文件上传/下载接口
〇.前言 文件上传/下载接口与普通接口类似,但是有细微的区别. 如果需要发送文件到服务器,例如:上传文档.图片.视频等,就需要发送二进制数据,上传文件一般使用的都是 Content-Type: mul ...
- win内核漏洞提权
WIN系统溢出漏洞提权 漏洞筛选 在整个提权项目中,前提是拿到webshell. 关于系统的溢出漏洞,我推荐两个项目: https://github.com/chroblert/WindowsVuln ...
- npm 和 Yarn 镜像站配置
Node.js 作为近年来非常受欢迎的 Web 开发运行环境,由于开发者众多,贡献开源代码的人也很多,所有这些凝结成了 npm 这个世界上最大的软件包仓库,但是受限于 npm 软件包的服务器在国外,国 ...
- 【jenkins】04.SSH认证方式拉取Git代码
首先需要会git ssh 我们一般用http的形式拉取代码. ssh的好处就是不用每次输入密码,而且貌似会快丢丢,不知道是不是错觉. 大概需要三个步骤: 一.本地生成密钥对: 二.设置github上的 ...