
Apache Hudi 流转批 场景实践
背景
在某些业务场景下,我们需要一个标志来衡量hudi数据写入的进度,比如:Flink 实时向 Hudi 表写入数据,然后使用这个 Hudi 表来支持批量计算并通过一个 flag 来评估它的分区数据是否完整从而进一步写入分区数据进行分区级别的ETL,这也就是我们通常说的流转批。
EventTime计算原理

图中Flink Sink包含了两个算子。第一个writer 算子,它负责把数据写入文件,writer在checkpoint触发时,会把自己写入的最大的一个时间传到commit算子中,然后commit算子从多个上游传过来的时间中选取一个最小值作为这一批提交数据的时间,并写入HUDI表的元数据中。
案例使用
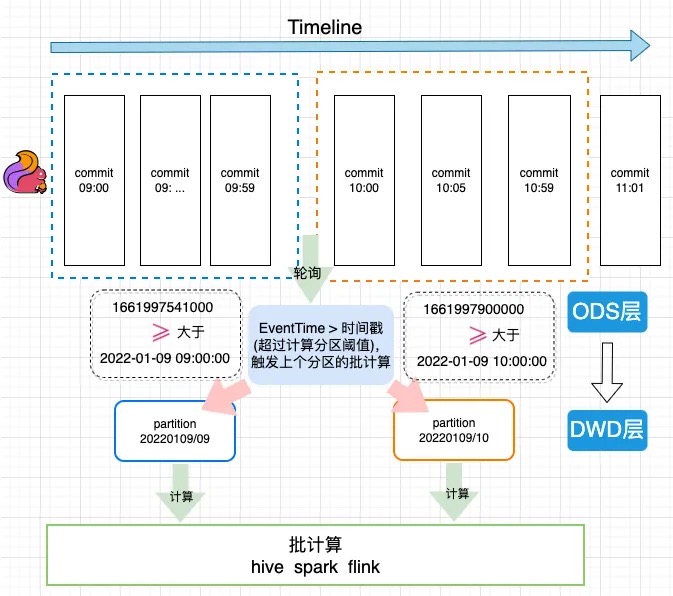
我们的方案是将这个进度值(EventTime)存储为 hudi 提交(版本)元数据的属性里,然后通过访问这个元数据属性获取这个进度值。在下游的批处理任务之前加一个监控任务去监控最新快照元数据。如果它的时间已经超过了当前的分区时间,就认为这个表的数据已经完备了,这个监控任务就会成功触发下游的批处理任务进行计算,这样可以防止在异常场景下数据管道或者批处理任务空跑的情况。
下图是一个flink 1分钟级别入库到HUDI ODS表, 然后通过流转批计算写入HUDI DWD表的一个执行过程。
US调度系统轮询逻辑
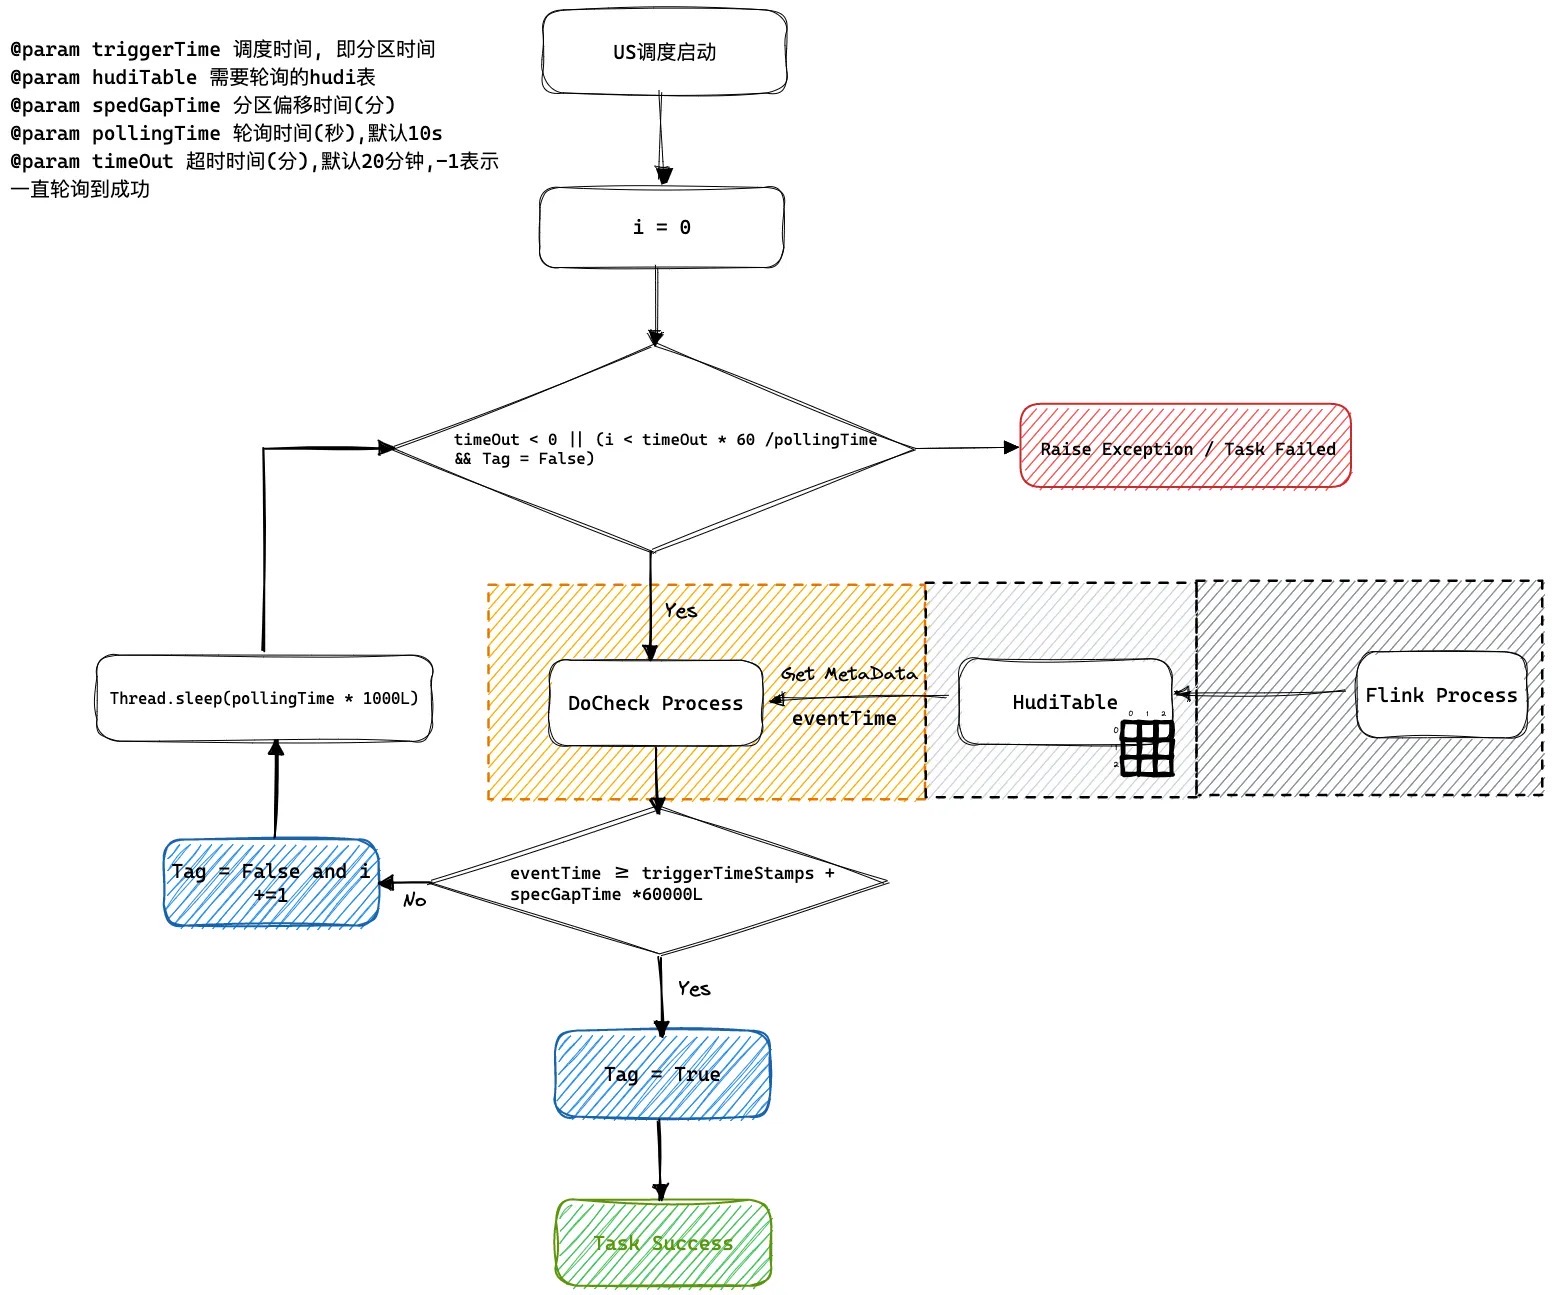
如何解决乱序到来问题, 我们可以通过设置spedGapTime来设置允许延迟到来的范围默认是0 不会延迟到来。
Maven pom 依赖
针对此功能特性的Hudi依赖版本如下
<dependencies>

  <dependency>

    <groupId>org.apache.hudi</groupId>

    <artifactId>hudi-flink1.13-bundle</artifactId>

    <version>0.12.1</version>

  </dependency>

</dependencies>

<dependencies>

  <dependency>

    <groupId>org.apache.hudi</groupId>

    <artifactId>hudi-flink1.15-bundle</artifactId>

    <version>0.12.1</version>

  </dependency>

</dependencies>
如何设置EventTime
能够解析的字段类型及格式如下:
| 类型 | 示例 |
|---|---|
| TIMESTAMP(3) | 2012-12-12T12:12:12 |
| TIMESTAMP(3) | 2012-12-12 12:12:12 |
| DATE | 2012-12-12 |
| BIGINT | 100L |
| INT | 100 |
Flink API
用户只需要设置flink conf指定时间字段作为时间推进字段
Map<String, String> options = new HashMap<>();

// 这里省略其他表字段

options.put(FlinkOptions.EVENT_TIME_FIELD.key(), "ts");

HoodiePipeline.Builder builder = HoodiePipeline.builder(targetTable)

     .column("id int not null")

     .column("ts string")

     .column("dt string")

     .pk("id")

     .partition("dt")

     .options(options);
Flink SQL
通过设置hoodie.payload.event.time.field指定需要计算的eventtime的字段
create table hudi_cow_01(\n" +

"  uuid varchar(20),\n" +

"  name varchar(10),\n" +

"  age int,\n" +

"  ts timestamp(3),\n" +

"  PRIMARY KEY(uuid) NOT ENFORCED\n" +

")\n" +

" with (\n" +

 // 这里省略其他参数

"  'hoodie.payload.event.time.field' = 'ts'\n"

")
如何读取EventTime
Spark SQL
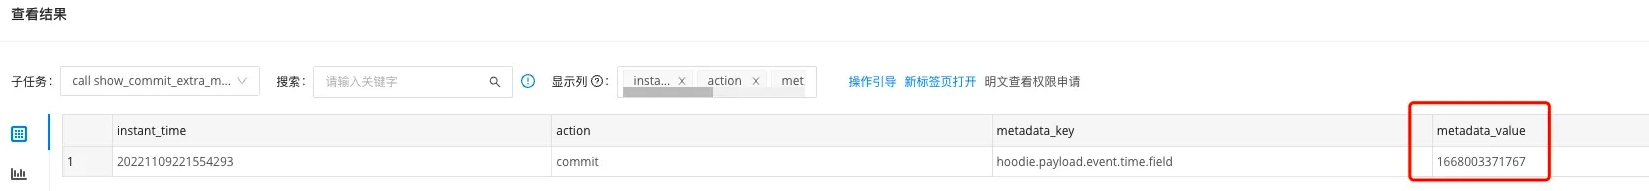
call show_commit_extra_metadata(table => 'hudi_tauth_test.hudi_cow_01', metadata_key => 'hoodie.payload.event.time.field');
Java API
代码获取片段如下
Option<HoodieCommitMetadata> commitMetadataOption = MetadataConversionUtils.getHoodieCommitMetadata(metaClient, currentInstant);

if (!commitMetadataOption.isPresent()) {

    throw new HoodieException(String.format("Commit %s not found commitMetadata in Commits %s.", currentInstant, timeline));

}

// 获取到当前版本的时间进度

String eventTime = commitMetadataOption.get().getExtraMetadata().get(FlinkOptions.EVENT_TIME_FIELD.key());

System.out.println("current eventTime: " + eventTime);
输出结果如下
current eventTime: 1667971364742
Apache Hudi 流转批 场景实践的更多相关文章
- KLOOK客路旅行基于Apache Hudi的数据湖实践
1. 业务背景介绍 客路旅行(KLOOK)是一家专注于境外目的地旅游资源整合的在线旅行平台,提供景点门票.一日游.特色体验.当地交通与美食预订服务.覆盖全球100个国家及地区,支持12种语言和41种货 ...
- Apache Hudi典型应用场景知多少?
1.近实时摄取 将数据从外部源如事件日志.数据库提取到Hadoop数据湖 中是一个很常见的问题.在大多数Hadoop部署中,一般使用混合提取工具并以零散的方式解决该问题,尽管这些数据对组织是非常有价值 ...
- Uber基于Apache Hudi构建PB级数据湖实践
1. 引言 从确保准确预计到达时间到预测最佳交通路线,在Uber平台上提供安全.无缝的运输和交付体验需要可靠.高性能的大规模数据存储和分析.2016年,Uber开发了增量处理框架Apache Hudi ...
- 基于Apache Hudi + Flink的亿级数据入湖实践
本次分享分为5个部分介绍Apache Hudi的应用与实践 实时数据落地需求演进 基于Spark+Hudi的实时数据落地应用实践 基于Flink自定义实时数据落地实践 基于Flink+Hudi的应用实 ...
- 触宝科技基于Apache Hudi的流批一体架构实践
1. 前言 当前公司的大数据实时链路如下图,数据源是MySQL数据库,然后通过Binlog Query的方式消费或者直接客户端采集到Kafka,最终通过基于Spark/Flink实现的批流一体计算引擎 ...
- OnZoom 基于Apache Hudi的流批一体架构实践
1. 背景 OnZoom是Zoom新产品,是基于Zoom Meeting的一个独一无二的在线活动平台和市场.作为Zoom统一通信平台的延伸,OnZoom是一个综合性解决方案,为付费的Zoom用户提供创 ...
- 基于Apache Hudi构建数据湖的典型应用场景介绍
1. 传统数据湖存在的问题与挑战 传统数据湖解决方案中,常用Hive来构建T+1级别的数据仓库,通过HDFS存储实现海量数据的存储与水平扩容,通过Hive实现元数据的管理以及数据操作的SQL化.虽然能 ...
- 字节跳动基于Apache Hudi构建EB级数据湖实践
来自字节跳动的管梓越同学一篇关于Apache Hudi在字节跳动推荐系统中EB级数据量实践的分享. 接下来将分为场景需求.设计选型.功能支持.性能调优.未来展望五部分介绍Hudi在字节跳动推荐系统中的 ...
- 基于 Apache Hudi 极致查询优化的探索实践
摘要:本文主要介绍 Presto 如何更好的利用 Hudi 的数据布局.索引信息来加速点查性能. 本文分享自华为云社区<华为云基于 Apache Hudi 极致查询优化的探索实践!>,作者 ...
- Robinhood基于Apache Hudi的下一代数据湖实践
1. 摘要 Robinhood 的使命是使所有人的金融民主化. Robinhood 内部不同级别的持续数据分析和数据驱动决策是实现这一使命的基础. 我们有各种数据源--OLTP 数据库.事件流和各种第 ...
随机推荐
- [排序算法] 树形选择排序 (C++)
树形选择排序解释 树形选择排序 又称为锦标赛排序,其实理解起来很简单. 数组的 n 个元素就好像在进行锦标赛一样,每一轮小比赛每两个一组决出胜负(比较谁更小). 再将每一轮的胜者每两个一组进行小比赛, ...
- Day20.1:关于this、super的解析
this.super详解 当我们在外部程序调用一个类的方法,如果这个类的方法与其父类的方法重载,我们需要用this.super进行区分 this在Java中是一个复杂的关键字,this的使用形式体现了 ...
- POST请求发送的表单数据和json数据的区别及python代码实现
前言 这篇博客会介绍最常见post 请求form表单数据和json数据 数据类型之间的区别, urllib代码的实现(python), requests库实现, 以及如何使用postman软件发送这些 ...
- 持续发烧,聊聊Dart语言的静态编译,能挑战Go不?
前言 前两天写了几篇文章,谈了谈Dart做后端开发的优势,比如: <Dart开发服务端,我是不是发烧(骚)了?> <持续发烧,试试Dart语言的异步操作,效率提升500%> & ...
- MySQL事务(四大特征)-存储过程
目录 一:事务 1.四大特性(ACID) 2.事物存在的必要性(真实比喻) 3.如何使用事务 4.开启事务-回滚-确认 二:事务案例实战 1.模拟消费 2.创建 3.插入数据 4.开启事务 5.修改操 ...
- git相关问题解析,你想要的都有🔥
官网文档: https://git-scm.com/doc 本地克隆远程代码仓库 git clone 地址 本地同步全量历史数据,克隆所有文件的历史记录 git clone 地址 -depth 1 本 ...
- uniapp 微信小程序 引入 环信聊天
最近项目需要实现一个聊天的功能,群聊或者单聊,用到环信,根据官网实现一下相关的配置吧 第一:下载环信demo 地址:https://github.com/easemob/webim-uniapp-d ...
- ARL灯塔系统搭建
前言 ARL(Asset Reconnaissance Lighthouse)资产侦查灯塔,是一个良好的资产收集系统,旨在为渗透测试人员以及安全团队基于企业的网络安全能快速查找到指定企业资产中的脆弱点 ...
- 利用Redisson实现订单关闭
实体类 为了方便测试,直接在测试类中的写内部类: @Data @AllArgsConstructor @NoArgsConstructor public class OrderInfo { /** * ...
- Request.Form&Request.QueryString实现伪ajax的效果
1.问题描述 最近一直在搞公司老系统的需求开发,前端是asp,后端的vb.碰到了一个需求,是做一个"日志查询"功能,查询条件为:时间&操作人. 原本我的设计思路是异步查询, ...