
KLOOK客路旅行基于Apache Hudi的数据湖实践
1. 业务背景介绍
客路旅行(KLOOK)是一家专注于境外目的地旅游资源整合的在线旅行平台,提供景点门票、一日游、特色体验、当地交通与美食预订服务。覆盖全球100个国家及地区,支持12种语言和41种货币的支付系统,与超过10000家商户合作伙伴紧密合作,为全球旅行者提供10万多种旅行体验预订服务。
KLOOK数仓RDS数据同步是一个很典型的互联网电商公司数仓接入层的需求。对于公司数仓,约60%以上的数据直接来源与业务数据库,数据库有很大一部分为托管的AWS RDS-MYSQL 数据库,有超100+数据库/实例。RDS直接通过来的数据通过标准化清洗即作为数仓的ODS层,公司之前使用第三方商业工具进行同步,限制为每隔8小时的数据同步,无法满足公司业务对数据时效性的要求,数据团队在进行调研及一系列poc验证后,最后我们选择Debezium+Kafka+Flink+Hudi的ods层pipeline方案,数据秒级入湖,后续数仓可基于近实时的ODS层做更多的业务场景需求。
2. 架构改进
2.1 改造前架构
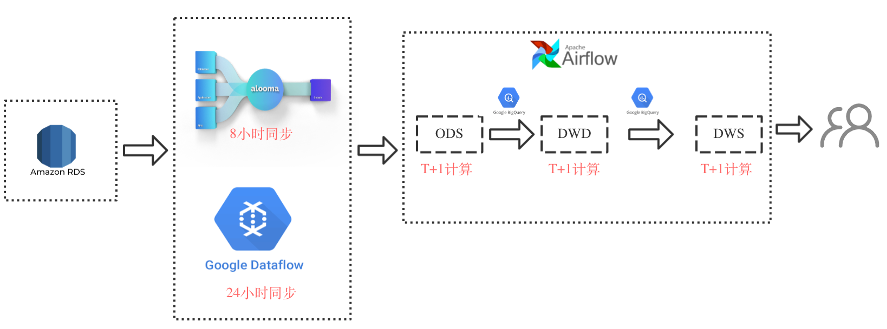
整体依赖于第三服务,通过Google alooma进行RDS全量增量数据同步,每隔8小时进行raw table的consolidation,后续使用data flow 每24小时进行刷入数仓ODS层
2.2 新架构
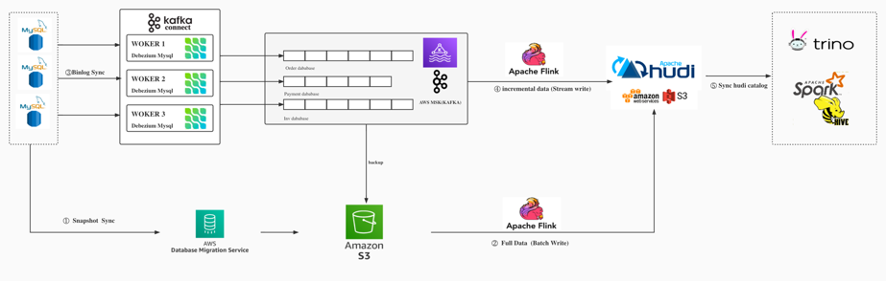
- 使用AWS DMS 数据迁移工具,将全量RDS Mysql 数据同步至S3存储中;
- 通过Flink SQL Batch 作业将S3数据批量写入Hudi 表;
- 建立Debeizum MySQL binlog 订阅任务,将binlog 数据实时同步至Kafka;
- 通过Flink SQL 启动两个流作业,一个将数据实时写入Hudi,另一个作业将数据追加写入到S3,S3 binlog文件保存30天,以备数据回溯使用;
- 通过hive-hudi meta data sync tools,同步hudi catalog数据至Hive,通过Hive/Trino提供OLAP数据查询。
2.3 新架构收益
- 数据使用及开发灵活度提升,地方放同步服务限制明显,改进后的架构易于扩展,并可以提供实时同步数据供其它业务使用;
- 数据延迟问题得到解决,基于Flink on Hudi 的实时数据写入,对于RDS数据摄入数仓可以缩短至分钟甚至秒级,对于一些库存、风控、订单类的数据可以更快的进行数据取数分析,整体从原来近8小时的consolidation缩减至5分钟;
- 成本更加可控,基于Flink on Hudi存算分离的架构,可以有效通过控制对数据同步计算处理资源配额、同步刷新数据表落盘时间、数据存储冷热归档等进行成本控制,与第三方服务成本整体对比预计可以缩减40%。
3. 实践要点
3.1 Debezium 增量Binlog同步配置
Kafka connect 关键配置信息
bootstrap.servers=localhost:9092

# unique name for the cluster, used in forming the Connect cluster group. Note that this must not conflict with consumer group IDs

group.id=connect-cluster

# The converters specify the format of data in Kafka and how to translate it into Connect data. Every Connect user will

# need to configure these based on the format they want their data in when loaded from or stored into Kafka

key.converter=org.apache.kafka.connect.json.JsonConverter

value.converter=org.apache.kafka.connect.json.JsonConverter

# Converter-specific settings can be passed in by prefixing the Converter's setting with the converter we want to apply

key.converter.schemas.enable=true

value.converter.schemas.enable=true

# Topic to use for storing offsets. This topic should have many partitions and be replicated and compacted.

# Kafka Connect will attempt to create the topic automatically when needed, but you can always manually create

# the topic before starting Kafka Connect if a specific topic configuration is needed.

# Most users will want to use the built-in default replication factor of 3 or in some cases even specify a larger value.

# Since this means there must be at least as many brokers as the maximum replication factor used, we'd like to be able

# to run this example on a single-broker cluster and so here we instead set the replication factor to 1.

offset.storage.topic=connect-offsets

# Topic to use for storing connector and task configurations; note that this should be a single partition, highly replicated,

# and compacted topic. Kafka Connect will attempt to create the topic automatically when needed, but you can always manually create

# the topic before starting Kafka Connect if a specific topic configuration is needed.

# Most users will want to use the built-in default replication factor of 3 or in some cases even specify a larger value.

# Since this means there must be at least as many brokers as the maximum replication factor used, we'd like to be able

# to run this example on a single-broker cluster and so here we instead set the replication factor to 1.

config.storage.topic=connect-configs

# Topic to use for storing statuses. This topic can have multiple partitions and should be replicated and compacted.

# Kafka Connect will attempt to create the topic automatically when needed, but you can always manually create

# the topic before starting Kafka Connect if a specific topic configuration is needed.

# Most users will want to use the built-in default replication factor of 3 or in some cases even specify a larger value.

# Since this means there must be at least as many brokers as the maximum replication factor used, we'd like to be able

# to run this example on a single-broker cluster and so here we instead set the replication factor to 1.

status.storage.topic=connect-status
查询 MySQL 最近binlog file 信息
SQL

MySQL [(none)]> show binary logs;

| mysql-bin-changelog.094531 |    176317 |

| mysql-bin-changelog.094532 |    191443 |

| mysql-bin-changelog.094533 |   1102466 |

| mysql-bin-changelog.094534 |    273347 |

| mysql-bin-changelog.094535 |    141555 |

| mysql-bin-changelog.094536 |      4808 |

| mysql-bin-changelog.094537 |    146217 |

| mysql-bin-changelog.094538 |     29607 |

| mysql-bin-changelog.094539 |    141260 |

+----------------------------+-----------+

MySQL [(none)]> show binlog events in 'mysql-bin-changelog.094539';

MySQL [(none)]> show binlog events in 'mysql-bin-changelog.094539' limit 10;

+----------------------------+-----+----------------+------------+-------------+---------------------------------------------------------------------------+

| Log_name                   | Pos | Event_type     | Server_id  | End_log_pos | Info                                                                      |

+----------------------------+-----+----------------+------------+-------------+---------------------------------------------------------------------------+

| mysql-bin-changelog.094539 |   4 | Format_desc    | 1399745413 |         123 | Server ver: 5.7.31-log, Binlog ver: 4                                     |

| mysql-bin-changelog.094539 | 123 | Previous_gtids | 1399745413 |         194 | 90710e1c-f699-11ea-85c0-0ec6a6bed381:1-108842347                          |
指定server name key 发送offset 记录到offset.storage.topic
$ ./bin/kafka-console-producer.sh -bootstrap-server localhost:9092 --topic  connect-offsets --property "parse.key=true" --property "key.separator=>"

$>["test_servername",{"server":"test_servername"}]>{"ts_sec":1647845014,"file":"mysql-bin-changelog.007051","pos":74121553,"row":1,"server_id":1404217221,"event":2}
编辑task api 请求,启动debezium task
{

    "name":"test_servername",

    "config":{

        "connector.class":"io.debezium.connector.mysql.MySqlConnector",

        "snapshot.locking.mode":"none",

        "database.user":"db_user",

        "transforms.Reroute.type":"io.debezium.transforms.ByLogicalTableRouter",

        "database.server.id":"1820615119",

        "database.history.kafka.bootstrap.servers":"localhost:9092",

        "database.history.kafka.topic":"history-topic",

        "inconsistent.schema.handling.mode":"skip",

        "transforms":"Reroute", // 配置binlog数据转发到一个topic,默认一个表一个topic

        "database.server.name":"test_servername",

        "transforms.Reroute.topic.regex":"test_servername(.*)",

        "database.port":"3306",

        "include.schema.changes":"true",

        "transforms.Reroute.topic.replacement":"binlog_data_topic",

        "table.exclude.list":"table_test",

        "database.hostname":"host",

        "database.password":"******",

        "name":"test_servername",

        "database.whitelist":"test_db",

        "database.include.list":"test_db",

        "snapshot.mode":"schema_only_recovery"  // 使用recovery模式从指定binlog文件的offset同步

    }

}
3.2 Hudi 全量接增量数据写入
在已经有全量数据在Hudi表的场景中,后续从kafka消费的binlog数据需要增量upsert到Hudi表。debezium的binlog格式携带每条数据更新的信息,需要将其解析为可直接插入的数据。
示例解析生成Flink SQL的Python代码
# 写入数据到ODS Raw表

insert_hudi_raw_query = '''

INSERT INTO

{0}_ods_raw.{1}

SELECT

{2}

FROM

{0}_debezium_kafka.kafka_rds_{1}_log

WHERE

REGEXP(GET_JSON_OBJECT(payload, '$.source.table'), '^{3}$')

AND GET_JSON_OBJECT(payload, '$.source.db') = '{4}'

AND IF(GET_JSON_OBJECT(payload, \'$.op\') = \'d\', GET_JSON_OBJECT(payload, \'$.before.{5}\'), GET_JSON_OBJECT(payload, \'$.after.{5}\')) IS NOT NULL

AND GET_JSON_OBJECT(payload, '$.op') IN ('d', 'c', 'u')

'''.format(

    database_name,

    table_name,

    hudi_schema,

    mysql_table_name,

    mysql_database_name,

    primary_key

)
如上对Debezium的三种binlog数据进行解析,我们将insert及update的数据只取after后的数据,对于delete,我们追加一个硬删除字段标记进行插入,Hudi则会自动去重。
在这里为了保证增量更新的hudi数据不重复,需要开启index bootstrap功能。
Hudi配置参数
| 名称 | Required | 默认值 | 说明 |
|---|---|---|---|
| index.bootstrap.enabled | true | false | 开启索引加载,会将已存表的最新数据一次性加载到 state 中 |
| index.partition.regex | false | * | 设置正则表达式进行分区筛选,默认为加载全部分区 |
- CREATE TABLE 创建和 Hoodie 表对应的语句,注意 table type 要正确
- 设置 index.bootstrap.enabled = true开启索引加载功能
- 索引加载为并发加载,根据数据量大小加载时间不同,可以在log中搜索finish loading the index under partition 和 Load records from file 日志来观察索引加载进度
- 重启任务将 index.bootstrap.enabled 关闭,参数配置到合适的大小,如果RowDataToHoodieFunction 和 BootstrapFunction 并发不同,可以重启避免 shuffle
3.3 Hudi同步Metastore自定义分区格式改写
Hudi 提供了HIVE Sync Tool https://hudi.apache.org/docs/syncing_metastore 用来将Hudi的meta data 同步至Hive 进行查询,同时 PrestoDB / Trino 可以直接通过配置Hive的catalog信息实现Hudi表的秒级查询。但目前HiveSyncTool 仅自带支持几种格式的Hudi partion ,源码位置如下位置:
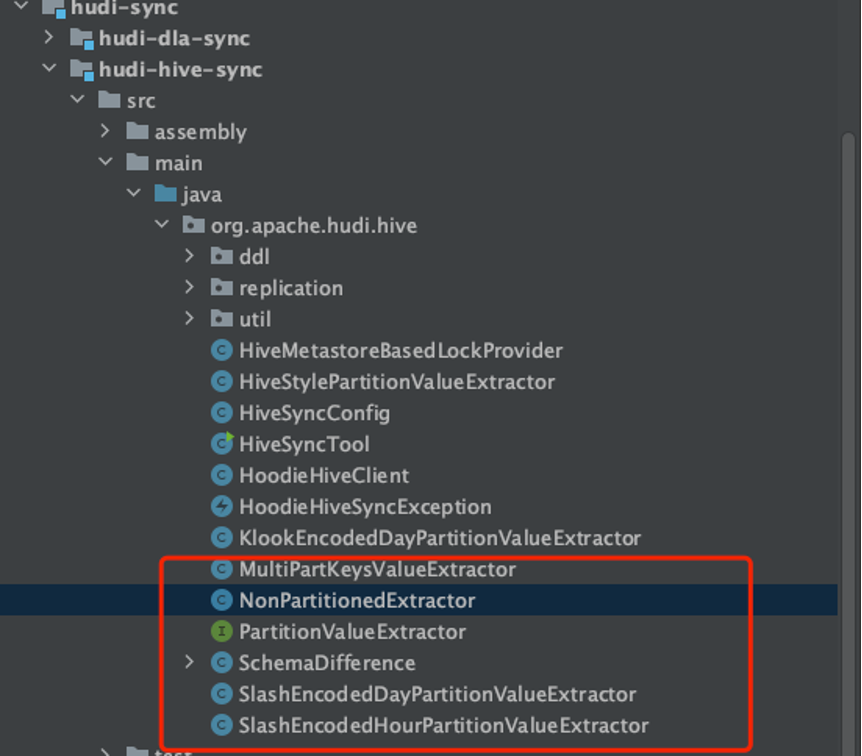
如果要同步的hudi表没有分区,或者符合hive 的’yyyy-MM-dd’ / ‘yyyy-MM-dd-HH’ 分区格式,可以直接使用参数--partition-value-extractor 指定到Non/SlashEncodedDayPartitionValueExtractor/SlashEncodedHourPartitionValueExtractor 进行同步,如下命令:
sh run_sync_tool.sh --jdbc-url jdbc:hive2:\/\xxxx:10000 --user hive --pass hive --partitioned-by partition --partition-value-extractor org.apache.hudi.hive.SlashEncodedHourPartitionValueExtractor --base-path s3://xxx/raw/order_business_db/ord_basics --auto-create-database --database order_business_db_ods_raw_hive_sync --table ord_basics
但存在分区不满足上述格式,如果使用non分区同步,则会出现查询不到数据的问题,这个时候需要自己实现一个Extractor,实现代码位于package org.apache.hudi.hive,继承 PartitionValueExtractor 定义 SlashEncodedHourPartitionValueExtractor 实现extractPartitionValuesInPath 方法,代码片段如下,实现格式 dd-MM-yy,代码片段截取如下:
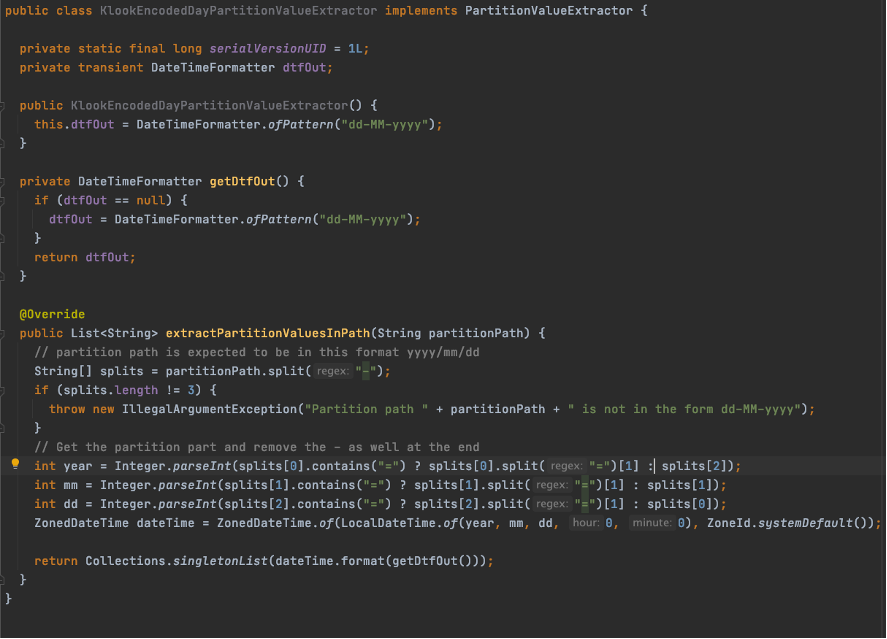
然后重新打包,执行如下命令,随后在PrestoDB/Hive/Trino 均可直接进行查询。
sh run_sync_tool.sh --jdbc-url jdbc:hive2:\/\/xxxx10000 --user hive --pass hive --partitioned-by partition --partition-value-extractor org.apache.hudi.hive.KlookEncodedDayPartitionValueExtractor --base-path s3://xxxx/raw/order_business_db/ord_basics --auto-create-database --database order_business_db_ods_raw_hive_sync --table ord_basics
AWS EMR 上需要注意的:
- 找不到log4j 修改
run_sync_tool.sh HADOOP_HIVE_JARS=${HIVE_JARS}:${HADOOP_HOME}/*:${HADOOP_HOME}/lib/*:/usr/lib/hadoop-hdfs/*:/usr/lib/hadoop-mapreduce/*:/usr/share/aws/emr/emrfs/lib/*:/usr/share/aws/emr/emrfs/auxlib/*:${GLUE_JARS} - 找不到libfb修改
java -cp $HUDI_HIVE_UBER_JAR:${HADOOP_HIVE_JARS}:${HIVE_CONF_DIR}:${HADOOP_CONF_DIR}:${EMRFS_CONF_DIR}:/usr/lib/hudi/cli/lib/libfb303-0.9.3.jar org.apache.hudi.hive.HiveSyncTool "$@"
4. 经验总结
- 当前整体RDS数据同步解决了对数据时效性及灵活扩展性的业务需求,但如上述,数据链路较长带来大量手动操作。因此,我们做了一些流程自动化的工作,使用Airflow 将DMS全量同步S3,S3同步Hudi的Flink 批作业进行自动调度触发,使得我们填写简单数据库同步参数就可完成一个链路的数据入湖。对于增量Debezium 数据同步,我们也通过编写一些脚本,在启动Flink Stream SQL作业时,同步拉取最新MySQL schema,生成解析binlog数据的SQL ,进行自动任务提交。
- 在稳定性方面,当前主要考虑增量流作业的稳定性,我们从kafka备份了binlog原始数据,这些数据会在S3保存30天,如果出现流作业写入Hudi异常,我们可以很快跑一个批任务将数据回溯。
- 该方案运行近一年时间,期间Hudi版本快速迭代fix很多问题,例如前期Hudi在增量接全量时开启index后,必须一次将index缓存在state,index阶段为了提升速度,我们设置了较大的并行度资源,需要人工值守等待一个checkpoint周期然后调低。初期,咨询社区后,提出了全量也使用流读等方式,避免增加改表参数的问题,后续社区也做了一些优化,异步执行index并发加载索引等,无需等待checkpoint完成,index不会阻塞数据写入checkpoint等。
- 在OLAP选择上,我们在采用Trino进行数据查询Hudi时,由于需要同步工具对Hudi所有分区进行索引同步,我们也遇到了需要兼容分区策略等问题。我们参考了Hudi同步metastore工具编写了转换类兼容了自定义分区。
5. 未来展望
在使用Hudi开源组件过程中,我们体会到必须紧密与社区保持沟通,及时反馈问题,也可以与来自其它公司不同业务场景的工程师进行交流,分享我们遇到的问题及解决思路。
后续的改进,我们会从脱离第三方服务DMS 试图直接使用Flink 进行全量数据同步,减少链路中组件的维护数量,同样的,我们将积极跟随Hudi及Flink的发展,优化整体链路的效率。
KLOOK客路旅行基于Apache Hudi的数据湖实践的更多相关文章
- 基于Apache Hudi构建数据湖的典型应用场景介绍
1. 传统数据湖存在的问题与挑战 传统数据湖解决方案中,常用Hive来构建T+1级别的数据仓库,通过HDFS存储实现海量数据的存储与水平扩容,通过Hive实现元数据的管理以及数据操作的SQL化.虽然能 ...
- 基于Apache Hudi 的CDC数据入湖
作者:李少锋 文章目录: 一.CDC背景介绍 二.CDC数据入湖 三.Hudi核心设计 四.Hudi未来规划 1. CDC背景介绍 首先我们介绍什么是CDC?CDC的全称是Change data Ca ...
- 基于Apache Hudi在Google云构建数据湖平台
自从计算机出现以来,我们一直在尝试寻找计算机存储一些信息的方法,存储在计算机上的信息(也称为数据)有多种形式,数据变得如此重要,以至于信息现在已成为触手可及的商品.多年来数据以多种方式存储在计算机中, ...
- 基于 Apache Hudi 和DBT 构建开放的Lakehouse
本博客的重点展示如何利用增量数据处理和执行字段级更新来构建一个开放式 Lakehouse. 我们很高兴地宣布,用户现在可以使用 Apache Hudi + dbt 来构建开放Lakehouse. 在深 ...
- Uber基于Apache Hudi构建PB级数据湖实践
1. 引言 从确保准确预计到达时间到预测最佳交通路线,在Uber平台上提供安全.无缝的运输和交付体验需要可靠.高性能的大规模数据存储和分析.2016年,Uber开发了增量处理框架Apache Hudi ...
- 基于Apache Hudi + Flink的亿级数据入湖实践
本次分享分为5个部分介绍Apache Hudi的应用与实践 实时数据落地需求演进 基于Spark+Hudi的实时数据落地应用实践 基于Flink自定义实时数据落地实践 基于Flink+Hudi的应用实 ...
- 基于 Apache Hudi + Presto + AWS S3 构建开放Lakehouse
认识Lakehouse 数据仓库被认为是对结构化数据执行分析的标准,但它不能处理非结构化数据. 包括诸如文本.图像.音频.视频和其他格式的信息. 此外机器学习和人工智能在业务的各个方面变得越来越普遍, ...
- 基于 Apache Hudi 极致查询优化的探索实践
摘要:本文主要介绍 Presto 如何更好的利用 Hudi 的数据布局.索引信息来加速点查性能. 本文分享自华为云社区<华为云基于 Apache Hudi 极致查询优化的探索实践!>,作者 ...
- 基于 DataLakeAnalytics 的数据湖实践
随着软硬件各方面条件的成熟,数据湖(Data Lake)已经越来越受到各大企业的青睐, 与传统的数仓实践不一样的是,数据湖不需要专门的“入仓”的过程,数据在哪里,我们就从哪里读取数据进行分析.这样的好 ...
随机推荐
- java-反射-注解-json-xml
反射: 框架设计的灵魂 框架:半成品软件.可以再框架的基础上进行软件开发,简化代码 定义:将类的各个组成部分封装为其他对象,这就是反射机制 好处: 可以再程序运行过程中,操作这些对象 可以解耦,提高程 ...
- 外部晶振的使用原因与内部RC振荡器的使用方法 _
原因一 早些年,芯片的生产制作工艺也许还不能够将晶振做进芯片内部,但是现在可以了.这个问题主要还是实用性和成本决定的. 原因二 芯片和晶振的材料是不同的,芯片 (集成电路) 的材料是硅,而晶体则是 ...
- 如何解决Ubuntu下的“E: Unable to correct problems, you have held broken packages.”的问题. aptitude
今天安装build-essential时出现了以下问题,这属于包的依赖. 解决方案: 1,sudo apt-get install aptitude:完成aptitude命令安装 2,sudo apt ...
- Altium design16设计技巧
第一栏:共有界面 1.在原理图和PCB都打开的情况下,选中原理图可以对应到PCB界面元件里面 第二栏:原理图界面 1.批量改变元件属性 选择某一元件-查找相似对象-将其要改变的内容设置为same-点击 ...
- 可想实现一个自己的简单jQuery库?(九)
Lesson-8 事件机制 在讲事件机制之前呢,我们有一个很重要的东西要先讲,那就是如何实现事件委托(代理). 只有必须先明白了如何实现一个事件委托,我们才能更好的去实现on和off.在我看来,on和 ...
- web项目中视频的上传和展示
思路: 上传:<form>表单提交视频-->后台使用字节流保存到本地. 展示:<video>标签展示: src属性发送请求 --> 使用字节流将视频绑定到响应并返回 ...
- java中为什么把Checked Exception翻译成受检的异常?
6.Checked Exception(受检的异常) 马克-to-win:为什么我大胆的把Checked Exception翻译成受检的异常?因为这类异常,编译器检查发现到它后会强令你catch它或t ...
- 【Android开发】【布局】 仿QQ的UI
Demo地址
- shiro+springboot分析思路
文章目录 前言 一.为什么要使用shiro 二.使用步骤 1.如何认证和授权 2.如何获取数据 总结 前言 shiro和spring security等安全框架可以用户管理和权限认证 一.为什么要使用 ...
- Shiro之权限管理的概念
文章目录 前言:什么是shiro 一.什么是权限管理? 举例 二.权限管理的具体分类 1.身份认证 2.授权 总结 前言:什么是shiro Apache Shiro 是一个开源安全框架,提供身份验证. ...