
Java并发编程之多线程
线程
进程/线程/协程/管程
- 进程:操作系统会以进程为单位,分配系统资源(CPU时间片、内存等资源),是资源分配的最小单位
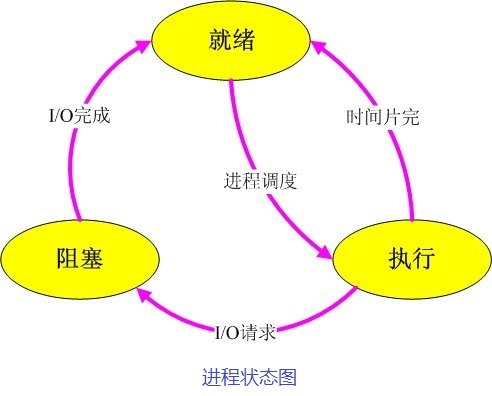
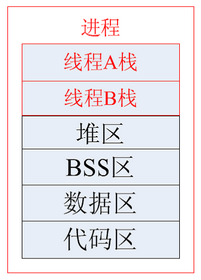
进程间通信(IPC):
- 管道(Pipe)
- 命名管道(FIFO)
- 消息队列(Message Queue)
- 信号量(Semaphore)
- 共享内存(Shared Memory)
- 套接字(Socket)
- 线程:也被称为轻量级进程(Lightweight Process,LWP),是操作系统调度(CPU调度)执行的最小单位
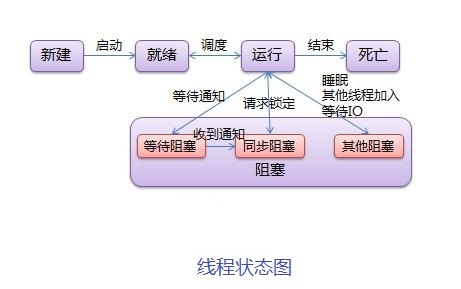
- 线程作为调度和分配的基本单位,进程作为拥有资源的基本单位
- 一个线程只能属于一个进程,而一个进程可以有多个线程,但至少有一个线程
- 资源分配给进程,同一进程的所有线程共享该进程的所有资源
- 多进程的程序要比多线程的程序健壮(进程崩溃不影响其它进程),但在进程切换时,耗费资源较大,效率要差一些
- 进程/线程之间的亲缘性决定了同一个进程/线程只在某个cpu上运行,避免因切换带来的CPU的L1/L2 cache失效而造成性能损失
- 协程/协程/微线程:一种比线程更加轻量级的存在,不被操作系统内核所管理,而完全是由程序所控制(也就是在用户态执行)
- 极高的执行效率:因为子程序切换不是线程切换,而是由程序自身控制,因此,没有线程切换的开销,和多线程比,线程数量越多,协程的性能优势就越明显;
- 不需要多线程的锁机制:因为只有一个线程,也不存在同时写变量冲突,在协程中控制共享资源不加锁,只需要判断状态就好了,所以执行效率比多线程高很多
- 资源占用小,初始一般为2KB,而线程java中默认1M
- java原生不支持,可以关注quasar,适合I/O密集型操作
- 参考:Java里的协程
- 管程 (英语:Monitors,也称为监视器):用来管理共享变量以及对共享变量操作的过程,它解决了并发编程中的两大核心问题:互斥与同步。翻译为Java领域的语言,就是管理类的成员变量和成员方法,让这个类是线程安全的
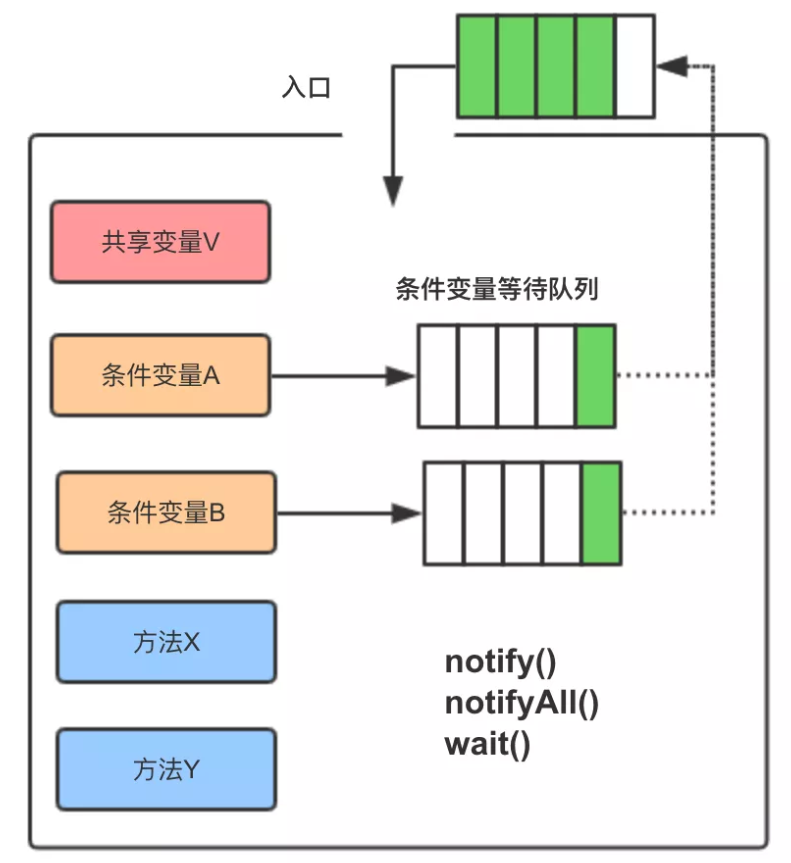
- 如上图的管程模型图中,方框代表管程对共享变量以及操作共享变量方法的封装,在入口处有一个等待队列,当有多个线程试图进入管程时,管程只允许一个线程进入,其他的线程进入到等待队列中
- 在管程中引入了条件变量的概念,每个条件变量都对应一个等待队列。如图中的条件变量A和B分别对应一个等待队列
- synchronized的底层实现就是通过管程实现,不过只支持一个条件变量
- Lock和Condition也是通过管程模型来实现锁的。其中Lock用来实现互斥的,Condition用来实现同步的,支持多条件变量
并行/并发
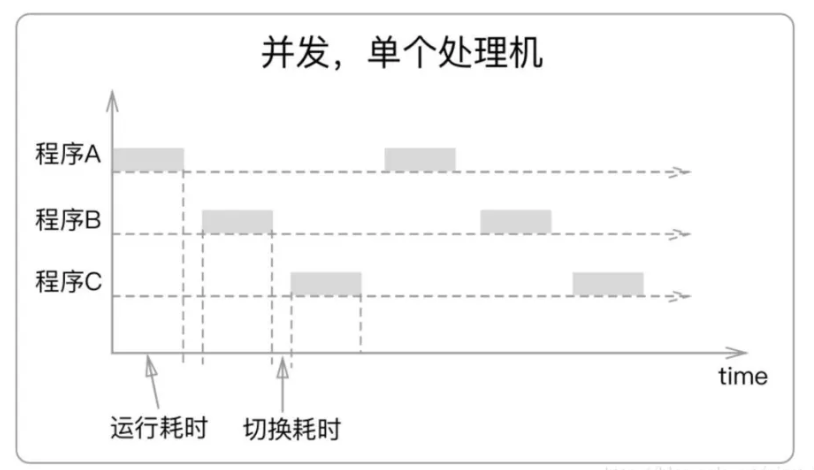
- 并发(Concurrent):当多个线程在操作时,如果系统只有一个CPU,则它根本不可能真正同时进行一个以上的线程,只是把CPU运行时间划分成若干个时间段,再将时间段分配给各个线程执行。同一个时刻只有一个线程在执行,其他线程挂起
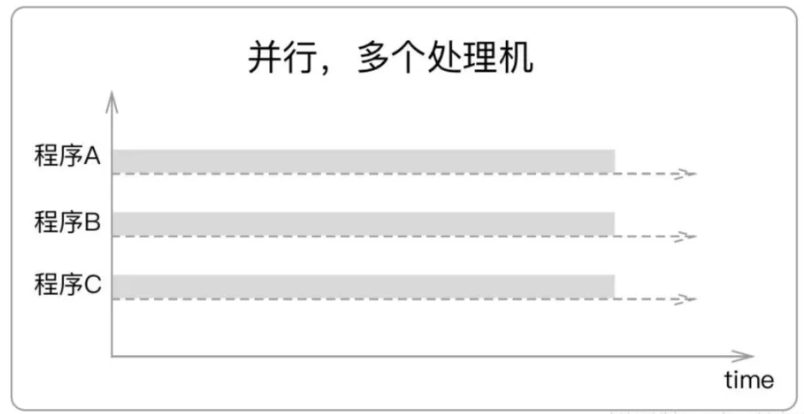
- 并行(Parallel):当系统有一个以上CPU时,多个线程可以在不同CPU上执行,相互不抢占资源,同一时刻可以同时进行
线程状态
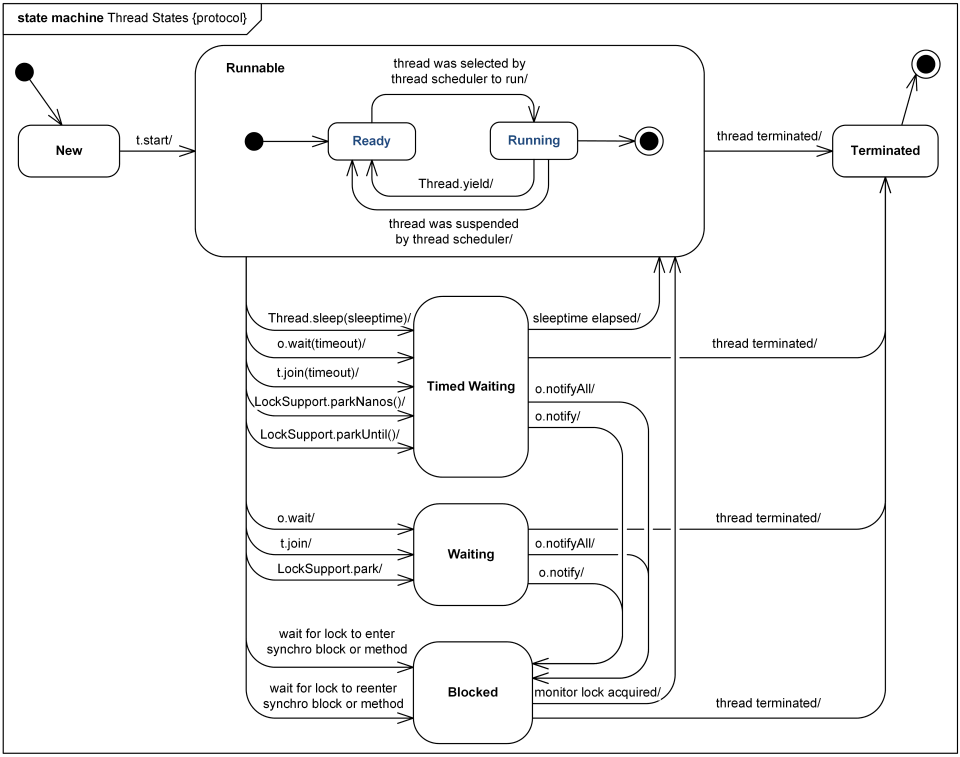
看线程处状态:
- Thread 类中getState()方法用于查看当前线程状态
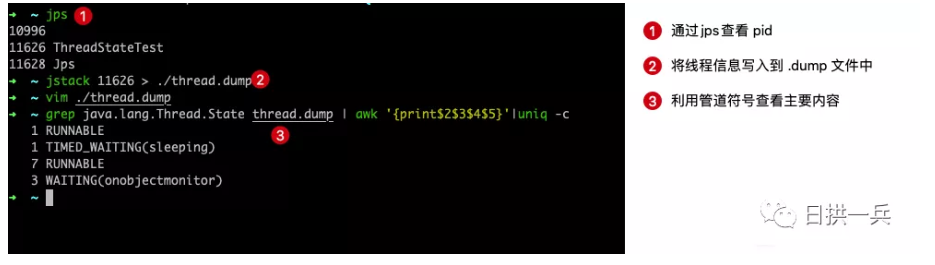
- jstack 命令查看
- Arthas:线上监控利器
异常处理
在多线程的情况下,主线程无法捕捉到子线程异常信息。对此,Java为我们提供了UncaughtExceptionHandler接口,当线程在运行过程中出现异常时,Java虚拟机执行以下步骤:
使用thread.getuncaughtexceptionhandler()查询线程的uncaughtException处理程序
调用处理程序的uncaughtException方法,将线程和异常作为参数传递
- 如果一个线程没有显式地设置它的UncaughtExceptionHandler,那么它的ThreadGroup对象就充当它的UncaughtExceptionHandler,默认实现如下:
private final ThreadGroup parent;

public void uncaughtException(Thread t, Throwable e) {

    // 如果有父ThreadGroup,则直接调用父Group的uncaughtException

    if (parent != null) {

        parent.uncaughtException(t, e);

    } else {

        // 如果设置了全局默认的UncaughtExceptionHandler,调用全局的uncaughtException

        Thread.UncaughtExceptionHandler ueh =

            Thread.getDefaultUncaughtExceptionHandler();

        if (ueh != null) {

            ueh.uncaughtException(t, e);

        } else if (!(e instanceof ThreadDeath)) {

            // 如果没有父ThreadGroup且没有全局默认的UncaughtExceptionHandler,直接将异常的堆栈信息定向到System.err中

            System.err.print("Exception in thread \""

                             + t.getName() + "\" ");

            e.printStackTrace(System.err);

        }

    }

}
- 设置了自定义异常处理类
static class MyExceptionHandler implements Thread.UncaughtExceptionHandler {

    @Override

    public void uncaughtException(Thread t, Throwable e) {

        // 异常处理

        System.out.println(t.toString());

        System.out.println(e.getMessage());

    }

}

public static void main(String[] args) throws InterruptedException {

    ThreadDemo thread = new ThreadDemo();

    // 方式1、设置全局异常处理器

    Thread.setDefaultUncaughtExceptionHandler(handler);

    // 方式2、为特定线程指定异常处理器

    thread.setUncaughtExceptionHandler(new MyExceptionHandler());

    thread.start();

}
- 线程池中上述自定义异常处理器设置不一定生效,详见下文
- 在子线程中通过try catch捕获并处理所有异常也是可以的,缺点在于需要大量的try catch块,异常处理与业务逻辑耦合,且有可能遗漏异常,建议使用异常处理器
中断机制
一种协同机制,Java的每个线程对象里都有一个boolean类型的标识,代表是否有中断请求,通过底层native方法实现的
- 中断触发
- interrupt():唯一一个可以将上面提到中断标志设置为 true 的方法
- interrupt会调用((JavaThread*)thread)->parker()->unpark(),将_counter设置为1,后面调用park不会阻塞
- 中断手动检测
- isInterrupted():返回中断标识的结果
- interrupted():调用private的isInterrupted()方法,唯一差别就是会清空中断标识,用于可能要被大量中断但确保只处理一次中断时
Thread.currentThread().isInterrupted(); // true

Thread.interrupted() // true,返回true后清空了中断标识将其置为 false

Thread.currentThread().isInterrupted(); // false

Thread.interrupted() // false
- 中断自动检测机制:以下方法如果被中断,直接抛出 InterruptedException 受检异常,并清空中断标识
- wait()
- join()
- sleep()
- ...
本意是当前线程被中断之后,退出while(true), 以下代码有问题吗?
Thread th = Thread.currentThread();

while(true) {

  if(th.isInterrupted()) {

    break;

  }

  // 省略业务代码

  try {

    Thread.sleep(100);

  }catch (InterruptedException e){

    e.printStackTrace();

  }

}
Java中中断机制应用
- ThreadPoolExecutor 中的 shutdownNow 方法会遍历线程池中的工作线程并调用线程的 interrupt 方法来尝试中断线程,并不保证一定能终止
- FutureTask 中的 cancel 方法,如果传入的参数为 true,它将会在正在运行异步任务的线程上调用 interrupt 方法,如果正在执行的异步任务中的代码没有对中断做出响应,那么 cancel 方法中的参数将不会起到什么效果
- Lock中lockInterruptibly,使用LockSupport.park(this)堵塞线程后,如果调用interrupt方法,会响应中断标识并抛出InterruptedException(如何响应?interrupt内部会调用unpark)
LockSupport
LockSupport 方法中重要的两个方法就是park 和 unpark
A((park))-->B{_counter > 0}
B-->|是|C[_counter = 0]
C-->D((return))
B-->|否|E{is_interrupted}
E-->|中断状态|D
E-->|否|F[挂起]
G((unpark))-->H[_counter = 1]
H-->|set|L((_counter))
B-->|get|L
C-->|set|L
H-->M[唤醒]
- 无论调用多少次unpark,都只会将_counter置为1
- 每次park都会将_counter置为0,如果之前为1,则直接返回
- park会响应线程中断(interrupt会调用((JavaThread*)thread)->parker()->unpark(),将_counter设置为1),但不会清除中断标志
- 参考:interrupt()中断行为研究
线程间通信
使用共享内存,volatile关键字修饰共享变量
使用Object类的wait()和notify()方法,必须配合synchronized使用
使用JUC工具类,例如:CountDownLatch,基于AQS框架
使用ReentrantLock结合Condition
基本LockSupport实现线程间的挂起和唤醒
ThreadLocal方式:线程内部通信
ThreadLocal.ThreadLocalMap是Thread的一个属性threadLocals
ThreadLocalMap是ThreadLocal的静态内部类,自身实现k-v结构,默认数组长度16,自动扩容
以当前线程的ThreadLocal作为key,但实际存放在Entry中的是它的弱引用。当ThreadLocal强引用失效,GC后Entry中的key就会变为null,如果当前线程一直不结束,这些key为null的Entry的value就会一直存在一条强引用链:Thread Ref -> Thread -> ThreaLocalMap -> Entry -> value永远无法回收,造成内存泄漏。因此,不用时需要手动remove
public class ThreadLocal<T> {

    ...

    public void set(T value) {

        Thread t = Thread.currentThread();

        ThreadLocalMap map = getMap(t);

        if (map != null)

            map.set(this, value); // key使用的是当前的ThreadLocal对象,内部封装Entry继承了WeakReference

        else

            createMap(t, value);

    }

    ThreadLocalMap getMap(Thread t) {

        return t.threadLocals;

    }

    void createMap(Thread t, T firstValue) {

        // ThreadLocalMap实际归属于当前线程

        t.threadLocals = new ThreadLocalMap(this, firstValue);

    }

    ...

}
InheritableThreadLocal:父子线程间通信
- ThreadLocal.ThreadLocalMap是Thread的一个属性inheritableThreadLocals
- ThreadLocal的子类,重写了父类的方法:createMap()、getMap()、childValue()
- new Thread()会获取当前Thread,当父线程中的inheritableThreadLocal被赋值时,会将当前线程的inheritableThreadLocal变量进行createInheritedMap(),即父线程的变量值赋值给子线程。需要注意的是此处是浅拷贝,且线程池下失效,解决方案阿里的TransmittableThreadLocal
join方式:当在一个线程调用另一个线程的join方法时,当前线程阻塞等待被调用join方法的线程执行完毕才能继续执行
JVM线程调度策略
JVM使用抢占式、基于优先权的调度策略,依托底层平台的线程调度策略,与本地线程是一对一地绑在一起的,应用程序通过setPriority()方法设置的线程优先级,将映射到内核级线程的优先级,影响内核的线程调度,但不能保证真实的执行顺序。
一个线程仅在如下四种情况下才会放弃CPU:
- 被一个更高优先级的线程抢占
- 结束
- 时间片到
- 执行导致阻塞的系统调用
线程池
线程池介绍
在 JDK 1.5 之后推出了相关的 api,常见的创建线程池方式有以下几种:
- Executors.newCachedThreadPool():无限线程池
- Executors.newFixedThreadPool(nThreads):创建固定大小的线程池
- Executors.newSingleThreadExecutor():创建单个线程的线程池
- Executors.newScheduledThreadPool(corePoolSize):创建周期性线程池
其实看这三种方式创建的源码就会发现:
public static ExecutorService newCachedThreadPool() {

    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,

                                  60L, TimeUnit.SECONDS,

                                  new SynchronousQueue<Runnable>());

}

public static ExecutorService newFixedThreadPool(int nThreads) {

    return new ThreadPoolExecutor(nThreads, nThreads,

                                  0L, TimeUnit.MILLISECONDS,

                                  new LinkedBlockingQueue<Runnable>());

}

public static ExecutorService newSingleThreadExecutor() {

    return new FinalizableDelegatedExecutorService

        (new ThreadPoolExecutor(1, 1,

                                0L, TimeUnit.MILLISECONDS,

                                new LinkedBlockingQueue<Runnable>()));

}

// ScheduledThreadPoolExecutor继承ThreadPoolExecutor

public ScheduledThreadPoolExecutor(int corePoolSize) {

    super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,

        new DelayedWorkQueue());

}
实际上还是利用 ThreadPoolExecutor 类实现的,核心参数如下:
- corePoolSize 为核心线程池大小,默认不回收,除非设置allowCoreThreadTimeOut
- maximumPoolSize 为线程池最大线程大小
- keepAliveTime 和 unit 则是线程空闲后的存活时间
- workQueue 用于存放任务的阻塞队列
- threadFactory 线程工厂
- handler 当队列和最大线程池都满了之后的饱和策略
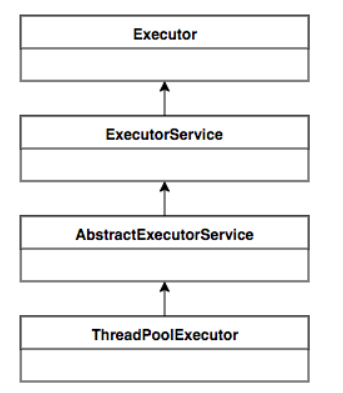
ThreadPoolExecutor的继承关系如下:
线程池原理
- ThreadPoolExecutor运行流程

- 任务管理
- 直接申请线程执行该任务
- 缓冲到队列中等待线程执行
- 拒绝该任务
- 线程管理:根据任务请求进行线程的分配,当线程执行完任务后则会继续获取新的任务去执行,最终当线程获取不到任务的时候,线程就会被回收
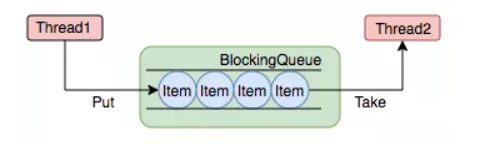
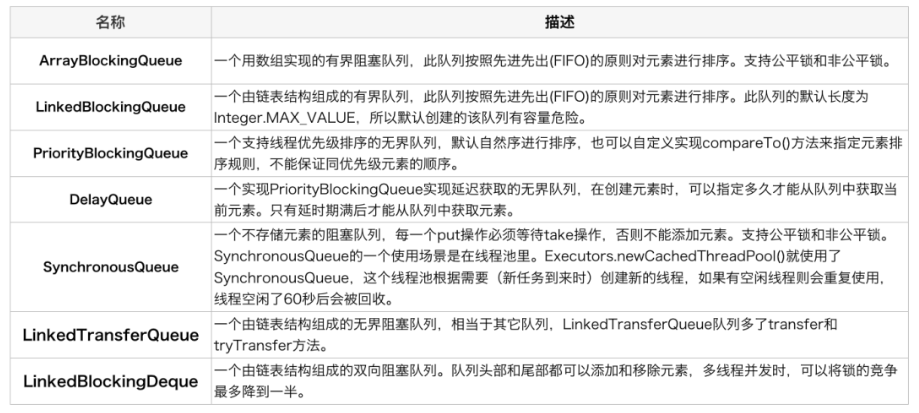
- 任务缓冲:使用阻塞队列实现了任务和线程管理的解耦
- 使用不同的队列可以实现不一样的任务存取策略
ThreadPoolExecutor的5种运行状态
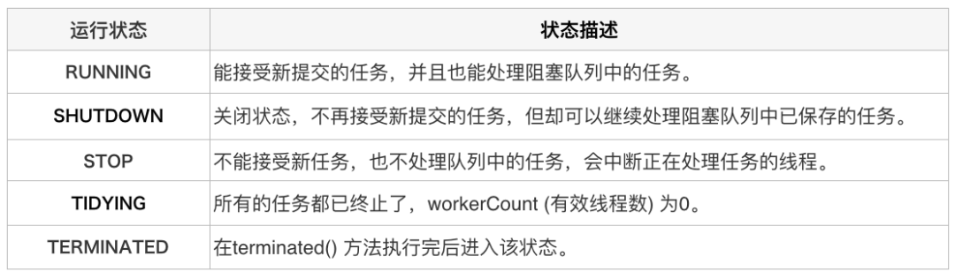
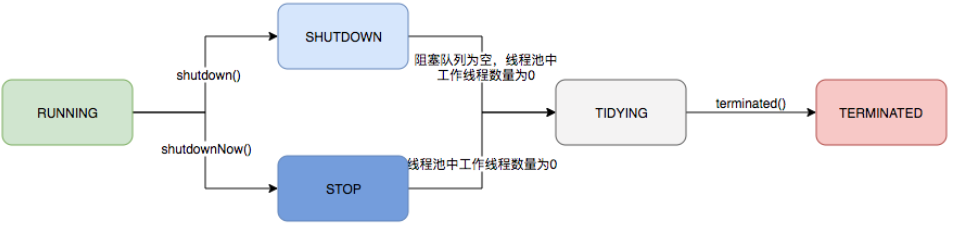
生命周期转换
ctl:线程池状态控制,使用AtomicInteger表示
- 高 3 位用来表示状态,因为有 5 种状态,需要 3 位表示
- 低 29 位用来表示 CAPACITY 即线程池的最大线程容量
- 任务调度流程
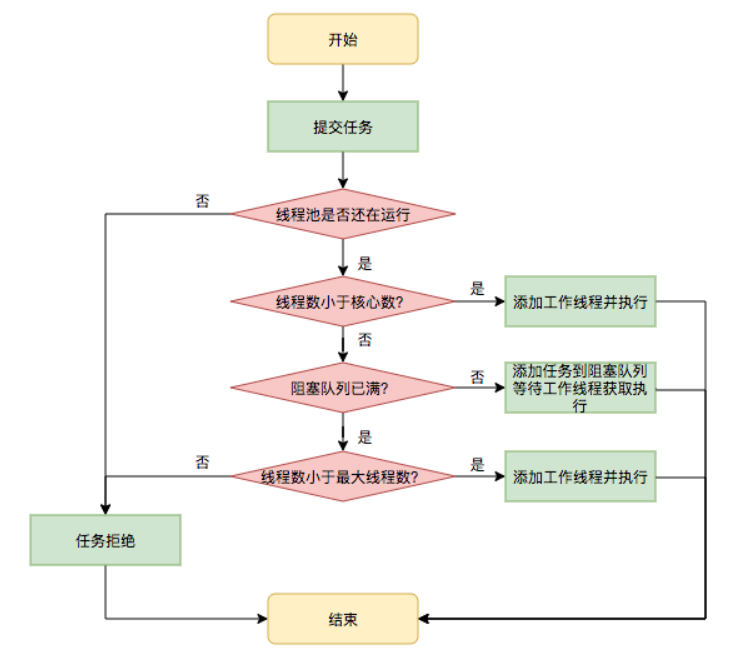
堵塞队列未满时,会加入堵塞队列等待工作线程获取执行。这时候还会做以下处理:
- 校验线程池是否处于运行状态,否则从堵塞队列清除任务并拒绝该任务
- 如果worker数量等于0,创建一个worker去获取堵塞队列中任务
- Worker线程管理
线程池为了掌握线程的状态并维护线程的生命周期,设计了线程池内的工作线程Worker。我们来看一下它的部分代码:
private final class Worker extends AbstractQueuedSynchronizer implements Runnable{

    final Thread thread;// Worker持有的线程,调用构造方法时通过ThreadFactory来创建的线程,用来执行任务

    Runnable firstTask;// 待执行任务,我们自定义的任务类

}
关注点:
- firstTask:
- 非空:传入的第一个任务,启动初期立即执行这个任务,然后再从任务列表中拉取任务执行
- 为空:入参为空,从任务列表(workQueue)中拉取任务执行
- thread:真正执行任务的线程,firstTask作为一个普通类调用其run方法
Worker调度流程
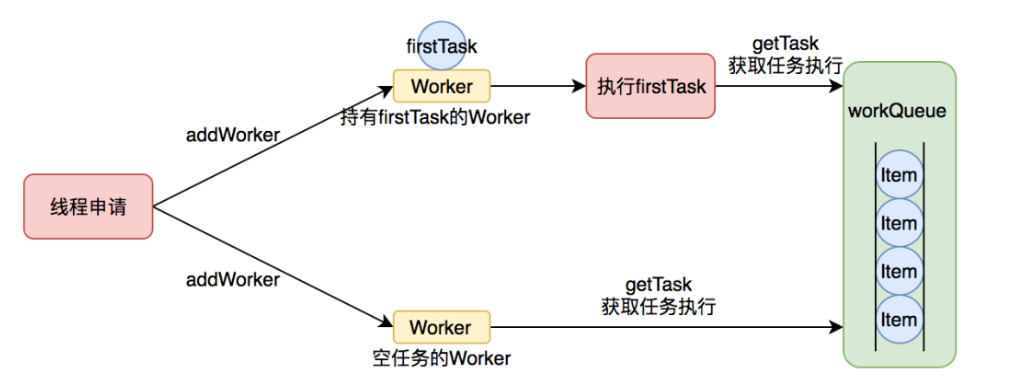
addWorker参数:
- Runnable firstTask:待执行任务,仅以下情况非空
- 小于核心线程数时,core=true
- 堵塞线程已满且线程小于最大线程数时,core=false
- boolean core:worker最大数量校验,worker count < (core ? corePoolSize : maximumPoolSize)
Worker执行流程
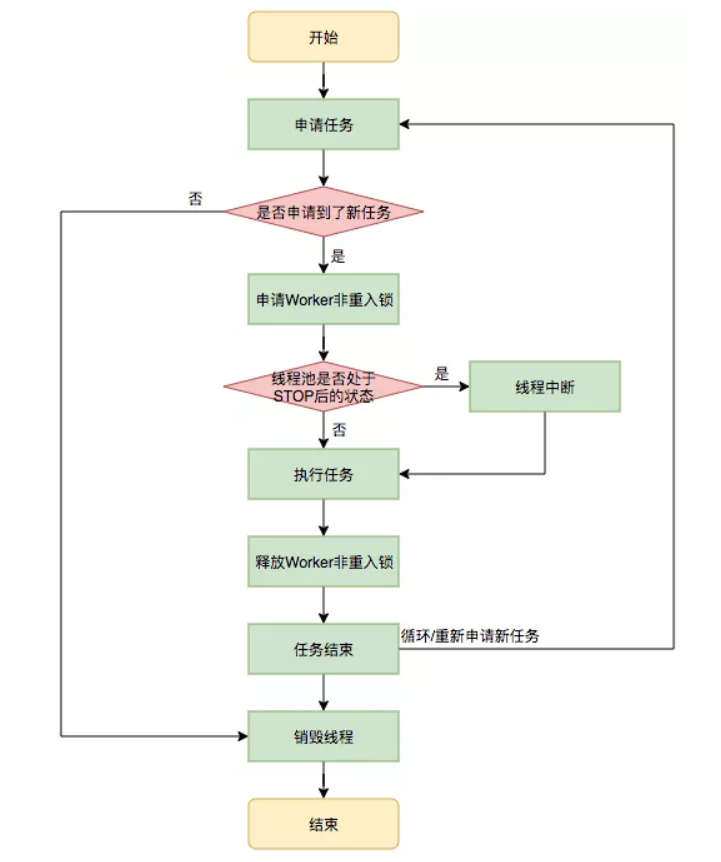
关注点:
- while循环不断地通过getTask()方法获取任务
- 非重入锁:继承AQS实现非重入独占锁,利用其特性获取线程执行状态,获取锁成功即空闲。非核心线程的回收也是利用这一点
- 线程中断只是状态的改变,不影响当前任务的执行
- 销毁线程:核心线程不是不销毁吗?
- 核心线程和非核心线程没有明确的标识,只是进行数量的控制
- 获取任务时,当允许核心线程超时(allowCoreThreadTimeOut=true)或者worker大于核心线程数,使用堵塞队列的poll(keepAliveTime)限时堵塞,否则使用take()进入堵塞状态。获取任务超时或者非返回值任务异常抛出都会中断while循环,执行worker退出。因为同时获取失败的worker数量不能保证,有可能销毁后数量小于核心线程数,所以需要进行worker补偿
- worker补偿,移除worker后执行以下操作
- 判断线程池是否stop,若未停止,计算当前最小线程数n(若队列有任务,最小值为1)
- 若worker数量小于n,调用addWorker(null,false)
线程池回收过程
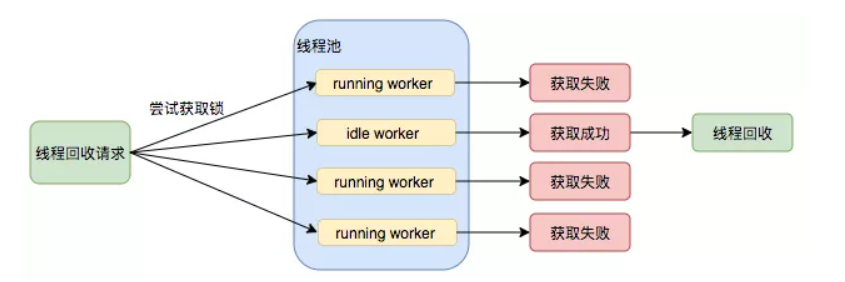
除了worker自旋因为getTask失败而回收,线程池在执行shutdown方法或tryTerminate方法时也会调用interruptIdleWorkers方法来中断空闲的线程,interruptIdleWorkers方法会使用tryLock方法来判断线程池中的线程是否是空闲状态;如果线程是空闲状态则可以安全回收
任务拒绝
拒绝策略是一个接口,其设计如下:
public interface RejectedExecutionHandler {

    void rejectedExecution(Runnable r, ThreadPoolExecutor executor);

}
用户可以通过实现这个接口去定制拒绝策略,也可以选择JDK提供的四种已有拒绝策略,其特点如下:
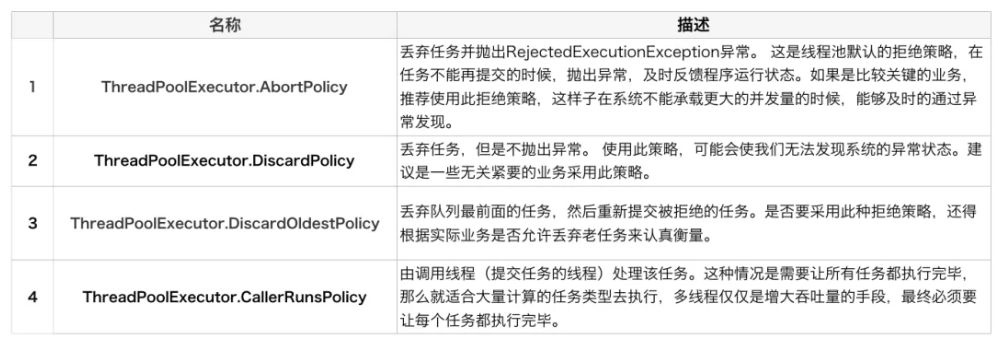
异常处理
上文介绍了多线程中异常处理机制UncaughtExceptionHandler,接下来看一下在线程池中的表现,如下:
static class MyExceptionHandler implements Thread.UncaughtExceptionHandler {

    @Override

    public void uncaughtException(Thread t, Throwable e) {

        // 异常处理

        System.out.println(t.toString());

        System.out.println(e.getMessage());

    }

}

public static void main(String[] args) throws ExecutionException, InterruptedException {

    MyExceptionHandler myExceptionHandler = new MyExceptionHandler();

    // 方式一:设置全局异常处理器

    Thread.setDefaultUncaughtExceptionHandler(myExceptionHandler);

    ExecutorService executorService = Executors.newFixedThreadPool(3, new ThreadFactory() {

        AtomicInteger index = new AtomicInteger(0);

        @Override

        public Thread newThread(Runnable r) {

            Thread thread = new Thread(r, " thread-" + index.incrementAndGet());

            // 方式二:线程工厂中为线程指定异常处理器

            thread.setUncaughtExceptionHandler(myExceptionHandler);

            return thread;

        }

    });

    // 无返回值提交任务:自定义异常处理器生效

    executorService.execute(() -> System.out.println(10/0));

    // 有返回值提交任务:方式二自定义异常处理器失效

    Future<Integer> future = executorService.submit(() -> 10/0);

    System.out.println(future.get());

}
- 有返回值提交任务:FutureTask的run方法中捕获了异常且未抛出(缓存起来),在主线程调用get方法获取返回值时,会封装在ExecutionException中重新抛出。即任务线程实际并未抛出异常不会触发UncaughtExceptionHandler,而主线程由于获取返回值触发了异常抛出。因此方式二自定义异常处理器不会生效,方式一输出的线程名称是main主线程
- 无返回值提交任务:任务线程异常会抛出异常中断while循环(不断获取任务),此时会remove掉当前worker,并根据需要重新创建一个新的worker(若线程池处于运行状态,且worker数量小于n,若堵塞队列有任务,最小值n不能为0)
线程池使用与关闭
// 设置自己的线程名称,便于问题定位

ThreadFactory namedThreadFactory = new ThreadFactoryBuilder()

        .setNameFormat("your-queue-thread-%d").build();

ExecutorService pool = new ThreadPoolExecutor(5, 5, 0L, TimeUnit.MILLISECONDS,

        new ArrayBlockingQueue<Runnable>(5),namedThreadFactory,new ThreadPoolExecutor.AbortPolicy());

long start = System.currentTimeMillis();

for (int i = 0; i <= 5; i++) {

    pool.execute(new Job());

}

pool.shutdown();

while (!pool.awaitTermination(1, TimeUnit.SECONDS)) {

    LOGGER.info("线程还在执行。。。");

}

long end = System.currentTimeMillis();

LOGGER.info("一共耗时【{}】", (end - start));
线程池设置
在正确的场景下通过设置正确个数的线程来最大化程序的运行速度

使用场景
CPU 密集型程序:一个完整请求,I/O操作可以在很短时间内完成, 但CPU还有很多运算要处理,也就是说 CPU 计算的比例占很大一部分
- 单核CPU

同一时刻只有一个线程在运行,加上四个线程上下文切换的开销,比单线程更耗时
多核CPU

上图在4 核CPU下,每个线程都在运行,不用等待CPU时间,也没有线程切换开销。因此,可以最大化的利用 CPU 核心数来提高效率
- 单核CPU
I/O 密集型程序:一个完整请求,CPU运算操作完成之后还有很多 I/O 操作要做,也就是说 I/O 操作占比很大部分

上图中CPU耗时是I/O耗时的两倍,如果I/O耗时倍数再增大,CPU就空闲下来,就可以新增线程来最大化利用CPU
综上两种情况可以得出以下结论:
- 通过设置合理线程数,避免CPU资源竞争的情况下最大化CPU利用率100%。即线程等待时间所占比例越高,需要越多线程;线程CPU时间所占比例越高,需要越少线程
如何设置?
- CPU 密集型:CPU 核数(逻辑)+ 1
- 为什么加1?计算(CPU)密集型的线程恰好在某时因为发生一个页错误或者因其他原因而暂停,刚好有一个“额外”的线程,可以确保在这种情况下CPU周期不会中断工作
- I/O密集型:最佳线程数 = CPU核心数 * (1/CPU利用率) = CPU核心数 * (1 + (I/O耗时/CPU耗时)),假如几乎全是 I/O耗时,理论上就是2N(N=CPU核数),也有说 2N + 1(留一个备用)
练习
- 假设要求一个系统的 TPS(Transaction Per Second 或者 Task Per Second)至少为20,然后假设每个Transaction由一个线程完成,继续假设平均每个线程处理一个Transaction的时间为4s。如何设计线程个数,使得可以在1s内处理完20个Transaction?

- 计算操作需要5ms,DB操作需要 100ms,对于一台 8个CPU的服务器,怎么设置线程数呢?那如果DB的 QPS(Query Per Second)上限是1000,此时这个线程数又该设置为多大呢?

几个疑问?
- 如何甄别一个任务是CPU密集型,还是I/O密集型?
- 任务都是CPU、I/O的混合体,只是两者所占比例的不同。一般都是通过经验值识别任务密集类型,预先设置一个理论值,然后通过实际运行情况进行调优。
- 如何获取I/O耗时、CPU耗时、CPU利用率?
- 可以利用一些APM(Application Performance Manager)工具获取性能数据,例如:SkyWalking、CAT、zipkin等。
- 增加CPU核数是否一定可以增加性能?
- 需要考虑程序的串行率,即程序中互斥带来的影响,临界区的范围大小也是瓶颈的重要考量因素
- 多个线程池的情况下又改如何设置?
- 实际业务场景中往往会出现多个线程池,且不同线程池的流量也不尽相同,计算出合理的参数就更加困难。一种思路,降低修改线程池参数的成本,做到动态配置和即时生效
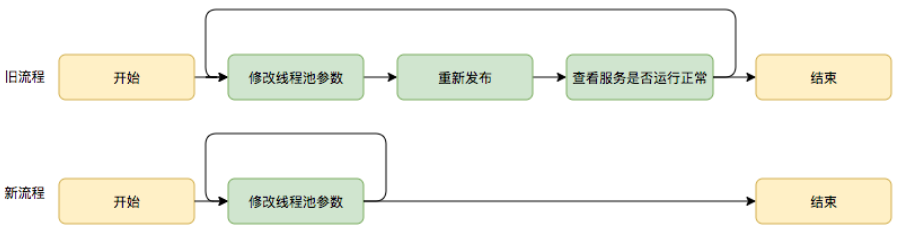
JDK原生线程池ThreadPoolExecutor提供了如下几个public的setter方法,如下图所示:
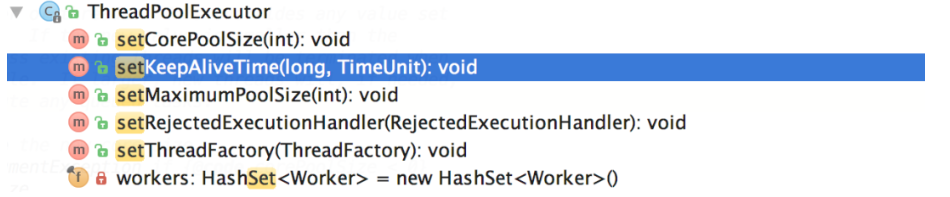
参考:美团动态化线程池方案
- 实际业务场景中往往会出现多个线程池,且不同线程池的流量也不尽相同,计算出合理的参数就更加困难。一种思路,降低修改线程池参数的成本,做到动态配置和即时生效
线程池监控
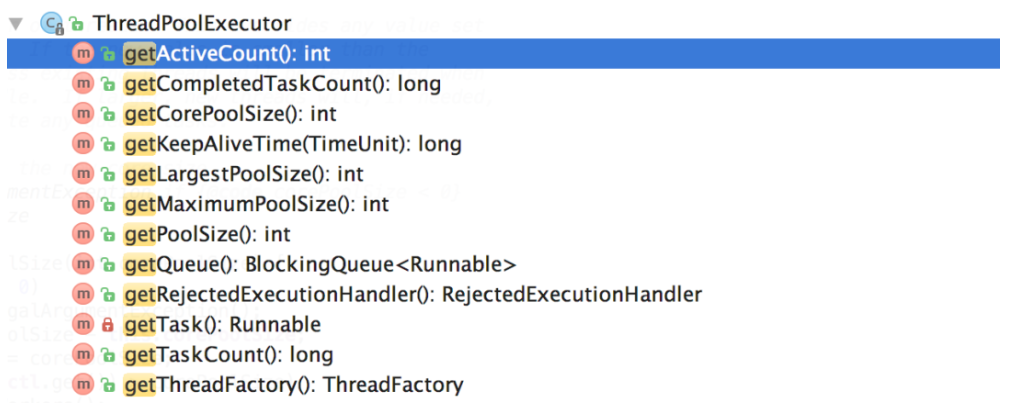
线程是稀缺资源,对线程池的监控可以知道自己任务执行的状况、效率等,ThreadPool 本身已经提供了不少 api 可以获取线程状态,如下图所示:
其他技术
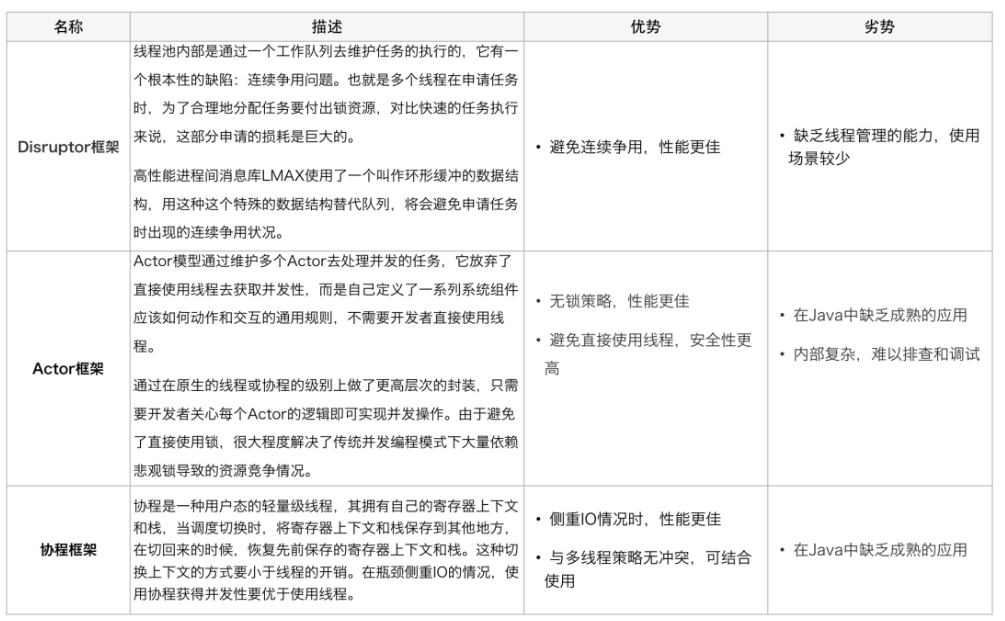
Fork/Join
如果一个应用能被分解成多个子任务,并且组合多个子任务的结果就能够获得最终的答案,那么这个应用就适合用 Fork/Join 模式来解决。示意图如下:

参考:
CompletionService
ExecutorService executorService = Executors.newFixedThreadPool(4);

// ExecutorCompletionService 是 CompletionService 唯一实现类

CompletionService<Integer> executorCompletionService = new ExecutorCompletionService<>(executorService);

List<Future<Integer>> futures = new ArrayList<>();

futures.add(executorCompletionService.submit(A));

futures.add(executorCompletionService.submit(B));

futures.add(executorCompletionService.submit(C));

futures.add(executorCompletionService.submit(D));

// 遍历 Future list,通过 get() 方法获取每个 future 结果

for (int i = 0; i < futures.size(); i++) {

    Integer result = executorCompletionService.take().get();

    // 其他业务逻辑

}
使用ExecutorService同样可以实现上述代码,为什么需要使用CompletionService包装一层?
如果 Future 结果没有完成,调用 get() 方法,程序会阻塞在那里,直至获取返回结果。List中Future哪一个先完成无法预知,有可能第一个最后完成,就会造成take取值长时间堵塞,不能及时拿到已经完成的线程返回值。
如何拿到先完成的Future结果?
重新定义一个QueueingFuture,继承FutureTask,并重写done()方法,将task(即FutureTask)放在堵塞队列(LinkedBlockingQueue)中,取值时从堵塞队列取值即可
使用场景
CompletionService 的应用场景还是非常多的,比如
- Dubbo 中的 Forking Cluster(并行调用多个服务器,只要一个成功就返回)
- 多仓库文件/镜像下载(从最近的服务中心下载后终止其他下载过程)
- 多服务调用(天气预报服务,最先获取到的结果)
CompletionService 不但能满足获取最快结果,还能起到一定 "load balancer" 作用,获取可用服务的结果,使用也非常简单, 只需要遵循范式即可
Java并发编程之多线程的更多相关文章
- Java并发编程、多线程、线程池…
<实战java高并发程序设计>源码整理https://github.com/petercao/concurrent-programming/blob/master/README.md Ja ...
- Java并发编程,多线程[转]
Java并发编程 转自:http://www.cnblogs.com/dolphin0520/category/602384.html 第一个例子(没有阻塞主线程,会先输出over): package ...
- Java并发编程 (十) 多线程并发拓展
个人博客网:https://wushaopei.github.io/ (你想要这里多有) 一.死锁 1.死锁的定义 所谓的死锁是指两个或两个以上的线程在等待执行的过程中,因为竞争资源而造成的一种 ...
- java并发编程与多线程基础学习一
学习url:https://www.cnblogs.com/lixinjie/p/10817860.html https://www.cnblogs.com/JJJ1990/p/10496850.ht ...
- 【Java并发编程】并发编程大合集-值得收藏
http://blog.csdn.net/ns_code/article/details/17539599这个博主的关于java并发编程系列很不错,值得收藏. 为了方便各位网友学习以及方便自己复习之用 ...
- 【Java并发编程】并发编程大合集
转载自:http://blog.csdn.net/ns_code/article/details/17539599 为了方便各位网友学习以及方便自己复习之用,将Java并发编程系列内容系列内容按照由浅 ...
- Java并发编程扩展(线程通信、线程池)
之前我说过,实现多线程的方式有4种,但是之前的文章中,我只介绍了两种,那么下面这两种,可以了解了解,不懂没关系. 之前的文章-->Java并发编程之多线程 使用ExecutorService.C ...
- java并发编程笔记(九)——多线程并发最佳实践
java并发编程笔记(九)--多线程并发最佳实践 使用本地变量 使用不可变类 最小化锁的作用域范围 使用线程池Executor,而不是直接new Thread执行 宁可使用同步也不要使用线程的wait ...
- 多线程(一)java并发编程基础知识
线程的应用 如何应用多线程 在 Java 中,有多种方式来实现多线程.继承 Thread 类.实现 Runnable 接口.使用 ExecutorService.Callable.Future 实现带 ...
随机推荐
- Kafka 博文索引
博文索引 KafkaBroker 简析 KafkaConsumer 简析 KafkaProducer 简析 KafkaMirrorMaker 的不足以及一些改进 Kafka 简介 数据是系统的燃料,系 ...
- 如何实现 React 模块动态导入
如何实现 React 模块动态导入 React 模块动态导入 代码分割 webpack & code splitting https://reactjs.org/docs/code-split ...
- ODM & mongoose
ODM & mongoose ODM (object data modeling) https://mongoosejs.com/ MongoDB NoSQL xgqfrms 2012-202 ...
- Jenkins Ansible GitLab 自动化部署
Jenkins Ansible GitLab 自动化部署 DevOps https://www.cnblogs.com/yangjianbo/articles/10393765.html https: ...
- clisp的一些function
;; example: (write (A-Z :start (+ 65 1) :end 87)) (defmacro A-Z (&key (start 65) (end 90)) (let* ...
- NGK又双叒叕送钱了!百万SPC空投不要错过!
不知不觉,2021年已然到来.回顾过去一年,2020年币圈发生的事情真的是太多太多,比特币的持续暴涨,DeFi一波又一波的空投福利,都让我们见识了区块链的魅力!同样,2021年区块链市场的牛市仍然持续 ...
- fork后子进程与父进程的关系
共享代码空间,各自独立数据空间,子进程初始化数据是父进程的复制. 资料参考: https://blog.csdn.net/u013851082/article/details/76902046
- 聊聊CPU的LOCK指令
本文转载自聊聊CPU的LOCK指令 导语 在多线程操作中,可能最经常被提起的就是数据的可见性.原子性.有序性.不管是硬件方面.软件方面都在这三方面做了很足的工作,才能保证程序的正常运行. 之前发表过一 ...
- 1071 Speech Patterns——PAT甲级真题
1071 Speech Patterns People often have a preference among synonyms of the same word. For example, so ...
- Sqoop 数据迁移工具
Sqoop 数据迁移工具 sqoop : SQL to hadOOP 两个功能: 1. RDB 向HDFS导入 2. HDFS向RDB导入 注:拷贝mysql-connector.jar 和 json ...