
Spark系列 - (3) Spark SQL
3. Spark SQL
3.1 Hive、Shark和Sparksql
Hive:Hadoop刚开始出来的时候,使用的是hadoop自带的分布式计算系统 MapReduce,但是MapReduce的使用难度较大,所以就开发了Hive。Hive的出现解决了MapReduce的使用难度较大的问题,Hive的运行原理是将HQL语句经过语法解析、逻辑计划、物理计划转化成MapReduce程序执行。
Shark:2011年Shark诞生,即Hive on Spark。为了实现与Hive兼容,Shark在HiveQL方面重用了Hive中HiveQL的解析、逻辑执行计划、执行计划优化等逻辑;可以近似认为仅将物理执行计划从MapReduce作业替换成了Spark作业,通过Hive 的HiveQL解析,把HiveQL翻译成Spark上的RDD操作;Shark的出现,使得SQL-on-Hadoop的性能比Hive有了10-100倍的提高。
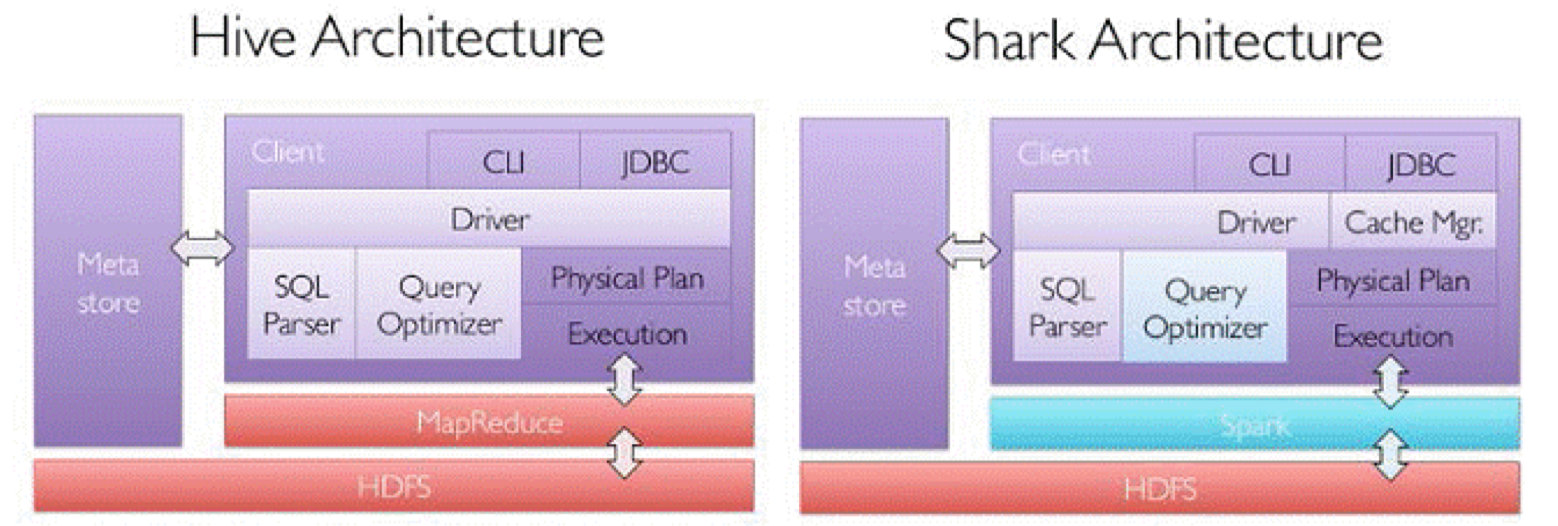
Shark的缺陷:
执行计划优化完全依赖于Hive,不方便添加新的优化策略
因为Spark是线程级并行,而MapReduce是进程级并行,因此,Spark在兼容 Hive的实现上存在线程安全问题,导致Shark不得不使用另外一套独立维护的打了补丁的Hive源码分支。
2014年7月,spark团队将Shark转给Hive进行管理,Hive on Spark是一个Hive的也就是说,Hive将不再受限于一个引擎,可以采用Map-Reduce、Tez、Spark等引擎;
Spark SQL作为Spark生态的一员诞生,不再受限于Hive,只是兼容Hive。
3.2 RDD和DataFrame、DataSet
RDD:弹性(Resilient)、分布式(Distributed)、数据集(Datasets),具有只读、Lazy、类型安全等特点,具有比较好用的API。RDD的劣势体现在性能限制上,它是一个JVM驻内存对象,这也就决定了存在GC的限制和数据增加时Java序列化成本的升高。
DataFrame:与RDD类似,DataFRame也是一个不可变的弹性分布式数据集。除了数据以外,还记录着数据的结构信息,即Schema。另外DataFrame API提供的是一套高层的关系操作,比函数式的RDD API要更加友好。DataFrame的查询计划可以通过Spark catalyst optimiser进行优化,即使 Spark经验并不丰富,用dataframe写得程序也可以尽量被转化为高效的形式予以执行。
DataFrame只是知道字段,但是不知道字段的类型,所以在执行这些操作的时候是 没办法在编译的时候检查是否类型失败的。
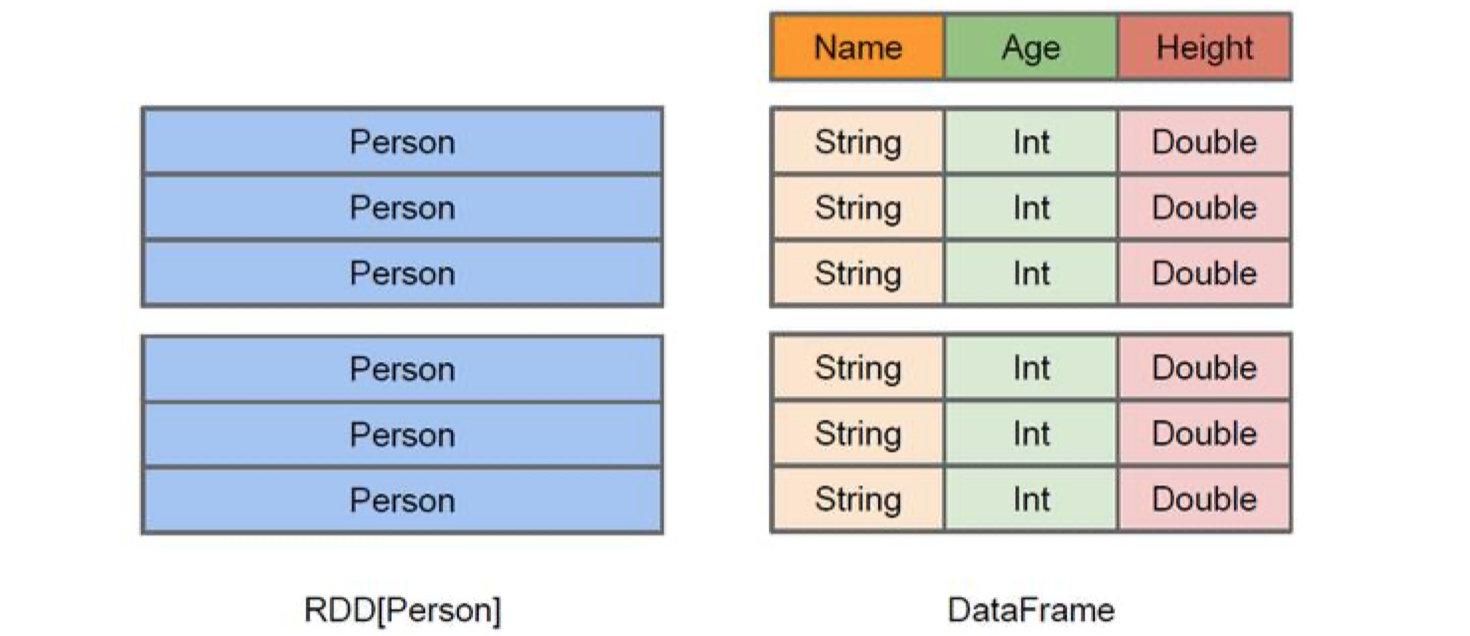
上图直观地体现了 DataFrame 和 RDD 的区别。左侧的 RDD[Person]虽然以Person为类型参 数,但 Spark 框架本身不了解Person 类的内部结构。而右侧的DataFrame却提供了详细的结构信息,使得Spark SQL 可以清楚地知道该数据集中包含哪些列,每列的名称和类型各是什么。 DataFrame是为数据提供了Schema的视图。可以把它当做数据库中的一张表来对待,DataFrame也是懒执行的。性能上比 RDD 要高,主要原因:优化的执行计划:查询计划通过 Spark catalyst optimiser 进行优化。
DataSet:DataSet是DataFrame的扩展,是Spark最新的数据抽象。Dataframe 是 Dataset 的特列,DataFrame=Dataset[Row] ,所以可以通过 as 方法将 Dataframe 转换为 Dataset。Row 是一个类型,跟Car、Person 这些的类型一样,所有的表结构信息我都用 Row 来表示。DataSet 是强类型的。比如可以有 Dataset[Car],Dataset[Person]。DataFrame只是知道字段,但是不知道字段的类型,所以在执行这些操作的时候是没办法在编译的时候检查是否类型失败的,比如你可以对一个String进行减法操作,在执行的时候才报错,而DataSet不仅仅知道字段,而且知道字段类型,所以有更严格的错误检查。就跟JSON对象和类对象之间的类比。
3.2.1 三者的共性
- 都是分布式弹性数据集,为处理超大型数据提供便利;
- 都是Lasy的,在进行创建、转换,如map方法时,不会立即执行,只有在遇到Action如foreach时,三者才会开始遍历运算,极端情况下,如果代码里面有创建、 转换,但是后面没有在Action中使用对应的结果,在执行时会被直接跳过;
- 都有partition的概念;
- 三者有许多共同的函数,如filter,排序等;
- DataFrame和Dataset均可使用模式匹配获取各个字段的值和类型;
- 三者可以相互转化
3.2.2 区别
RDD与DataFrame/DataSet的区别
RDD:
- 用于Spark1.X各模块的API(SparkContext、MLLib,Dstream等)
- 不支持sparksql操作
- 不支持代码自动优化
DataFrame与DataSet:
- 用于Spark2.X各模块的API(SparkSession、ML、StructuredStreaming等等)
- 支持SparkSql操作,比如select,groupby之类,还能注册临时表/视窗,进行 sql语句操作
- 支持一些方便的保存方式,比如保存成csv、json等格式
- 基于sparksql引擎构建,支持代码自动优化
DataFrame与DataSet的区别
DataFrame:
- DataFrame每一行的类型固定为Row,只有通过解析才能获取各个字段的值, 每一列的值没法直接访问。
- DataFrame编译器缺少类型安全检查。
testDF.foreach{

   line => val col1=line.getAs[String]("col1")

   println(col1)

   val col2=line.getAs[String]("col2")

   println(col2)

}
DataSet:
- DataFrame和DataSet之间,可以看成JSON对象和类对象之间的类比。
- DataSet是类型安全的。
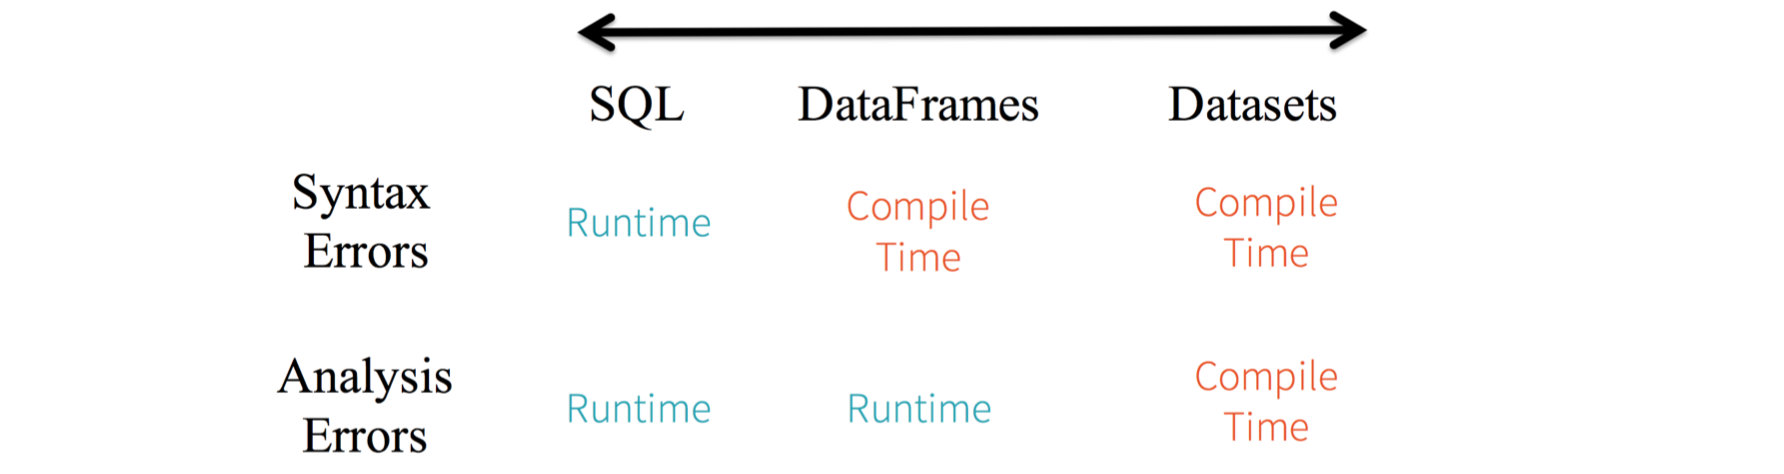
3.2.3 Sql、dataframe、DataSet的类型安全
- 如果使用Spark SQL的查询语句,要直到运行时你才会发现有语法错误(这样做代价很大)。
- 如果使用DataFrame,你在也就是说,当你在 DataFrame 中调用了 API 之外的函数时,编译器就可以发现这个错。但如果此时,使用了一个不存在字段的名字,则只能到运行时才能发现错误;
- 如果用的是DataSet[Person],所有不匹配的类型参数都可以在编译时发现;
3.2.4 什么时候使用DataFrame或DataSet
下面的情况可以考虑使用DataFrame或Dataset,
- 如果你需要丰富的语义、高级抽象和特定领域专用的 API,那就使用 DataFrame 或 Dataset;
- 如果你的处理需要对半结构化数据进行高级处理,如 filter、map、aggregation、 average、sum、SQL 查询、列式访问或使用 lambda 函数,那就使用 DataFrame 或 Dataset;
- 如果你想在编译时就有高度的类型安全,想要有类型的 JVM 对象,用上 Catalyst 优化,并得益于 Tungsten 生成的高效代码,那就使用 Dataset;
- 如果你想在不同的 Spark 库之间使用一致和简化的 API,那就使用 DataFrame 或 Dataset;
- 如果你是R或者Python使用者,就用DataFrame;
除此之外,在需要更细致的控制时就退回去使用RDD;
3.2.5 RDD、DataFrame、DataSet之间的转换
1. RDD转DataFrame、Dataset
- RDD转DataFrame:一般用元组把一行的数据写在一起,然后在toDF中指定字段名。
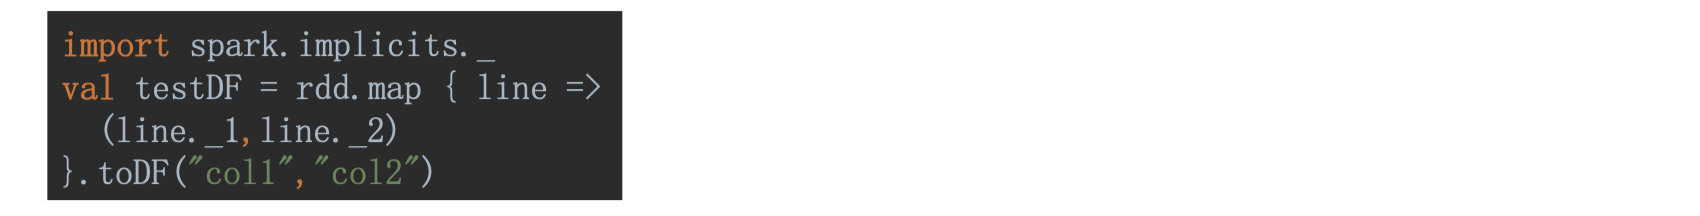
- RDD转Dataset:需要提前定义字段名和类型。
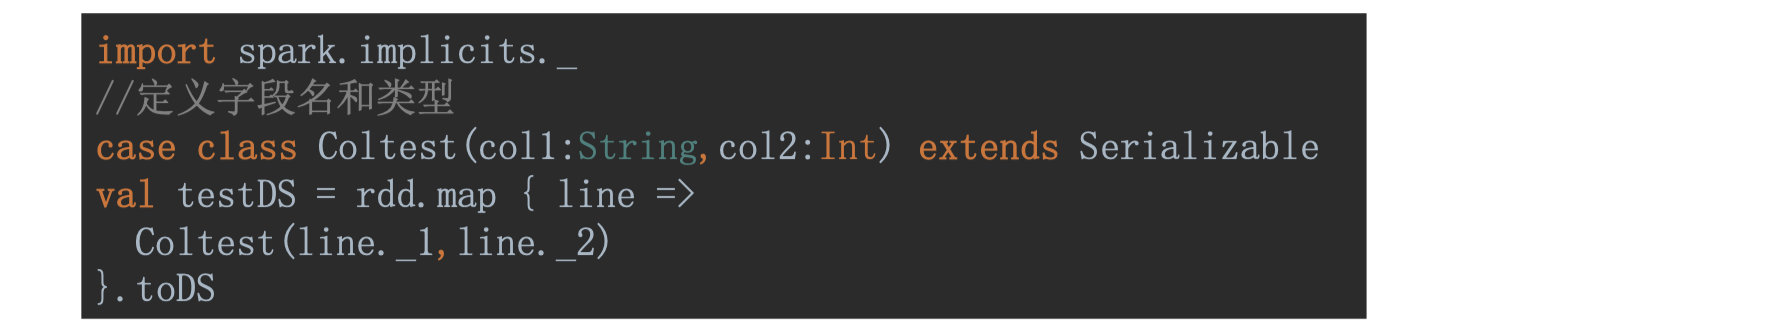
2. DataFrame转RDD、Dataset
- DataFrame转RDD:直接转
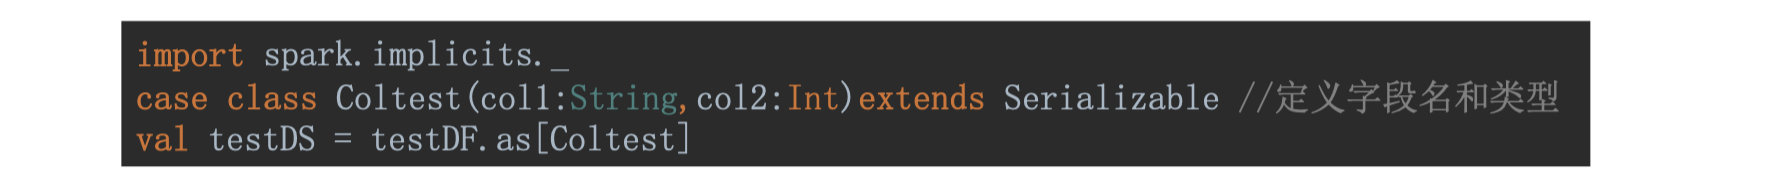
val rdd = testDF.rdd - DataFrame转Dataset:需要提前定义case class,然后使用as方法。
3. Dataset转RDD、DataFrame
- DataSet转RDD:直接转
val rdd = testDS.rdd - DataSet转DataFrame:直接转即可,spark会把case class封装成Row。

3.3 Spark SQL优化
Catalyst是spark sql的核心,是一套针对spark sql 语句执行过程中的查询优化框架。因此要理解spark sql的执行流程,理解Catalyst的工作流程是理解spark sql的关键。而说到Catalyst,就必须提到下面这张图了,这张图描述了spark sql执行的全流程。其中,中间四步为catalyst的工作流程。
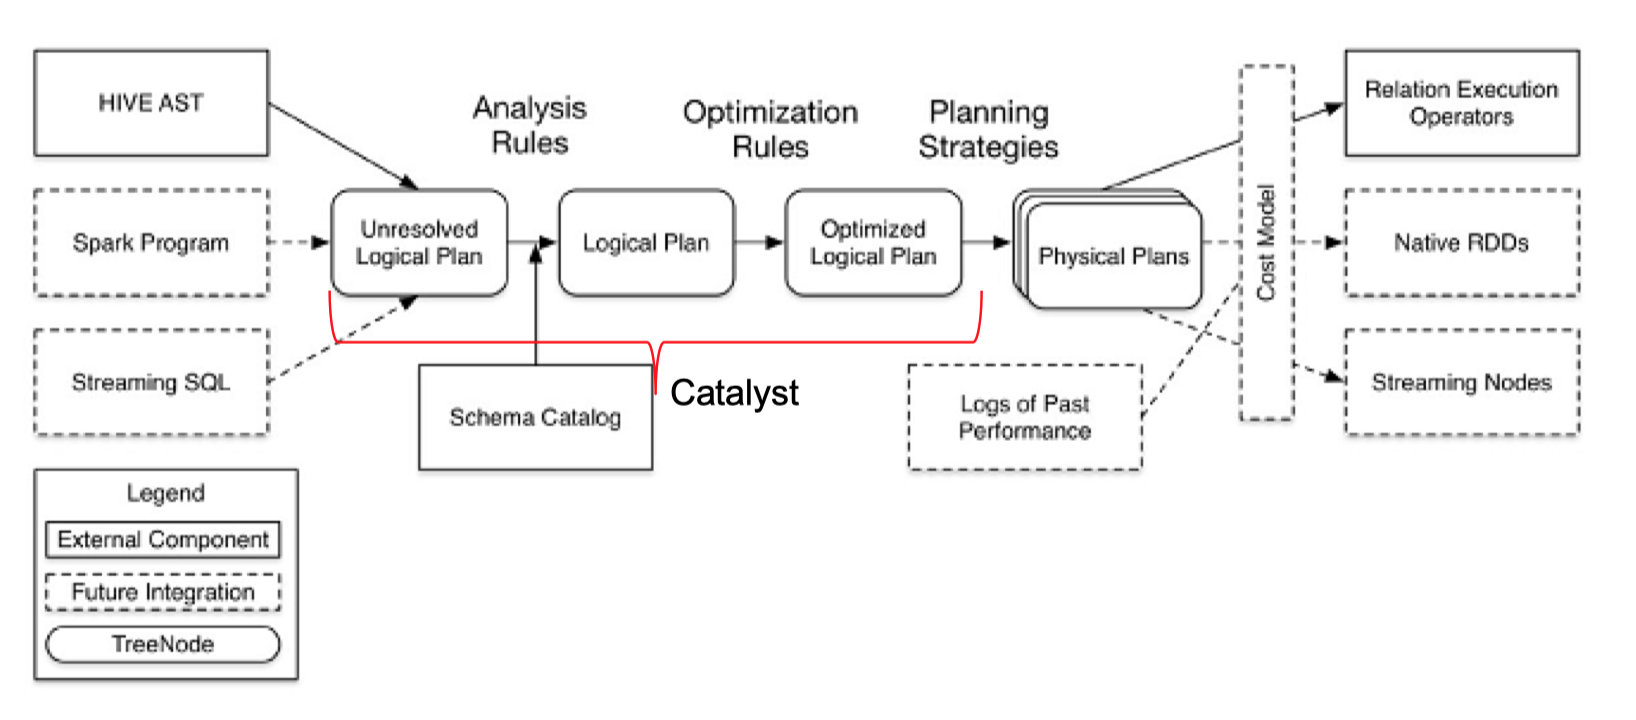
SQL语句首先通过Parser模块被解析为语法树,此棵树称为Unresolved Logical Plan;Unresolved Logical Plan通过Analyzer模块借助于Catalog中的表信息解析为Logical Plan;此时,Optimizer再通过各种基于规则的优化策略进行深入优化,得到Optimized Logical Plan;优化后的逻辑执行计划依然是逻辑的,并不能被Spark系统理解,此时需要将此逻辑执行计划转换为Physical Plan。
Spark常见的优化策略有下面几类:
- Combine Limits:合并Limit,就是将两个相邻的limit合为一个。
- Constant Folding:常量叠加
- NullPropagation:空格处理
- BooleanSimplification:布尔表达式简化
- ConstantFolding:常量叠加
- SimplifyFilters:Filter简化
- LikeSimplification:like表达式简化。
- SimplifyCasts:Cast简化
- SimplifyCaseConversionExpressions:CASE大小写转化表达式简化
- Filter Pushdown Filter下推
- CombineFilters Filter合并
- PushPredicateThroughProject:通过Project下推
- PushPredicateThroughJoin:通过Join下推
- ColumnPruning:列剪枝
搜索『后端精进之路』并关注,立刻获取文章合集和面试攻略,还有价值数千元的面试大礼包等你拿。
Spark系列 - (3) Spark SQL的更多相关文章
- Spark系列—01 Spark集群的安装
一.概述 关于Spark是什么.为什么学习Spark等等,在这就不说了,直接看这个:http://spark.apache.org, 我就直接说一下Spark的一些优势: 1.快 与Hadoop的Ma ...
- Spark系列—02 Spark程序牛刀小试
一.执行第一个Spark程序 1.执行程序 我们执行一下Spark自带的一个例子,利用蒙特·卡罗算法求PI: 启动Spark集群后,可以在集群的任何一台机器上执行一下命令: /home/spark/s ...
- Spark SQL概念学习系列之Spark SQL的简介(一)
Spark SQL提供在大数据上的SQL查询功能,类似于Shark在整个生态系统的角色,它们可以统称为SQL on Spark. 之前,Shark的查询编译和优化器依赖于Hive,使得Shark不得不 ...
- Spark SQL概念学习系列之Spark SQL概述
很多人一个误区,Spark SQL重点不是在SQL啊,而是在结构化数据处理! Spark SQL结构化数据处理 概要: 01 Spark SQL概述 02 Spark SQL基本原理 03 Spark ...
- Spark入门实战系列--1.Spark及其生态圈简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .简介 1.1 Spark简介 年6月进入Apache成为孵化项目,8个月后成为Apache ...
- Spark系列-SparkSQL实战
Spark系列-初体验(数据准备篇) Spark系列-核心概念 Spark系列-SparkSQL 之前系统的计算大部分都是基于Kettle + Hive的方式,但是因为最近数据暴涨,很多Job的执行时 ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
- Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark Streaming简介 1.1 概述 Spark Streaming 是Spa ...
- Spark入门实战系列--8.Spark MLlib(上)--机器学习及SparkMLlib简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .机器学习概念 1.1 机器学习的定义 在维基百科上对机器学习提出以下几种定义: l“机器学 ...
- Spark系列之二——一个高效的分布式计算系统
1.什么是Spark? Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有H ...
随机推荐
- Mybatis SQL 对应Oracle中javaType和jdbcType对应
<resultMap type="java.util.Map" id="resultjcm"> <result property=" ...
- SpringCloud Alibaba(六) - Seata 分布式事务锁
1.Seata 简介 1.1 Seata是什么 Seata 是一款开源的分布式事务解决方案,致力于提供高性能和简单易用的分布式事务服务.Seata 将为用户提供了 AT.TCC.SAGA 和 XA 事 ...
- 记录一次 MyBatis 批量插入的优化-BatchInsert
记录在一次项目问题排查过程中,遇到在数据量大的情况下,向数据库批量插入非常耗时长的问题. 1.分析 首先,代码是在 service 中,采用的是 for 循环调用 insert 语句的方式: for( ...
- 跟我学Python图像处理丨带你入门OpenGL
摘要:介绍Python和OpenGL的入门知识,包括安装.语法.基本图形绘制等. 本文分享自华为云社区<[Python图像处理] 二十七.OpenGL入门及绘制基本图形(一)>,作者:ea ...
- VSCode解决Python中空格和制表符混用报错
Python对缩进的要求非常严格,缩进控制不正确可能会造成代码执行不正确甚至报错. 遇到报错"TabError: inconsistent use of tabs and spaces in ...
- STM32与PS2的无线通信和相关函数介绍
PS2采用SPI通信协议 源码和参考文件获取:https://github.com/Sound-Sleep/PS2_Based_On_STM32 接收器接口 DI:手柄->主机,时钟的下降沿传送 ...
- 基于 Traefik 的激进 TLS 安全配置实践
前言 Traefik是一个现代的HTTP反向代理和负载均衡器,使部署微服务变得容易. Traefik可以与现有的多种基础设施组件(Docker.Swarm模式.Kubernetes.Marathon. ...
- ASP.NET Core RESTful学习理解
一.了解什么是REST REST是"REpresentational State Transfer"的缩写 ,表述性状态传递: REST是一种软件架构风格,用于构造简单.可靠.高性 ...
- JS基础简介
JS基础简介 一.JS简介 JavaScript(简称'js')是一种具有函数优先的轻量级.解释型或及时编译型的编程语言.虽然它是作为开发web页面的脚本语言而出名,但是它也被用到了很多的非浏览器环境 ...
- 反射_Class对象功能概述-反射_Class对象功能_获取Field
反射_Class对象功能概述 * Class对象功能: * 获取功能: 1. 获取成员变量们 * Field[] getFields() :获取所有public修饰的成员变量 * Field getF ...