
Spark SQL概念学习系列之Spark SQL概述
很多人一个误区,Spark SQL重点不是在SQL啊,而是在结构化数据处理!
Spark SQL结构化数据处理
概要:
01 Spark SQL概述
02 Spark SQL基本原理
03 Spark SQL编程
04 分布式SQL引擎
05 用户自定义函数
06 性能调优
Spark SQL概述
Spark SQL是什么?
Spark SQL is a Spark module for structured data processing
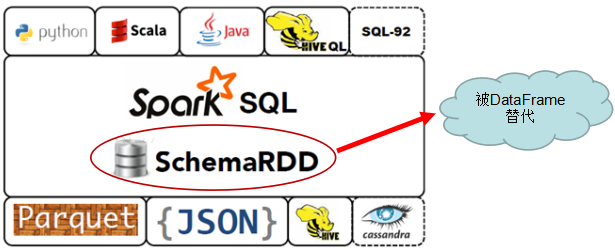
特别注意:.3.0 及后续版本中,SchemaRDD 已经被DataFrame 所取代。所以,我们以后的重点是DataFrame,各位博友们!
何为结构化数据
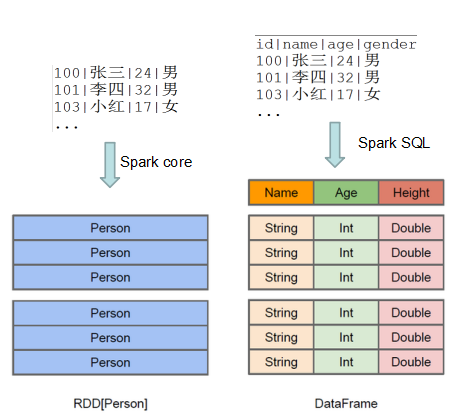
SparkSQL 与 Spark Core的关系
Spark SQL构建在Spark Core之上,专门用来处理结构化数据(不仅仅是SQL)。
Spark SQL在Spark Core的基础上针对结构化数据处理进行很多优化和改进,
简单来讲:
Spark SQL 支持很多种结构化数据源,可以让你跳过复杂的读取过程,轻松从各种数据源中读取数据
当你使用SQL查询这些数据源中的数据并且只用到了一部分字段时,SparkSQL可以智能地只扫描这些用到的字段,而不是像SparkContext.hadoopFile中那样简单粗暴地扫描全部数据.
Spark SQL前世今生:由Shark发展而来
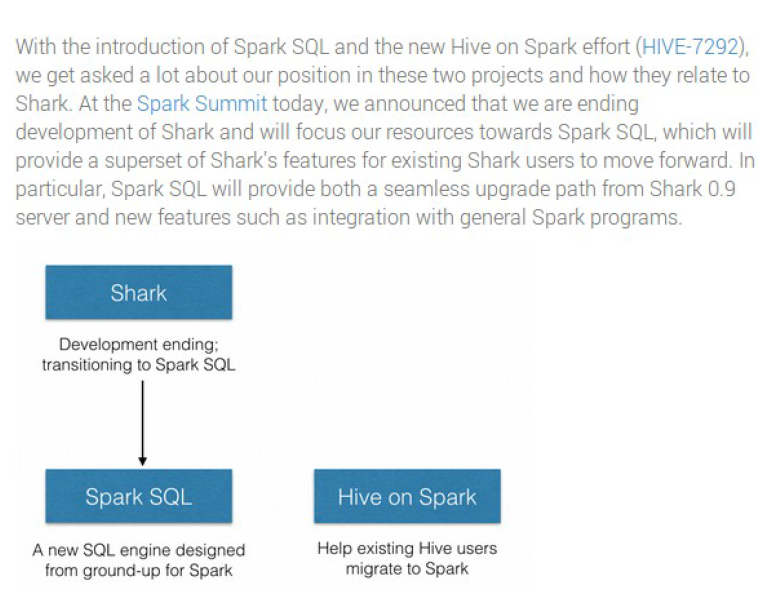
Spark SQL前世今生:可以追溯到Hive
由facebook 开源, 最初用于解决海量结构化的日志数据统计问题的ETL(Extraction-Transformation-Loading) 工具
构建在Hadoop上的数据仓库平台,设计目标是使得可以用传统SQL操作Hadoop上的数据,让熟悉SQL编程的人员也能拥抱Hadoop。
1.使用HQL 作为查询接口
2.使用HDFS 作为底层存储
3.使用MapRed 作为执行层
现已成为Hadoop平台上的标配。
曾在一段时间之内成为SQL on Hadoop的唯一选择!
http://hive.apache.org/

https://cwiki.apache.org/confluence/display/Hive/Home

https://cwiki.apache.org/confluence/display/Hive/LanguageManual
Spark SQL前世今生:Hive 到 Shark(在Hive上做改进)
背景:Spark出现之后,社区开始考虑基于Spark提供SQL解决方案,这就是诞生的背景
基于Hive的代码库,修改了Hive的后端引擎使其运行在Spark上(在Hive上做改进)。
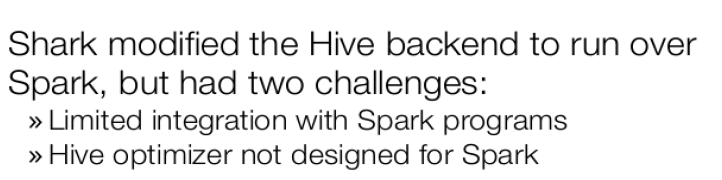
导致社区放弃Shark的主要原因:
和Spark程序的集成有诸多限制
Hive的优化器不是为Spark而设计的,计算模型的不同,使得Hive的优化器来优化Spark程序遇到了瓶颈。
Spark SQL前世今生:Shark 到 Spark SQL(彻底摆脱但是兼容Hive)
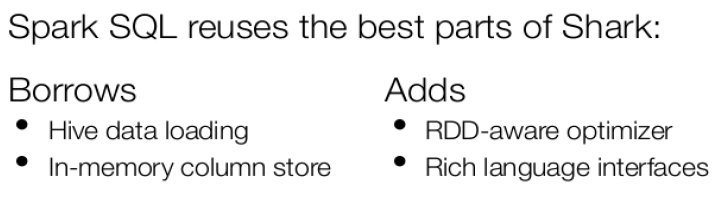
Spark SQL前世今生:Hive 到 Hive on Spark
Spark SQL诞生的同时,Hive还在继续发展,一些深耕Hive的用户意识到迁移还是需要成本的,于是Hive社区提出了Hive on Spark的计划
从Hive 1.1+开始可用,还在发展过程中
Spark SQL前世今生

Spark SQL概念学习系列之Spark SQL概述的更多相关文章
- Spark SQL概念学习系列之Spark SQL 架构分析(四)
Spark SQL 与传统 DBMS 的查询优化器 + 执行器的架构较为类似,只不过其执行器是在分布式环境中实现,并采用的 Spark 作为执行引擎. Spark SQL 的查询优化是Catalyst ...
- Spark SQL概念学习系列之分布式SQL引擎
不多说,直接上干货! parkSQL作为分布式查询引擎:两种方式 除了在Spark程序里使用Spark SQL,我们也可以把Spark SQL当作一个分布式查询引擎来使用,有以下两种使用方式: 1.T ...
- Spark RDD概念学习系列之Spark Hash Shuffle内幕彻底解密(二十)
本博文的主要内容: 1.Hash Shuffle彻底解密 2.Shuffle Pluggable解密 3.Sorted Shuffle解密 4.Shuffle性能优化 一:到底什么是Shuffle? ...
- Spark SQL概念学习系列之Spark SQL的简介(一)
Spark SQL提供在大数据上的SQL查询功能,类似于Shark在整个生态系统的角色,它们可以统称为SQL on Spark. 之前,Shark的查询编译和优化器依赖于Hive,使得Shark不得不 ...
- Spark SQL概念学习系列之Spark SQL 优化策略(五)
查询优化是传统数据库中最为重要的一环,这项技术在传统数据库中已经很成熟.除了查询优化, Spark SQL 在存储上也进行了优化,从以下几点查看 Spark SQL 的一些优化策略. (1)内存列式存 ...
- Spark SQL概念学习系列之Spark SQL入门
前言 第1章 为什么Spark SQL? 第2章 Spark SQL运行架构 第3章 Spark SQL组件之解析 第4章 深入了解Spark SQL运行计划 第5章 测试环境之搭建 第6章 ...
- Spark SQL概念学习系列之Spark SQL入门(八)
前言 第1章 为什么Spark SQL? 第2章 Spark SQL运行架构 第3章 Spark SQL组件之解析 第4章 深入了解Spark SQL运行计划 第5章 测试环境之搭建 第6章 ...
- Spark SQL概念学习系列之Spark SQL基本原理
Spark SQL基本原理 1.Spark SQL模块划分 2.Spark SQL架构--catalyst设计图 3.Spark SQL运行架构 4.Hive兼容性 1.Spark SQL模块划分 S ...
- Spark SQL概念学习系列之Spark生态之Spark SQL(七)
具体,见
随机推荐
- NOIp2018之前打模板出现的问题汇总
灵感来源是因为调试了一下午dij,就想把错误记下来 dij:结构体里的重载运算符不会写 结构体声明后要加引号 用于排序的结构体按照边长度排序 匈牙利:在dfs中的if语句中,要继续搜 ...
- HD-ACM算法专攻系列(17)——find your present (2)
题目描述: 源码: #include"iostream" #include"string" using namespace std; bool IsFirstH ...
- .net 三大核心对象
.net 三大核心对象 HttpRequest 现在总算轮到第一个核心对象出场了.MSDN给它作了一个简短的解释:“使 ASP.NET 能够读取客户端在 Web 请求期间发送的 HTTP 值.”这个解 ...
- CommandType.Text
CommandType.Text代表执行的是SQL语句CommandType.StoreProcedure代表执行的是存储过程CommandType代表要执行的类型 //返回DataTable的SQL ...
- mysql面试几个问题
1.为什么InnoDB表最好要有自增列做主键? InnoDB引擎表是基于B+树的索引组织表(IOT) 关于B+树 (图片来源于网上) B+ 树的特点: a.所有关键字都出现在叶子结点的链表中(稠密索引 ...
- C++中static和const关键字的作用
static关键字至少有下列几个作用: 函数体内static变量的作用范围为该函数体,不同于auto变量,该变量的内存只被分配一次,因此其值在下次调用时仍维持上次的值: 在模块内的static全局变量 ...
- javascript: 基于原型的面向对象编程
Douglas Crockford指出javascript是世界上最被误解的编程语言.由于javascript缺少常见的面向对象概念,许多程序猿认为javascript不是一个合适的语言.我在做第一个 ...
- udev的规则文件
转载于:https://linux.cn/article-9365-1.html 介绍 在 GNU/Linux 系统中,虽然设备的底层支持是在内核层面处理的,但是,它们相关的事件管理是在用户空间中通过 ...
- Codeforces div2 #499 B. Planning The Expedition 大水题
已经是水到一定程度了QAQ- Code: #include<cstdio> #include<algorithm> #include<cstring> using ...
- css——权重叠加
权重叠加 在下面的一段代码中,第一个样式body b有两个标签,第二个有一个标签b.两个中都有color,会应用哪一个呢?果是 那下面的代码会显示什么样的结果 结果是 应用的事body b中的colo ...