
ElasticSearch 实现分词全文检索 - 概述
需求
做一个类似百度的全文搜索功能

所用的技术如下:
- ElasticSearch
- Kibana 管理界面
- IK Analysis 分词器
- SpringBoot
ElasticSearch 简介
ES 是一个使用Java语言并且基于Lucene编写的搜索引擎框架,他提供了分布式的全文搜索功能,提供了一个统一的基于Restful风格的WEB接口,官方客户端也对多种语言都提供了相应的API。
Lucene:Lucene本身就是一个搜索引擎的底层
分布式:ES主要是为了突出他的横向扩展能力。
全文检索:将一段词语进行分词,并且将分出来的单个词语统一放到一个分词库中,在搜索时,根据关键字去分词库中检查,找到匹配的内容。(倒排索引)
Restful 风格的WEB接口:操作ES很简单,只需要发送一个HTTP请求,并且根据请求方式的不同,携带参数,执行相应的功能。
应用广泛:Github, wiki, gold man 用ES每天维护将近10TB的数据。
ES 结构

索引
ES的服务中,可以创建多个索引,每个索引默认被分成5个分片存储(提高查询效率、存储容量),每个分片至少有一个备份分片
备份分片默认不会分担查询效率,当ES检索压力特别大的时候,备份分片才会帮助检索数据
备份的分片必须放在不同的服务器中(集群)

类型
索引可以分多个分版 ,每个分片中有多个type,ES版本不同,类型的创建也不同
7.x 默认不再支持自定投索引类型(默认类型为_doc)

文档
一个type又可以分多个 document 文档 (一个个文档,相当于RDB中的一行行数据),每个文档中有多个field属性
一个MySQL有多个数据库,一个库中有多个表,一张表中存放着多行数据,每行数据中分多个列

列
一个文档包括多个属性,相当于RDB中的字段

ES和Slor
Slor 在查询死数据时(不能改变的数据,不增加、不减少),速度相对ES更快一些。但是数据如果是实时改变时,Solr的查询速度会降低很多,ES的查询效率基本没有变化。
Solr搭建集群时,需要依赖Zookeeper来帮助管理。ES本身就支持集群的搭建,不需要第三方的介入
Solr针对国内的中文文档不多,ES社区火爆,文档健全
ES 对现在云计算和大数据支持特别好
倒排索引
将存放的数据,以一定的方式进行分词,并且将分词的内容存放到一个单独的分词库中。
当用户去查询数据时,会将用户的查询关键字进行分词
然后去分词库中匹配内容,最终得到数据的ID标识
根据ID标识去存放数据的位置拉取到指定的数据
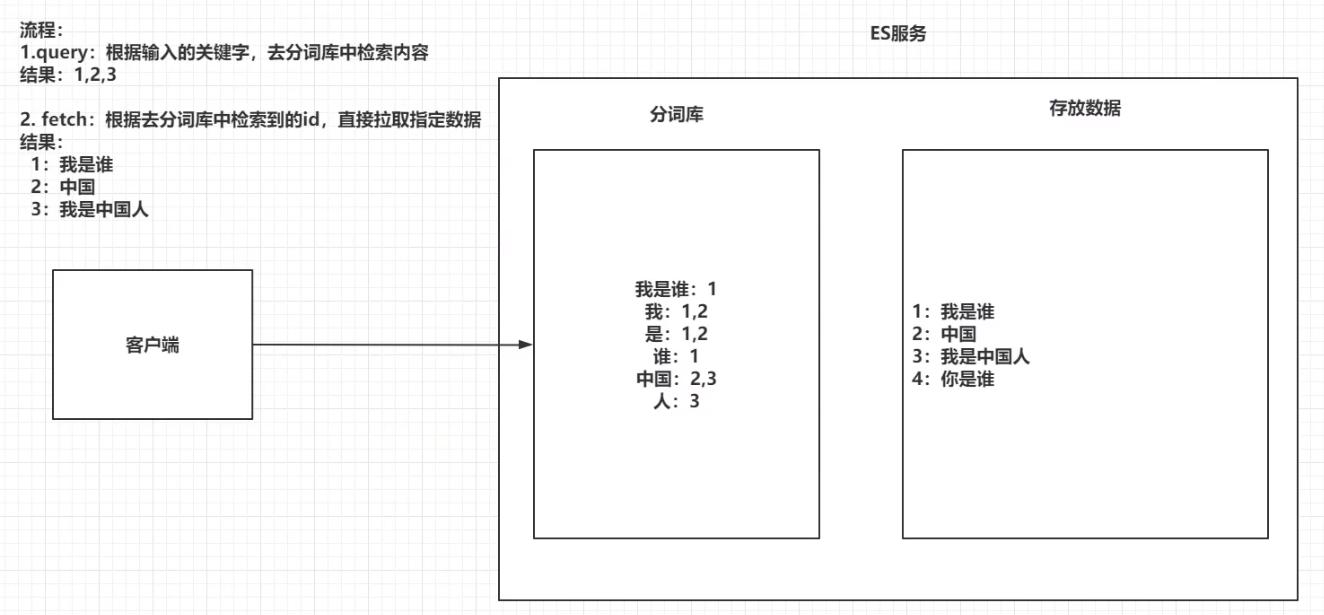
全文检索流程

- 创建ES索引、设置需要分词查询的 field
- 可以通过 canal 对 MySQL binlog 进行数据同步,或者 flink 或者 SpringBoot 直接往ES里添加数据
- 根据业务需求,通过 SpringBoot 进行查询
ElasticSearch 实现分词全文检索 - 概述的更多相关文章
- PHP+mysql数据库开发搜索功能:中英文分词+全文检索(MySQL全文检索+中文分词(SCWS))
PHP+mysql数据库开发类似百度的搜索功能:中英文分词+全文检索 中文分词: a) robbe PHP中文分词扩展: http://www.boyunjian.com/v/softd/robb ...
- ElasticSearch中文分词(IK)
ElasticSearch常用的很受欢迎的是IK,这里稍微介绍下安装过程及测试过程. 1.ElasticSearch官方分词 自带的中文分词器很弱,可以体检下: [zsz@VS-zsz ~]$ c ...
- 实战ELK(8) 安装ElasticSearch中文分词器
安装 方法1 - download pre-build package from here: https://github.com/medcl/elasticsearch-analysis-ik/re ...
- Elasticsearch 中文分词(elasticsearch-analysis-ik) 安装
由于elasticsearch基于lucene,所以天然地就多了许多lucene上的中文分词的支持,比如 IK, Paoding, MMSEG4J等lucene中文分词原理上都能在elasticsea ...
- Elasticsearch之分词器的作用
前提 什么是倒排索引? Analyzer(分词器)的作用是把一段文本中的词按一定规则进行切分.对应的是Analyzer类,这是一个抽象类,切分词的具体规则是由子类实现的,所以对于不同的语言,要用不同的 ...
- Elasticsearch之分词器的工作流程
前提 什么是倒排索引? Elasticsearch之分词器的作用 Elasticsearch的分词器的一般工作流程: 1.切分关键词 2.去除停用词 3.对于英文单词,把所有字母转为小写(搜索时不区分 ...
- elasticsearch 拼音+ik分词,spring data elasticsearch 拼音分词
elasticsearch 自定义分词器 安装拼音分词器.ik分词器 拼音分词器: https://github.com/medcl/elasticsearch-analysis-pinyin/rel ...
- elasticsearch 中文分词(elasticsearch-analysis-ik)安装
elasticsearch 中文分词(elasticsearch-analysis-ik)安装 下载最新的发布版本 https://github.com/medcl/elasticsearch-ana ...
- elasticsearch kibana + 分词器安装详细步骤
elasticsearch kibana + 分词器安装详细步骤 一.准备环境 系统:Centos7 JDK安装包:jdk-8u191-linux-x64.tar.gz ES安装包:elasticse ...
- Elasticsearch修改分词器以及自定义分词器
Elasticsearch修改分词器以及自定义分词器 参考博客:https://blog.csdn.net/shuimofengyang/article/details/88973597
随机推荐
- 1.5 HDFS分布式文件系统-hadoop-最全最完整的保姆级的java大数据学习资料
目录 1.5 HDFS分布式文件系统 1.5.1 HDFS 简介 1.5.2 HDFS的重要概念 1.5.3 HDFS架构 1.5 HDFS分布式文件系统 1.5.1 HDFS 简介 HDFS(全称: ...
- <三>function函数对象类型的应用示例
std::function是一组函数对象包装类的模板,实现了一个泛型的回调机制.function与函数指针比较相似,优点在于它允许用户在目标的实现上拥有更大的弹性,即目标既可以是普通函数,也可以是函数 ...
- Spring面试点汇总
Spring面试点汇总 我们会在这里介绍我所涉及到的Spring相关的面试点内容,本篇内容持续更新 我们会介绍下述Spring的相关面试点: Spring refresh Spring bean Sp ...
- ob-myfreemp3
网站 aHR0cDovL3Rvb2wubGl1bWluZ3llLmNuL211c2ljLw== 打开之后随便搜一个歌手的名字或歌曲(这里搜林俊杰) m/api/search,可以看到数据全在这里 全 ...
- 【转载】WebBrowser控件的常用方法、属性和事件
1. 属性 属性 说明 Application 如果该对象有效,则返回掌管WebBrowser控件的应用程序实现的自动化对象(IDispatch).如果在宿主对象中自动化对象无效,这个程序将返回Web ...
- LeetCode HOT 100:验证二叉搜索树(从左右子树获取信息进行推导)
题目:98. 验证二叉搜索树 题目描述: 给你一个二叉树,让你判断该二叉树是否是二叉搜索树.什么是二叉搜索树呢?就是某一个节点的左子树上的所有节点的值都小于当前节点,右子树上的所有节点值都大于当前节点 ...
- Lombok中@Builder和@SuperBuilder注解的用法
@Builder 是 lombok 中的注解.可以使用builder()构造的Person.PersonBuilder对象进行链式调用,给所有属性依次赋值. Person person1 = Pers ...
- python进阶之路4基本运算符、格式化输出
内容回顾 PEP8规范 代码编写规范及美观 python注释语法 平时养成写注释的习惯 1.警号 2.三个单引号 3.三个双引号 常量与变量 1.变量语法结构 变量名 赋值符合 数据值 2.底层原理 ...
- [LeetCode]对角线遍历
题目 代码 class Solution { public: vector<int> findDiagonalOrder(vector<vector<int>>&a ...
- Collection集合常用功能-Iterator接口介绍
Collection集合常用功能 Collection是所有单列集合的父接口,因此在Collection中定义了单列集合(List和Set)通用的一些方法,这些方法可用于操作所有的单列集合.方法如下︰ ...