
Java操作Hadoop、Map、Reduce合成
原始数据:
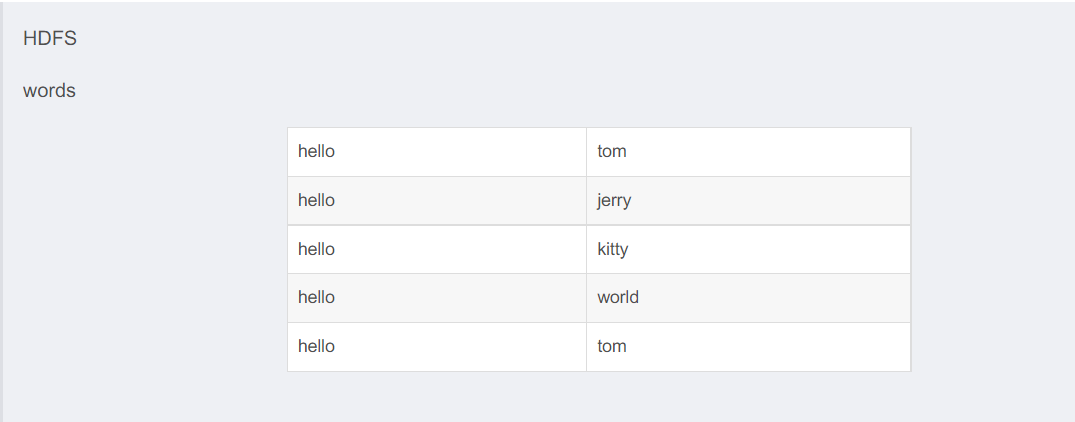
Map阶段
1.每次读一行数据,
2.拆分每行数据,
3.每个单词碰到一次写个1
<0, "hello tom">
<10, "hello jerry">
<22, "hello kitty">
<34, "hello world">
<46, "hello tom">
点击查看代码
/**

 * @ClassName:WordCountReduce

 * @Description:TODO

 * @author:Li Wei Ning

 * @Date:2022/4/28 10:55

 */

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

/**

 * Text  数据类型:字符串类型 String

 * IntWritable reduce阶段的输入类型 int

 * Text reduce阶段的输出数据类型 String类型

 * IntWritable 输出词频个数 Int型

 * @author 暖阳

 */

public class WordCountReduce extends Reducer<Text, IntWritable,Text,IntWritable> {

    /**

     * key 输入的 键

     * value 输入的 值

     * context 上下文对象,用于输出键值对

     */

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context){

        try {

            int sum=0;

            for(IntWritable val:values){

                sum+=val.get();

            }

            context.write(key,new IntWritable(sum));

        }catch (Exception e){

            e.printStackTrace();

        }finally {

            System.out.println("成功!!!");

        }

    }

}
reduce阶段
1.把单词对应的那些1
2遍历
3求和
<hello, {1,1,1,1,1}>
<jerry, {1}>
<kitty, {1}>
<tom, {1,1}>
<world, {1}>
点击查看代码
/**

 * @ClassName:WordCountReduce

 * @Description:TODO

 * @author:Li Wei Ning

 * @Date:2022/4/28 10:55

 */

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

/**

 * Text  数据类型:字符串类型 String

 * IntWritable reduce阶段的输入类型 int

 * Text reduce阶段的输出数据类型 String类型

 * IntWritable 输出词频个数 Int型

 * @author 暖阳

 */

public class WordCountReduce extends Reducer<Text, IntWritable,Text,IntWritable> {

    /**

     * key 输入的 键

     * value 输入的 值

     * context 上下文对象,用于输出键值对

     */

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context){

        try {

            int sum=0;

            for(IntWritable val:values){

                sum+=val.get();

            }

            context.write(key,new IntWritable(sum));

        }catch (Exception e){

            e.printStackTrace();

        }finally {

            System.out.println("成功!!!");

        }

    }

}
整合合并
点击查看代码
import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

/**

 * @ClassName:WordCount

 * @Description:TODO

 * @author:Li Wei Ning

 * @Date:2022/4/28 10:54

 */

public class WordCountTest {

    public static void main(String[] args) {

        try {

            /*定义配置*/

            Configuration config = new Configuration();

            /* config.set("fs.defaultFS", "hdfs://192.168.47.128:9000");*/

            /*定义一个工作任务,用于套接map和reduce两个阶段*/

            Job job = Job.getInstance(config);

            /* 定义工作任务用map*/

            job.setMapperClass(WordCountMap.class);

            /*定义map的输出key*/

            job.setMapOutputKeyClass(Text.class);

            /*定义map的输出value*/

            job.setMapOutputValueClass(IntWritable.class);

            /*定义map的文件路径*/

            Path srcPath = new Path("C:/Users/暖阳/Desktop/123.txt");

            /*定义map的输入文件*/

            FileInputFormat.setInputPaths(job,srcPath);

            /* 定义reduce用哪个类*/

            job.setReducerClass(WordCountReduce.class);

            /*指定reduce的输出key*/

            job.setOutputKeyClass(Text.class);

            /*指定reduce的输出value*/

            job.setOutputValueClass(IntWritable.class);

            /* 定义主类*/

            job.setJarByClass(WordCountTest.class);

            /*定义reduce的输出文件路径*/

            Path outPath = new Path("C:/Users/暖阳/Desktop/WordCountTest");

            /*输出最终结果文件路径*/

            FileOutputFormat.setOutputPath(job, outPath);

            /*提交job并关闭程序*/

            System.exit(job.waitForCompletion(true) ? 0 : 1);

        }catch (Exception e){

            e.printStackTrace();

        }finally {

            System.out.println("最终的");

        }

    }

}
输出结果
hello 5
jerry 1
kitty 1
tom 2
world 1
Java操作Hadoop、Map、Reduce合成的更多相关文章
- Hadoop Map/Reduce教程
原文地址:http://hadoop.apache.org/docs/r1.0.4/cn/mapred_tutorial.html 目的 先决条件 概述 输入与输出 例子:WordCount v1.0 ...
- 一步一步跟我学习hadoop(5)----hadoop Map/Reduce教程(2)
Map/Reduce用户界面 本节为用户採用框架要面对的各个环节提供了具体的描写叙述,旨在与帮助用户对实现.配置和调优进行具体的设置.然而,开发时候还是要相应着API进行相关操作. 首先我们须要了解M ...
- Hadoop Map/Reduce
Hadoop Map/Reduce是一个使用简易的软件框架,基于它写出来的应用程序能够运行在由上千个商用机器组成的大型集群上,并以一种可靠容错的方式并行处理上T级别的数据集.一个Map/Reduce ...
- java 写一个 map reduce 矩阵相乘的案例
1.写一个工具类用来生成 map reduce 实验 所需 input 文件 下面两个是原始文件 matrix1.txt 1 2 -2 0 3 3 4 -3 -2 0 2 3 5 3 -1 2 -4 ...
- Hadoop Map/Reduce的工作流
问题描述 我们的数据分析平台是单一的Map/Reduce过程,由于半年来不断地增加需求,导致了问题已经不是那么地简单,特别是在Reduce阶段,一些大对象会常驻内存.因此越来越顶不住压力了,当前内存问 ...
- Java操作Hadoop集群
mavenhdfsMapReduce 1. 配置maven环境 2. 创建maven项目 2.1 pom.xml 依赖 2.2 单元测试 3. hdfs文件操作 3.1 文件上传和下载 3.2 RPC ...
- Hadoop学习笔记(三):java操作Hadoop
1. 启动hadoop服务. 2. hadoop默认将数据存储带/tmp目录下,如下图: 由于/tmp是linux的临时目录,linux会不定时的对该目录进行清除,因此hadoop可能就会出现意外情况 ...
- Hadoop Map/Reduce 示例程序WordCount
#进入hadoop安装目录 cd /usr/local/hadoop #创建示例文件:input #在里面输入以下内容: #Hello world, Bye world! vim input #在hd ...
- C#、JAVA操作Hadoop(HDFS、Map/Reduce)真实过程概述。组件、源码下载。无法解决:Response status code does not indicate success: 500。
一.Hadoop环境配置概述 三台虚拟机,操作系统为:Ubuntu 16.04. Hadoop版本:2.7.2 NameNode:192.168.72.132 DataNode:192.168.72. ...
随机推荐
- Java 进程和线程
进程和线程 在并发编程中,有两个基本的执行单元:进程和线程.在Java编程语言中,通常并发编程主要与线程有关.但是进程也很重要. 计算机系统通常具有许多活动的进程和线程.即使在只有一个执行核心,因此在 ...
- MariaDB CAST语法
Syntax CAST(expr AS type) Description CAST()函数采用一种类型的值,并产生另一种类型的值,类似于CONVERT函数. CAST()和CONVERT()之间的主 ...
- Jpa 在CriteriaBuilder中添加where条件NotIn子查询
final CriteriaBuilder cb = entityManager.getCriteriaBuilder(); final CriteriaQuery<Person> cq ...
- 什么是持续集成(CI)?
持续集成(CI)是每次团队成员提交版本控制更改时自动构建和测试代码的过程. 这鼓励开发人员通过在每个小任务完成后将更改合并到共享版本控制存储库来共 享代码和单元测试.
- 从零开始开发一款H5小游戏(三) 攻守阵营,赋予粒子新的生命
本系列文章对应游戏代码已开源 Sinuous game. 每个游戏都会包含场景和角色.要实现一个游戏角色,就要清楚角色在场景中的位置,以及它的运动规律,并能通过数学表达式表现出来. 场景坐标 canv ...
- 深入理解ES6之《扩展对象》
属性初始值的简写 当对象字面量只有一个属性的名称时,JS引擎会在可访问作用域中查找其同名变量:如果找到则该变量的值被赋给对象字面量里的同名属性 function createPerson(name, ...
- ps基础总结
1.复制图层:首先选中移动工具(V),鼠标右键选中需要复制的图层(快捷方式:上面勾选自动选择),接着一只手按住Alt键,另一只手点击鼠标左键(不松开),往左往右移动即可.若是对多个图层起作用,就可将需 ...
- 人机交互大作业---C#WinForm酒店预订系统(纯界面)
登录: 所有界面: 源代码:最近较忙,后续会上传至github 材料参考:扬中菲尔斯金陵大酒店
- Python读文件并写入数组
直接上代码: # 读文件 def get_venue(file): fname = file # 文件名 # 获取数据长度 len = 0 with open(fname, 'r+', encodin ...
- uniapp中生成二维码(附代码和插件)
wxqrcode.js文件: https://github.com/Clearlovesky/-js-jq-/tree/master/wxqrcode // 引入二维码库 import QR fro ...