
Kafka之概述
Kafka之概述
一、消息队列内部实现原理

(1)点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除)
点对点模型通常是一个基于拉取或者轮询的消息传送模型,这种模型从队列中请求信息,而不是将消息推送到客户端。这个模型的特点是发送到队列的消息被一个且只有一个接收者接收处理,即使有多个消息监听者也是如此。
(2)发布/订阅模式(一对多,数据生产后,推送给所有订阅者)
发布订阅模型则是一个基于推送的消息传送模型。发布订阅模型可以有多种不同的订阅者,临时订阅者只在主动监听主题时才接收消息,而持久订阅者则监听主题的所有消息,即使当前订阅者不可用,处于离线状态。
二、为什么需要消息队列
1)解耦
允许你独立的扩展或修改两边的处理过程,只要确保它们遵守同样的接口约束。
2)冗余
消息队列把数据进行持久化直到它们已经被完全处理,通过这一方式规避了数据丢失风险。许多消息队列所采用的"插入-获取-删除"范式中,在把一个消息从队列中删除之前,需要你的处理系统明确的指出该消息已经被处理完毕,从而确保你的数据被安全的保存直到你使用完毕。
3)扩展性
因为消息队列解耦了你的处理过程,所以增大消息入队和处理的频率是很容易的,只要另外增加处理过程即可。
4)灵活性 & 峰值处理能力
在访问量剧增的情况下,应用仍然需要继续发挥作用,但是这样的突发流量并不常见。如果为以能处理这类峰值访问为标准来投入资源随时待命无疑是巨大的浪费。使用消息队列能够使关键组件顶住突发的访问压力,而不会因为突发的超负荷的请求而完全崩溃。
5)可恢复性
系统的一部分组件失效时,不会影响到整个系统。消息队列降低了进程间的耦合度,所以即使一个处理消息的进程挂掉,加入队列中的消息仍然可以在系统恢复后被处理。
6)顺序保证
在大多使用场景下,数据处理的顺序都很重要。大部分消息队列本来就是排序的,并且能保证数据会按照特定的顺序来处理。(Kafka保证一个Partition内的消息的有序性)
7)缓冲
有助于控制和优化数据流经过系统的速度,解决生产消息和消费消息的处理速度不一致的情况。
8)异步通信
很多时候,用户不想也不需要立即处理消息。消息队列提供了异步处理机制,允许用户把一个消息放入队列,但并不立即处理它。想向队列中放入多少消息就放多少,然后在需要的时候再去处理它们。
三、什么是Kafka
在流式计算中,Kafka一般用来缓存数据,Storm通过消费Kafka的数据进行计算。
1)Apache Kafka是一个开源消息系统,由Scala写成。是由Apache软件基金会开发的一个开源消息系统项目。
2)Kafka最初是由LinkedIn公司开发,并于2011年初开源。2012年10月从Apache Incubator毕业。该项目的目标是为处理实时数据提供一个统一、高通量、低等待的平台。
3)Kafka是一个分布式消息队列。Kafka对消息保存时根据Topic进行归类,发送消息者称为Producer,消息接受者称为Consumer,此外kafka集群有多个kafka实例组成,每个实例(server)称为broker。
4)无论是kafka集群,还是consumer都依赖于zookeeper集群保存一些meta信息,来保证系统可用性。
四、Kafka架构(详细架构图及组件详解)
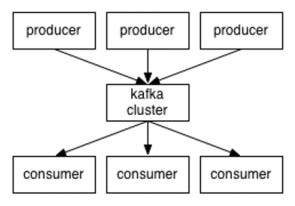
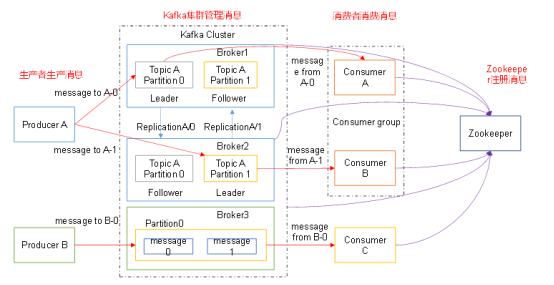
1)Producer :消息生产者,就是向kafka broker发消息的客户端;
2)Consumer :消息消费者,向kafka broker取消息的客户端;
3)Topic :可以理解为一个队列;
4) Consumer Group (CG):这是kafka用来实现一个topic消息的广播(发给所有的consumer)和单播(发给任意一个consumer)的手段。一个topic可以有多个CG。topic的消息会复制(不是真的复制,是概念上的)到所有的CG,但每个partion只会把消息发给该CG中的一个consumer。如果需要实现广播,只要每个consumer有一个独立的CG就可以了。要实现单播只要所有的consumer在同一个CG。用CG还可以将consumer进行自由的分组而不需要多次发送消息到不同的topic;
5)Broker :一台kafka服务器就是一个broker。一个集群由多个broker组成。一个broker可以容纳多个topic;
6)Partition:为了实现扩展性,一个非常大的topic可以分布到多个broker(即服务器)上,一个topic可以分为多个partition,每个partition是一个有序的队列。partition中的每条消息都会被分配一个有序的id(offset)。kafka只保证按一个partition中的顺序将消息发给consumer,不保证一个topic的整体(多个partition间)的顺序;
7)Offset:kafka的存储文件都是按照offset.kafka来命名,用offset做名字的好处是方便查找。例如你想找位于2049的位置,只要找到2048.kafka的文件即可。当然the first offset就是00000000000.kafka。
Kafka之概述的更多相关文章
- kafka模块概述
简介 kafka主要用于实现低延迟的发送和收集大量的事件和日志数据--通常是活跃的数据(PV.访问记录等),数据以日志形式记录下来,然后由一个专门的系统来进行日志的收集与统计: 吞吐量极高的分布式消息 ...
- kafka基本原理概述——patition与replication分配
kafka一直在大数据中承受着数据的压力也扮演着对数据维护转换的角色,下面重点介绍kafka大致组成及其partition副本的分配原则: 文章参考:http://www.linkedkeeper.c ...
- Kafka(1)-概述
一. 内部原理 1. 点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除) 点对点模型通常是一个基于拉取或者轮询的消息传送模型,这种模型从队列中请求信息,而不是将消息推送到客户端.这个模型的特 ...
- Kafka基本原理概述
Kafka的基本介绍 Kafka是最初由Linkedin公司开发,是一个分布式.分区的.多副本的.多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/ngi ...
- 【Kafka】Kafka-副本-分区设置-性能调优
Kafka-副本-分区设置-性能调优 SparkKafkaDemo - Executors kafka replication 负载均衡_百度搜索 Kafka 高性能吞吐揭秘 - 友盟博客 - Seg ...
- Kafka(五)Kafka的API操作和拦截器
一 kafka的API操作 1.1 环境准备 1)在eclipse中创建一个java工程 2)在工程的根目录创建一个lib文件夹 3)解压kafka安装包,将安装包libs目录下的jar包拷贝到工程的 ...
- Kafka实战-Flume到Kafka (转)
原文链接:Kafka实战-Flume到Kafka 1.概述 前面给大家介绍了整个Kafka项目的开发流程,今天给大家分享Kafka如何获取数据源,即Kafka生产数据.下面是今天要分享的目录: 数据来 ...
- 带你涨姿势的认识一下 Kafka
Kafka 基本概述 什么是 Kafka Kafka 是一个分布式流式平台,它有三个关键能力 订阅发布记录流,它类似于企业中的消息队列 或 企业消息传递系统 以容错的方式存储记录流 实时记录流 Kaf ...
- 一次flume exec source采集日志到kafka因为单条日志数据非常大同步失败的踩坑带来的思考
本次遇到的问题描述,日志采集同步时,当单条日志(日志文件中一行日志)超过2M大小,数据无法采集同步到kafka,分析后,共踩到如下几个坑.1.flume采集时,通过shell+EXEC(tail -F ...
随机推荐
- Java--集合框架详解
前言 Java集合框架的知识在Java基础阶段是极其重要的,我平时使用List.Set和Map集合时经常出错,常用方法还记不牢, 于是就编写这篇博客来完整的学习一下Java集合框架的知识,如有遗漏和错 ...
- SDK和API的直接区别
狭义的说法,在实际工作中, 如果对方需要你提供一个api,是指一个工程提供给另外一个工程的接口(一般是基于http协议). 如果对方需要你提供一个sdk,是指基于对方工程的编程语言,提供一个代码包.在 ...
- GreatSQL重磅特性,InnoDB并行并行查询优化测试
欢迎来到 GreatSQL社区分享的MySQL技术文章,如有疑问或想学习的内容,可以在下方评论区留言,看到后会进行解答 GreatSQL社区原创内容未经授权不得随意使用,转载请联系小编并注明来源. 1 ...
- 技术分享 | 在GreatDB分布式部署模式中使用Chaos Mesh做混沌测试
GreatSQL社区原创内容未经授权不得随意使用,转载请联系小编并注明来源. 1. 需求背景与万里安全数据库软件GreatDB分布式部署模式介绍 1.1 需求背景 混沌测试是检测分布式系统不确定性.建 ...
- 大数据管理系统架构Hadoop
Hadoop 起源于Google Lab开发的Google File System (GFS)存储系统和MapReduce数据处理框架.2008年,Hadoop成了Apache上的顶级项目,发展到今天 ...
- 中国联通改造 Apache DolphinScheduler 资源中心,实现计费环境跨集群调用与数据脚本一站式访问
截止2022年,中国联通用户规模达到4.6亿,占据了全中国人口的30%,随着5G的推广普及,运营商IT系统普遍面临着海量用户.海量话单.多样化业务.组网模式等一系列变革的冲击. 当前,联通每天处理话单 ...
- HttpClient 在vivo内销浏览器的高并发实践优化
作者:vivo 互联网服务器团队- Zhi Guangquan HttpClient作为Java程序员最常用的Http工具,其对Http连接的管理能简化开发,并且提升连接重用效率:在正常情况下,Htt ...
- 垃圾收集器 参阅<<深入理解JAVA虚拟机>>
一.新生代 1.Serial收集器 新生代单线程复制算法GC(暂停工作线程)---------- 支持组合老年代Serial odl和CMS 2.ParNew Serial多线程版本 支持组合cms| ...
- python必备基础
1. 基础函数 序号 函数 说明 1 print() 打印 2 input() 输入 3 int() 转化为整形 4 float() 转化为浮点型 5 str() ...
- 使用puppeteer生成pdf与截图
之前写过一篇 vue cli2 使用 wkhtmltopdf 踩坑指南,由于wkhtmltopdf对vue的支持并不友好,而且不支持css3,经过调研最终选择puppeteer,坑少,比较靠谱. 一. ...