
Hadoop优化 操作系统优化
1、优化文件系统,修改/etc/fstab 在defaults后面添加noatime,表示不记录文件的访问时间。

修改为:
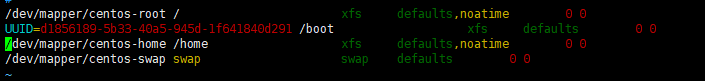
如果不想重新启动操作系统使配置生效,那么应该执行:
# mount -o remount /dev/mapper/centos-root

# mount -o remount /dev/mapper/centos-home
当然,如果有其他的磁盘,同样可以这样操作,我这里测试就两个逻辑卷
2、预读缓冲
预读技术可以有效的减少磁盘寻道次数和应用的I/O等待时间,增加Linux文件系统预读缓冲区的大小(默认为256 sectors,128KB),可以明显提高顺序文件的读性能,建议调整到1024或2048 sectors。预读缓冲区的设置可以通过blockdev命令来完成。
blockdev 工具允许从命令行调用区块设备控制程序,常用参数如下:

  --getra 读取预读值

  --getfra 读取文件系统预读

  --setfra FSREADAHEAD 设置文件系统预读

  --setra READAHEAD 设置设备预读

  --getra 读取设备的预读值

  --setbsz BLOCKSIZE 在文件描述符打开块设备的时候设置块大小

  --getioopt 读取设备优化IO大小

  --getiomin 读取设备最小IO大小

  -–setro 设置设备为只读

  -–getro 读取设备是否为只读(成功为1,0则为可读写)

  -–setrw 设置设别为可读写

  -–getss 打印设备的扇区大小也叫逻辑块大小,通常是512

  --getpbsz 读取设备物理块大小,通常是4096

  --getbsz 读取设备块大小,通常是4096

  -–getsize(-getsz) 打印设备的容量,按照一个扇区512个字节计算

  --getsize64 打印设备的容量,以字节为单位显示

  -–setra N 设置预读扇区(512字节)为N个.Set readahead to N -byte sectors.

  -–getra 打印readahead(预读扇区)

  -–flushbufs 刷新缓冲

  -–rereadpt 重读分区表。
我们可以将默认的预读值(256 sectors,128k)调大,具体的操作如下:
[root@test pam.d]# df -h

Filesystem               Size  Used Avail Use% Mounted on

/dev/mapper/centos-root   60G   14G   47G  % /

devtmpfs                 474M       474M   % /dev

tmpfs                    489M       489M   % /dev/shm

tmpfs                    489M   14M  476M   % /run

tmpfs                    489M       489M   % /sys/fs/cgroup

/dev/sda1                197M  143M   55M  % /boot

/dev/mapper/centos-home   16G   37M   16G   % /home

tmpfs                     98M        98M   % /run/user/

[root@test pam.d]# blockdev --getra /dev/sda1

[root@test pam.d]# blockdev --setra   /dev/sda1

[root@test pam.d]# blockdev --getra /dev/sda1
3、虚拟内存调优:
https://www.cnblogs.com/yinzhengjie/p/9994207.html
4、网卡调优:
https://www.cnblogs.com/yinzhengjie/p/9995756.html
Hadoop优化 操作系统优化的更多相关文章
- Linux操作系统优化
figure:first-child { margin-top: -20px; } #write ol, #write ul { position: relative; } img { max-wid ...
- 实训任务02:Hadoop基础操作
实训任务02:Hadoop基础操作 班级 学号 姓名 实训1:创建测试文件上传HDFS,并显示内容 需求说明: 在本地计算机上创建测试文件helloH ...
- 指导手册03:Hadoop基础操作
指导手册03:Hadoop基础操作 Part 1:查看Hadoop集群的基本信息1.查询存储系统信息(1)在WEB浏览器的地址栏输入http://master:50070/ 请查看自己的Hadoop集 ...
- 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作
马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作 马士兵hadoop第三课:java开发hdfs 马士兵hadoop第 ...
- Hadoop+Hive 操作mongodb数据
Hadoop+Hive 操作mongodb数据 1.版本概述 hadoop-2.7.3.hive-2.2 下载响应的jar包:http://mvnrepository.com/,直接搜索想要的jar包 ...
- Hadoop常用操作
Hadoop常用操作 1.Hadoop安装 略 2.Hadoop配置 略 3.Hadoop多目录配置 namenode和datanode节点下都可以进行多个目录的配置,但是意义不同.namenode的 ...
- 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作(转)
马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作 马士兵hadoop第三课:java开发hdfs 马士兵hadoop第 ...
- Hadoop Shell 操作
此随笔仅记录一下常用的Hadoop shell 操作的命令 参考官方文档 http://hadoop.apache.org/docs/r1.0.4/cn/hdfs_shell.html FS S ...
- 学习笔记:Twitter核心数据类库团队的Hadoop优化经验
一.来源 Streaming Hadoop Performance Optimization at Scale, Lessons Learned at Twitter (Data platform @ ...
随机推荐
- MVC自定定义扩展点之ActionNameSelectorAttribute+ActionFilterAttribute 在浏览器中打开pdf文档
仅仅演示 了ASP.MVC 5 下为了在在浏览器中打开pdf文档的实现方式之一,借此理解下自定义ActionNameSelectorAttribute+ActionFilterAttribute 类的 ...
- C# 泛型集合排序
Student sModel = new Student(); List<Student > list = new List<Student >(); list= list.O ...
- Jquery DataTables 服务器后端分页 Ajax请求添加自定义参数.
项目使用AdminLTE(基于Bootstrap 二次开发的框架)作为开发框架. 使用DataTables 的时候部分页面需要传参 给后台做筛选过滤. 但是不知道怎么将DataTables的参数 和自 ...
- Ajax调用WebService接口样例
在做手机端h5的应用时,通过Ajax调用http接口时没啥问题的:但有些老的接口是用WebService实现的,也来不及改成http的方式,这时通过Ajax调用会有些麻烦,在此记录具体实现过程.本文使 ...
- php批量检测并去除BOM头的代码
开发中会遇到BOM头, 导致程序无法执行. 浏览器返回接口如下图: 去除BOM头解决方法:<?phpini_set('memory_limit','1024M'); function check ...
- 解决在web.xml中配置server服务器启动失败问题
一.问题"Server Tomacat v8.5 Server at locallhost failed to start" 二.解决方法:删除注释@webServlet 三.分析 ...
- MySql数据库操作之数据约束
首先数据库的外键是数据库提供的一种完整性约束.在许多数据库的书上也会介绍到,然而对于外键这个完整性性约束究竟应该在数据库端实现,还是在项目业务端实现很多人有着不同的意见. 个人开发(小型应用).数据库 ...
- Android NDK 学习之接受Java传入的Int数组
本博客主要是在Ubuntu 下开发,且默认你已经安装了Eclipse,Android SDK, Android NDK, CDT插件. 在Eclipse中添加配置NDK,路径如下Eclipse-> ...
- 2019.9.27,SAP成都研究院数字创新空间团队建设,射箭和游泳
2019年9月27日,秋高气爽,SAP成都研究院数字创新团队全体成员又迎来了一次团队建设活动.这次的主题是:射箭. 在正式活动之前,大家先享用了一顿泰式海鲜火锅: 吃饱喝足之后,我们来到了名为&quo ...
- WMware Workstation——网络类型:NAT、bridge、host-only
bridge NAT host-only 总结: NAT和host-only都需要虚拟网卡(WMware Adapter Card)实现物理机和虚拟机互访. NAT和bridge都可以访问外网 NAT ...