
python爬虫(八) requests库之 get请求
requests库比urllib库更加方便,包含了很多功能。
1、在使用之前需要先安装pip,在pycharm中打开:
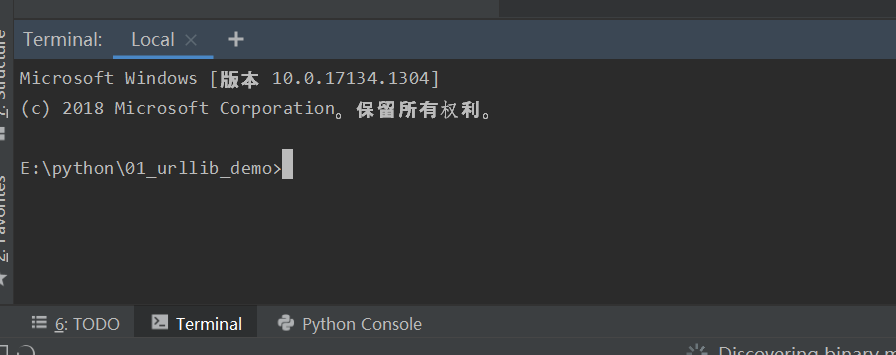
写入pip install requests命令,即可下载
在github中有关于requests库的介绍,网址:https://github.com/requests/requests
2、Get请求
response=requests.get("https://www.baidu.com/")
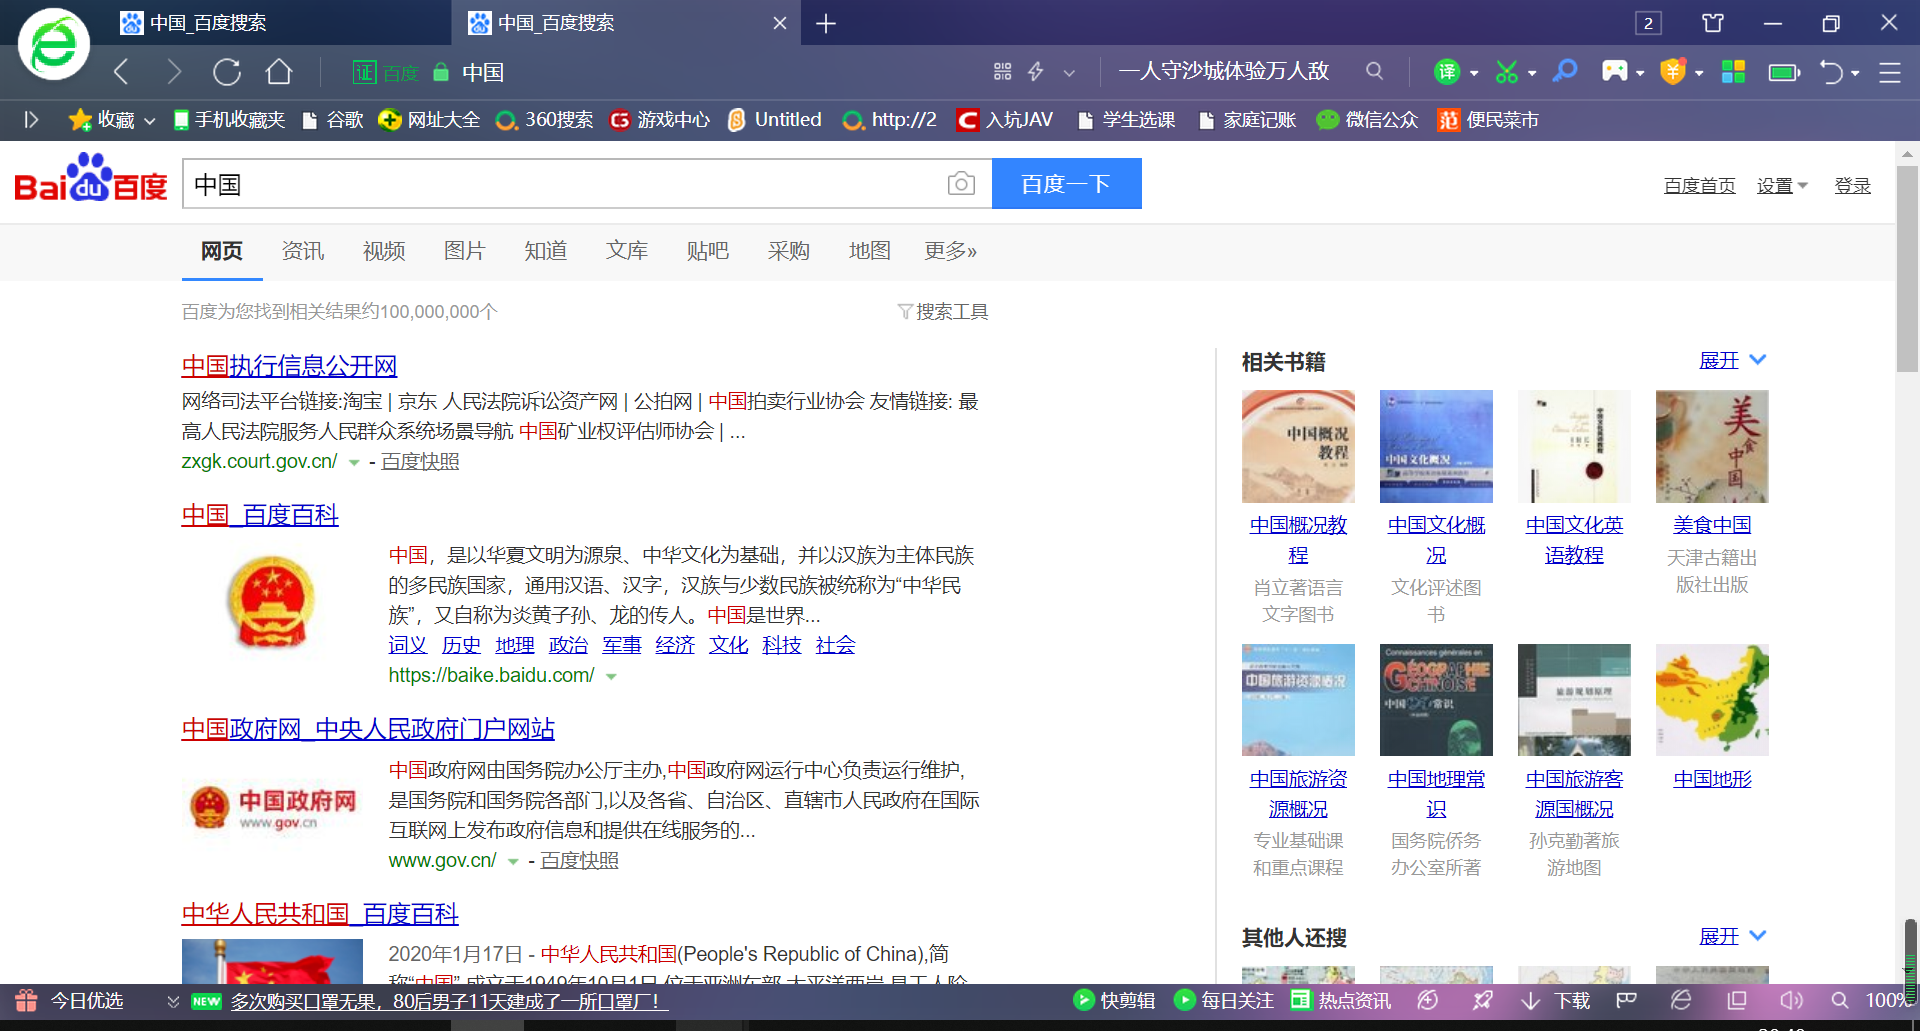
我们要完成在百度的页面获取中国的相关信息,相当于
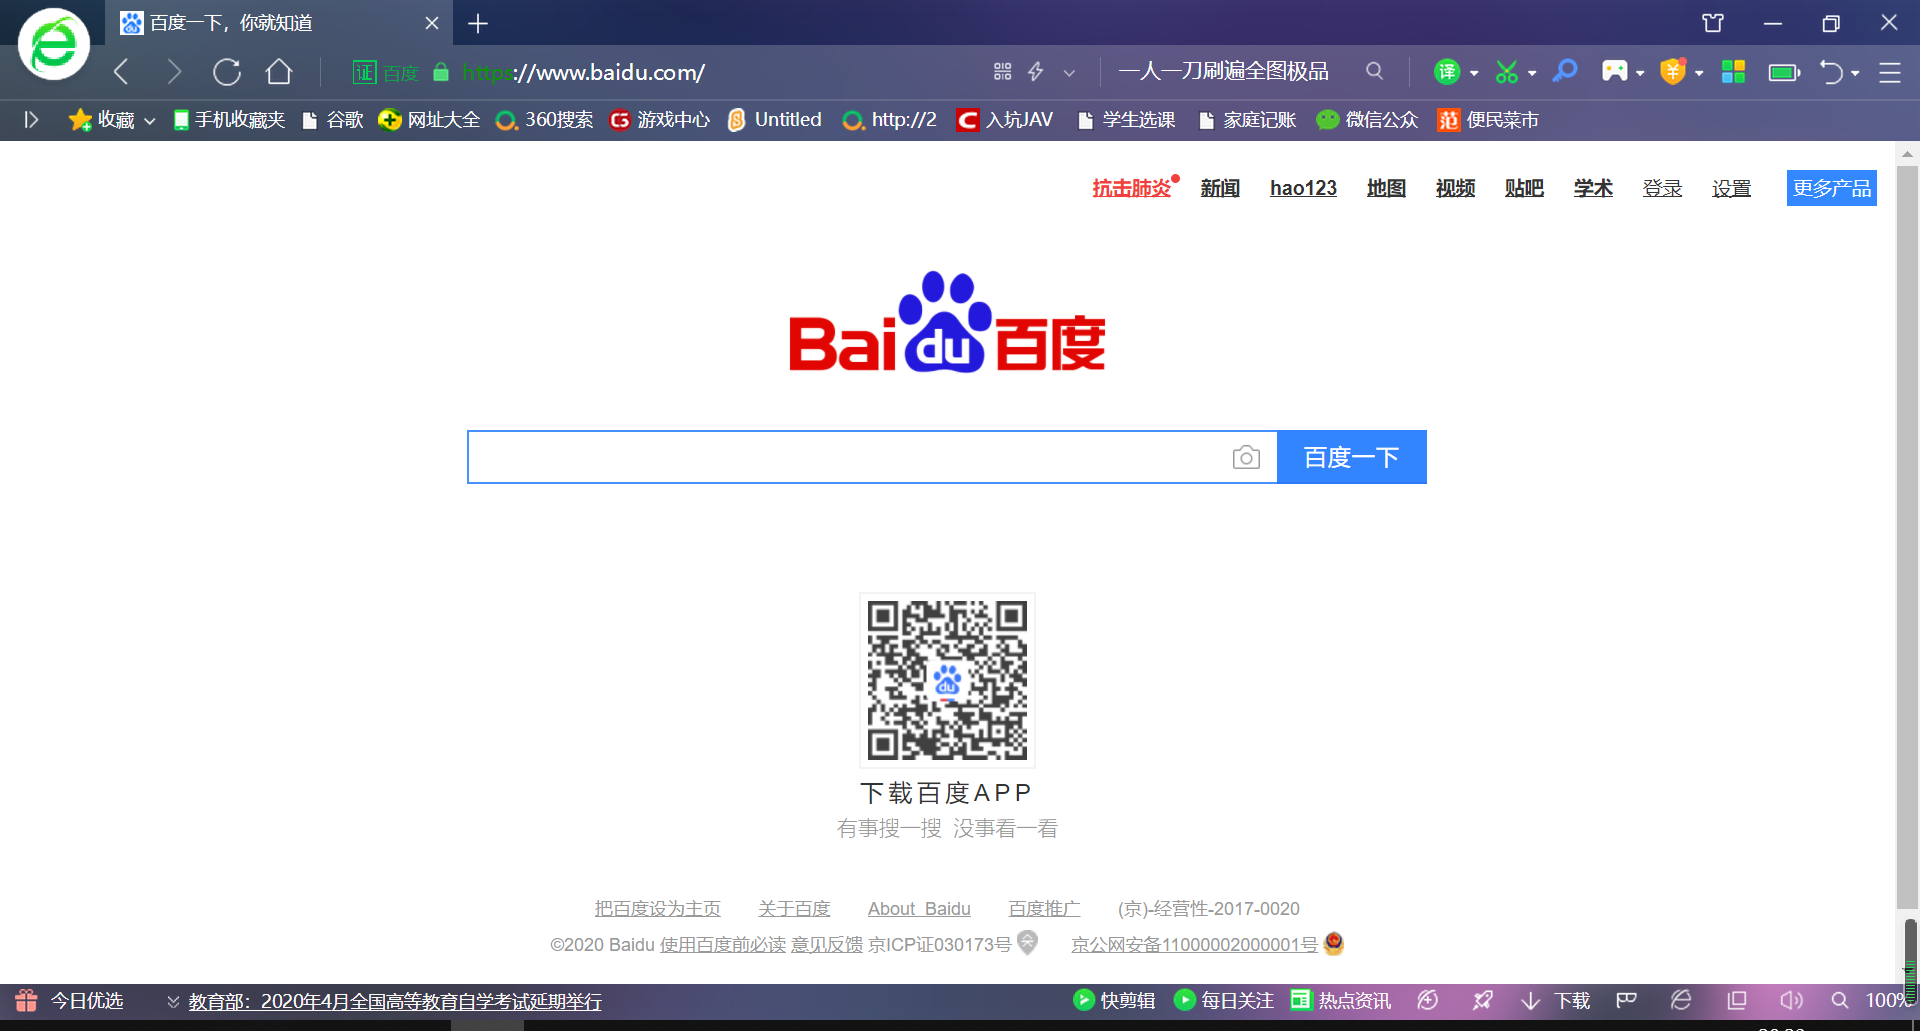
输入中国:
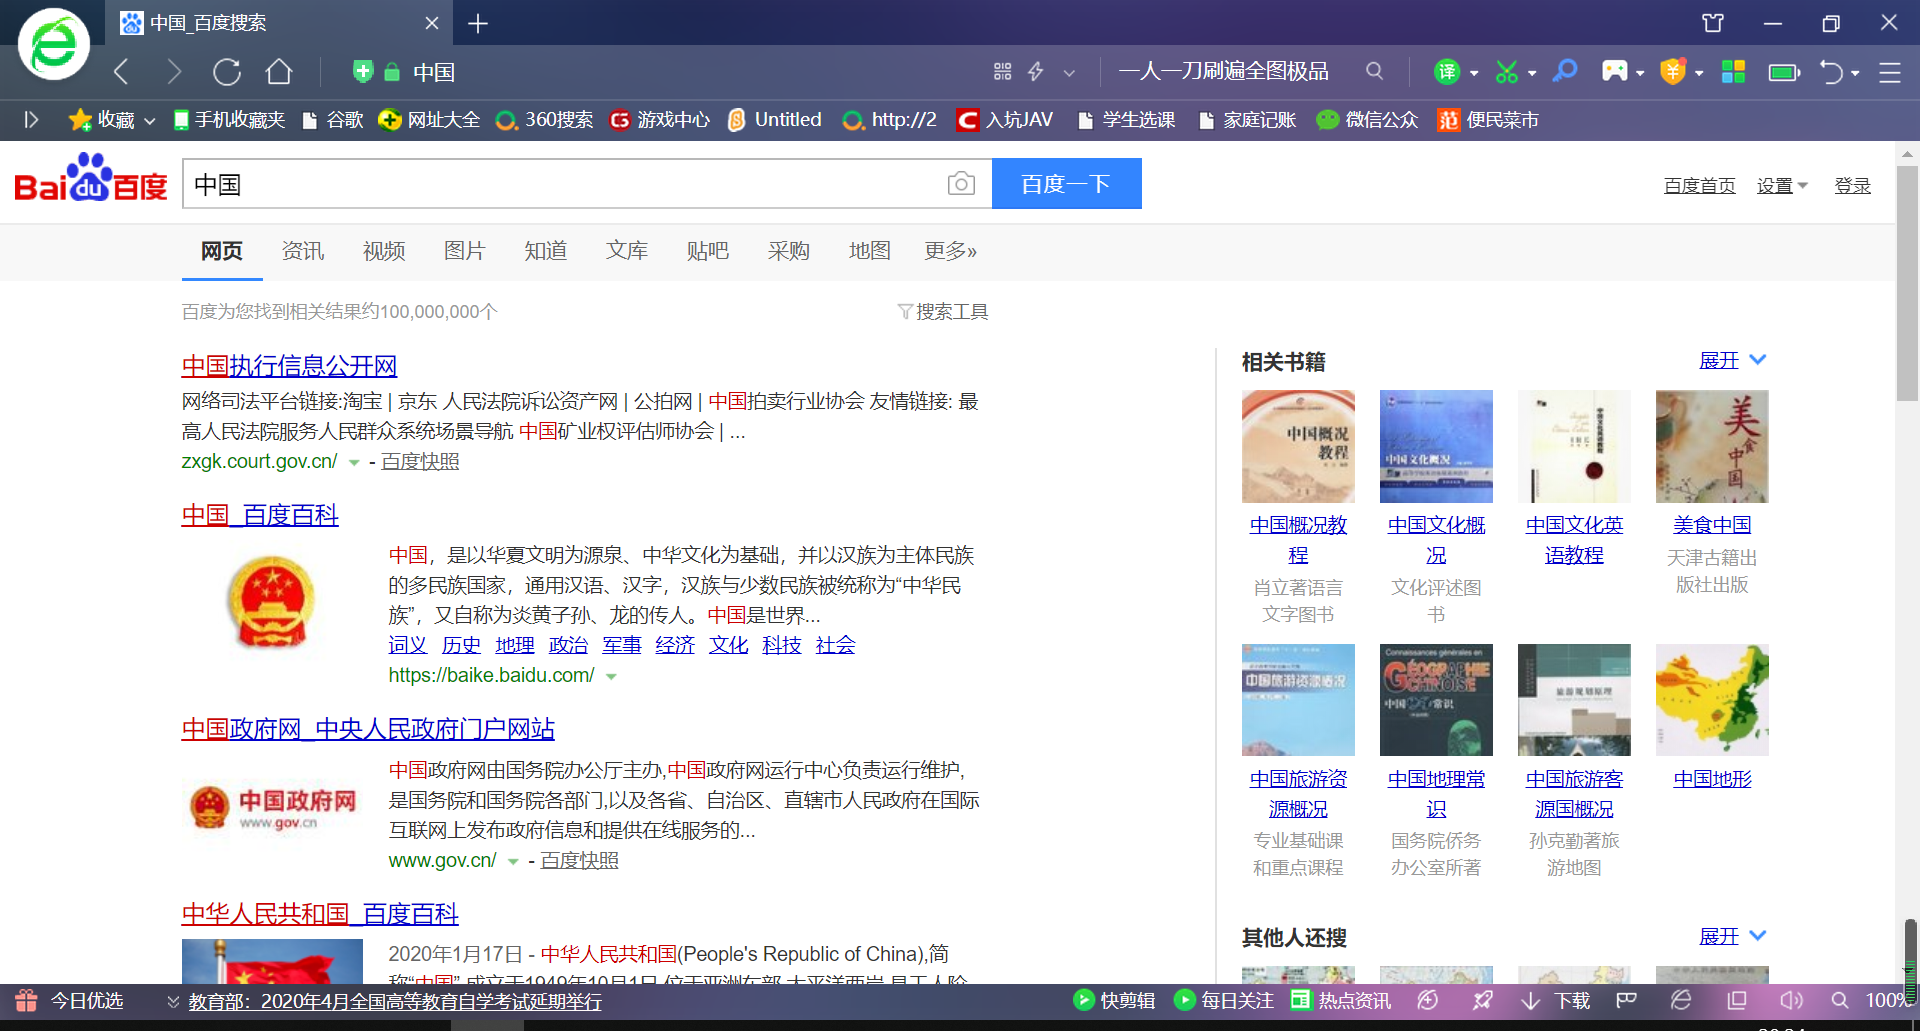
用爬虫代码实验实现:
import requests

# wd是在网址中后面的一段

params={

    'wd':'中国'

}

headers={

    'User-Agent':"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36"

}

# 这时我们要在这个网址中加入S

response=requests.get("http://www.baidu.com/s",params=params,headers=headers)

with open('baidu.html','w',encoding='utf-8') as fp:

    fp.write(response.content.decode('utf-8'))
打开后就是中国的相关信息:
3、response.txt和response.content的区别
response.txt是 requests是经response.content解码的字符串,requests会根据自己的猜测来进行解码,有时候会猜测错误,导致乱码。
response.content是直接从网上爬取的数据,没有经过经过任何解码,是bytes类型。
所以最常用的就是:response.content.decode('utf-8')
python爬虫(八) requests库之 get请求的更多相关文章
- Python爬虫之requests库介绍(一)
一:Requests: 让 HTTP 服务人类 虽然Python的标准库中 urllib2 模块已经包含了平常我们使用的大多数功能,但是它的 API 使用起来让人感觉不太好,而 Requests 自称 ...
- Python爬虫:requests 库详解,cookie操作与实战
原文 第三方库 requests是基于urllib编写的.比urllib库强大,非常适合爬虫的编写. 安装: pip install requests 简单的爬百度首页的例子: response.te ...
- python爬虫之requests库
在python爬虫中,要想获取url的原网页,就要用到众所周知的强大好用的requests库,在2018年python文档年度总结中,requests库使用率排行第一,接下来就开始简单的使用reque ...
- Python爬虫之requests库的使用
requests库 虽然Python的标准库中 urllib模块已经包含了平常我们使用的大多数功能,但是它的 API 使用起来让人感觉不太好,而 Requests宣传是 "HTTP for ...
- 【Python爬虫】Requests库的基本使用
Requests库的基本使用 阅读目录 基本的GET请求 带参数的GET请求 解析Json 获取二进制数据 添加headers 基本的POST请求 response属性 文件上传 获取cookie 会 ...
- python爬虫(1)requests库
在pycharm中安装requests库的一种方法 首先找到设置 搜索然后安装,蓝色代表已经安装 requests库中的get请求 与HTTP协议相对应,requests库也有七种请求方式. 获取ur ...
- python爬虫之requests库介绍(二)
一.requests基于cookie操作 引言:有些时候,我们在使用爬虫程序去爬取一些用户相关信息的数据(爬取张三“人人网”个人主页数据)时,如果使用之前requests模块常规操作时,往往达不到我们 ...
- Python爬虫之Requests库的基本使用
import requests response = requests.get('http://www.baidu.com/') print(type(response)) print(respons ...
- Python爬虫系列-Requests库详解
Requests基于urllib,比urllib更加方便,可以节约我们大量的工作,完全满足HTTP测试需求. 实例引入 import requests response = requests.get( ...
- python 爬虫 基于requests模块的get请求
需求:爬取搜狗首页的页面数据 import requests # 1.指定url url = 'https://www.sogou.com/' # 2.发起get请求:get方法会返回请求成功的响应对 ...
随机推荐
- SpringCloud Netflix Eureka
Eureka是Netflix开源的服务发现组件,基于REST,SpringCloud将它集成在子项目Spring Cloud Netflix中,从而实现服务的注册.发现. Eureka包含Server ...
- 直方图histeq
histeq的原理: [MN]=size(H); [counts,x]=imhist(H);%H是读取的图像,imhist是对图像直方图进行统计,其中count,是每个灰度值得个数,x代表灰度值.一般 ...
- spring 的异步处理
1.先解析几个类的用法 1.1 java.lang.annotation.Annotation @Target(ElementType.FIELD) @Retention(RetentionPoli ...
- varchar(n)
MySQL5.0.3之前varchar(n)这里的n表示字节数MySQL5.0.3之后varchar(n)这里的n表示字符数,比如varchar(200),不管是英文还是中文都可以存放200个根据字符 ...
- VS2015生成代码图
熟悉代码调用流程,可以在调试结束前显示代码图,操作位置: 比如开源的caffe_ocr的代码图:
- [2020BUAA软工助教]第1次个人作业
热身作业(阅读) 一.前言 我认为人生就是一次次地从<存在>到<光明>. 二.软件工程师的成长 博客索引 同学们在上这门课的时候基本都是大三,觉得在大学里,到教室来听课有意思么 ...
- 【Python redis】
目录 基本用法 连接池 基本命令 String Hash List set "下载:pip install redis @ *** 基本用法 redis库提供两个类,Redis和Strict ...
- 在linux里面ps -ef | grep tomcat 什么意思
linux中的查看和tomcat有关系的进程的命令 例如 [root@localhost bin]# ps -eaf | grep tomcat root 5091 1 0 23:04 pts/0 0 ...
- quernation,euler,rotationmatrix之间的相互转换
转自:https://blog.csdn.net/zhuoyueljl/article/details/70789472
- PAT 1017 Queueing at Bank (模拟)
Suppose a bank has K windows open for service. There is a yellow line in front of the windows which ...