
022 Spark shuffle过程
1.官网
http://spark.apache.org/docs/1.6.1/configuration.html#shuffle-behavior
Spark数据进行重新分区的操作就叫做shuffle过程

2.介绍
SparkStage划分的时候,将最后一个Stage称为ResultStage(ResultTask),其它Stage叫做ShuffleMapStage(ShuffleMapTask)

3.SparkShuffle实现
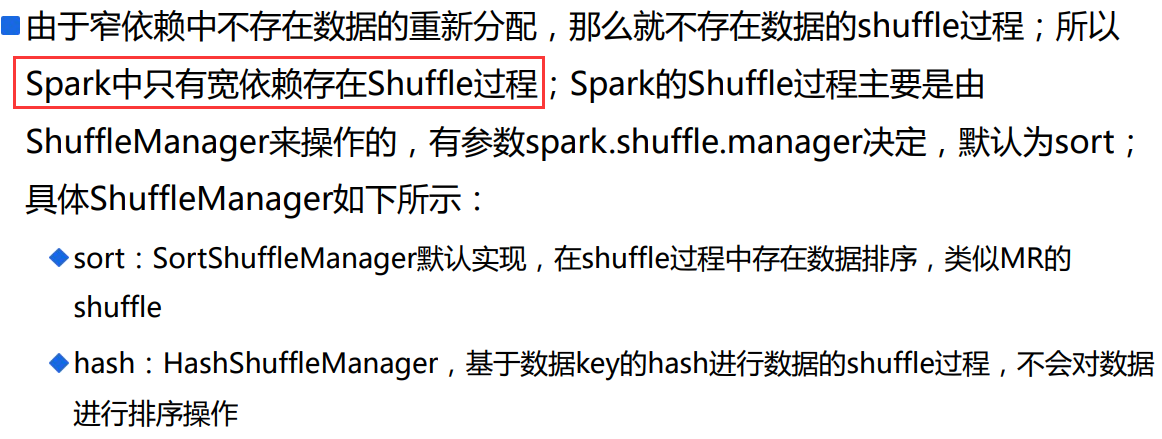
基于ShuffleManager来实现,1.6.1版本中存在两种实现:HashShuffleManager和SortShuffleManager(默认);
由参数spark.shuffle.manager决定(sort or hash)
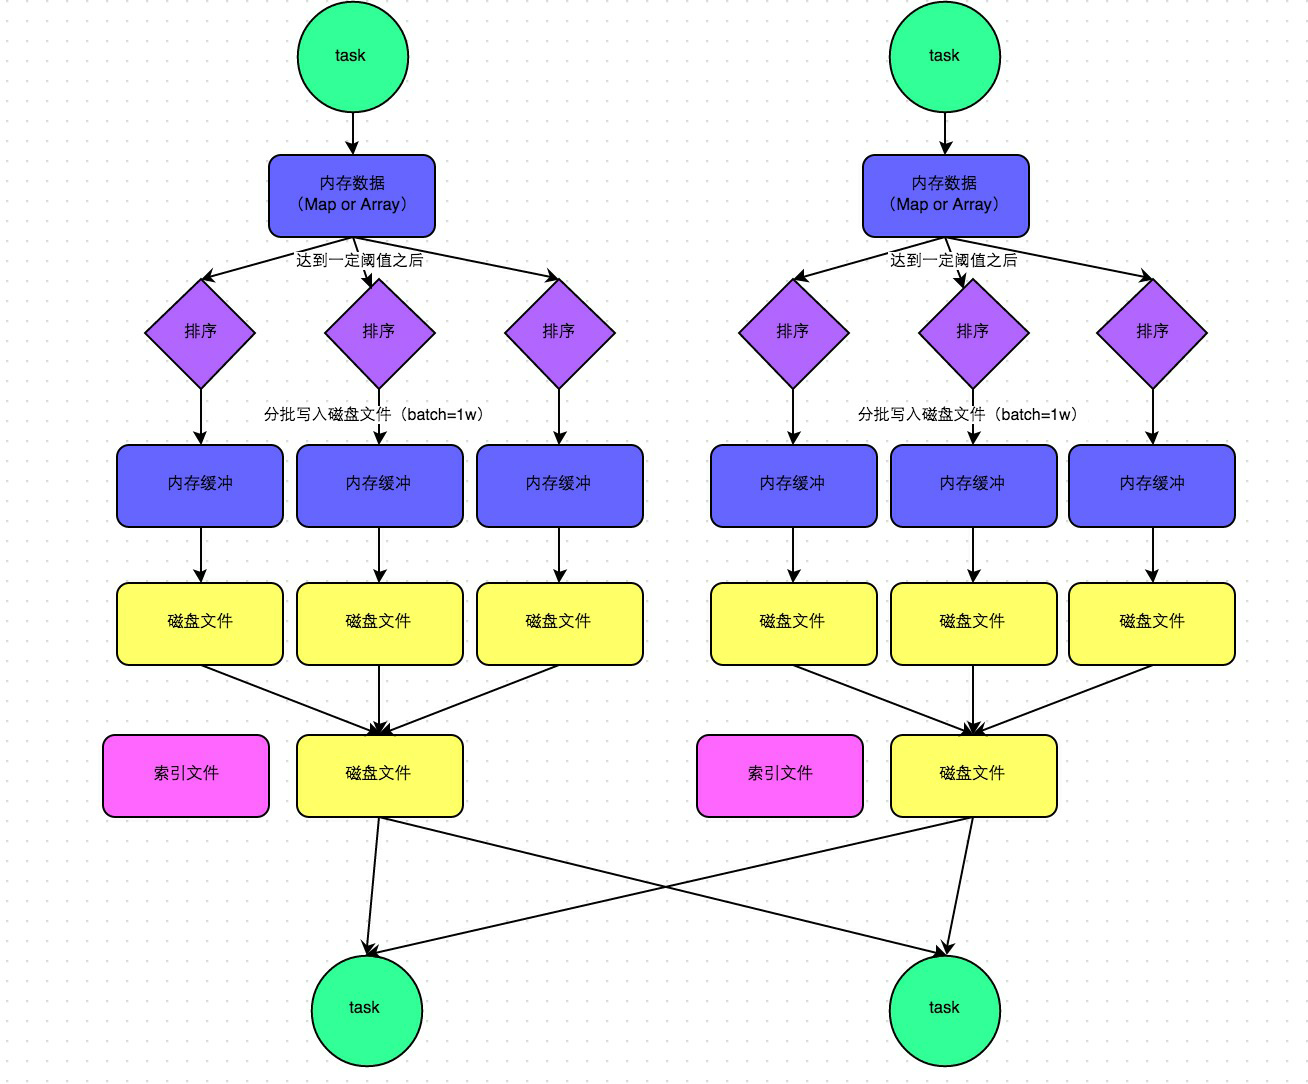
其中,sort:类似MR的shuffle,如下:
4.hash shuffle
在Spark1.2.x版本之前,只有一个ShuffleManager,就是hash
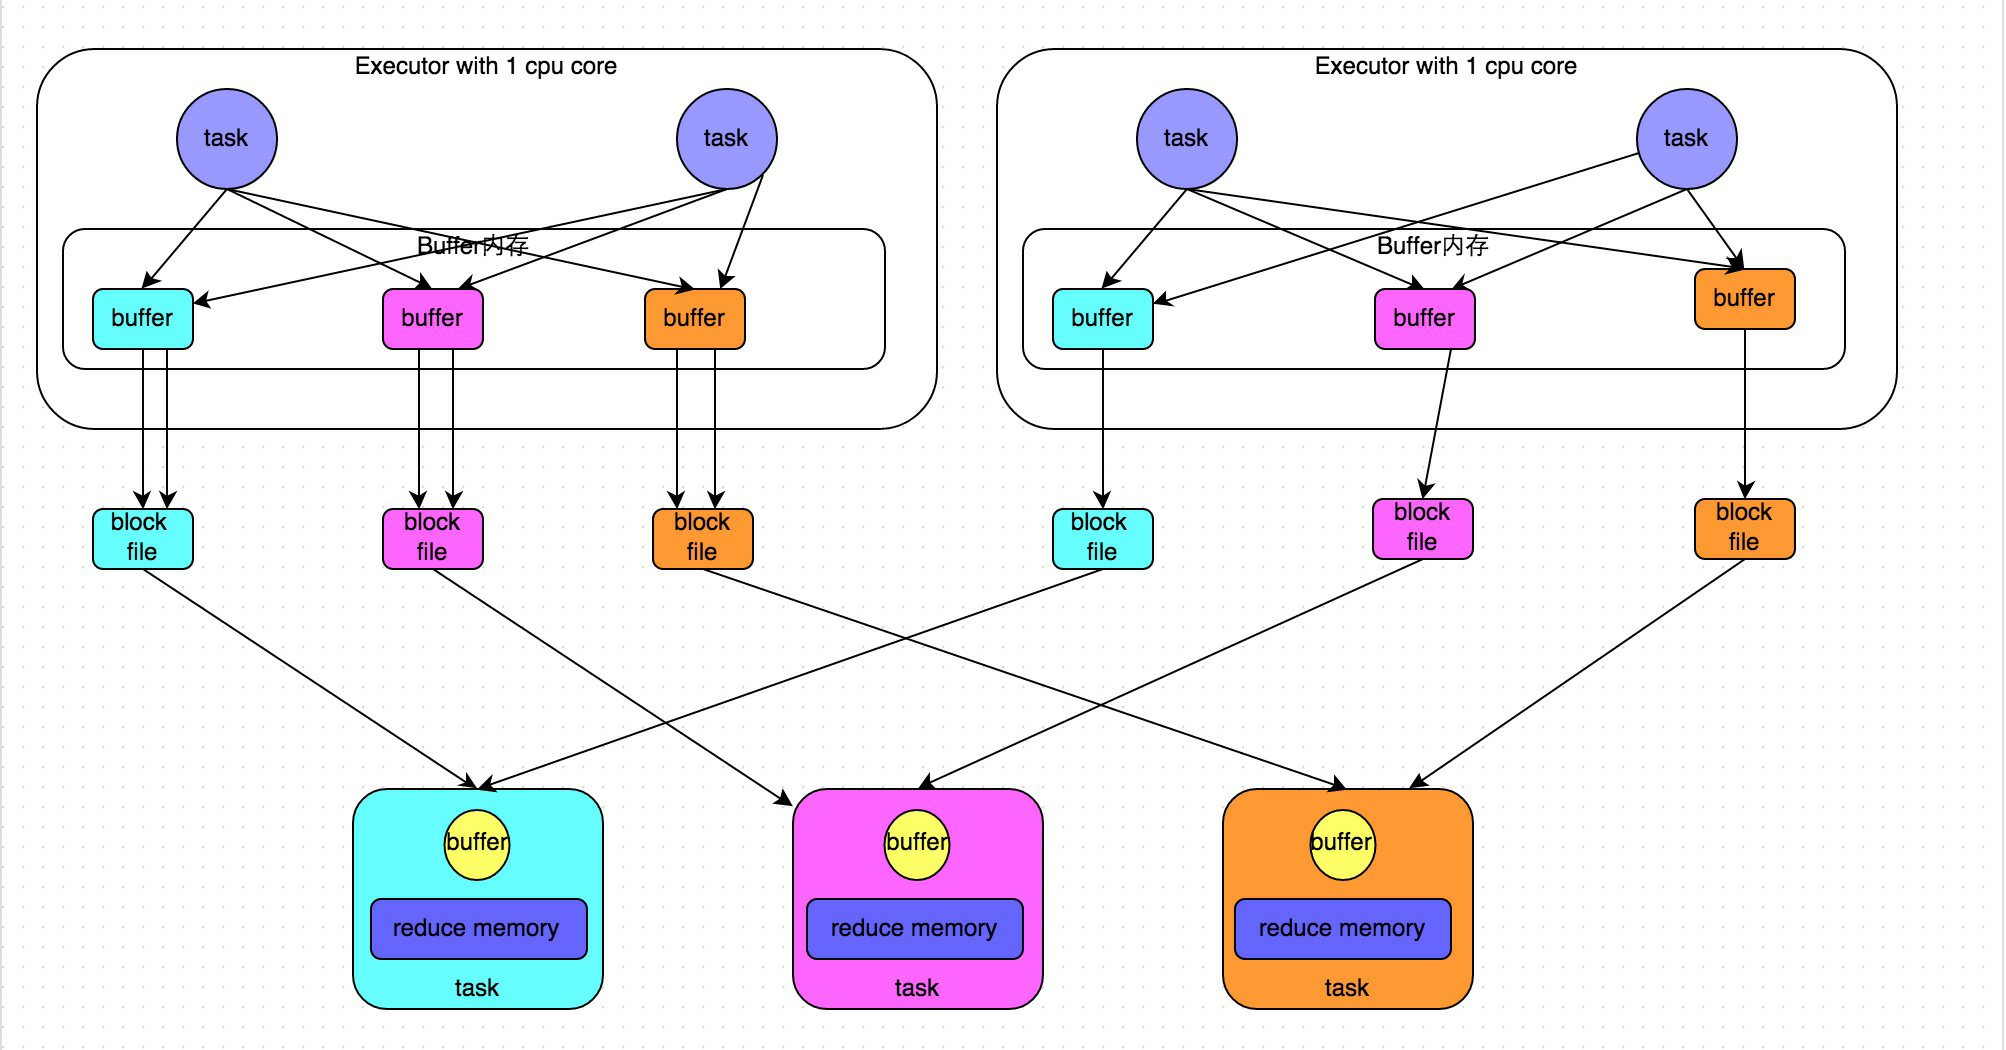
hash shuffle在以前的版本中存在一个问题:
会产生大量的磁盘问题
优化:
将一个Executor上的所有Task的执行结果合并到一起,减少文件的数量
spark.shuffle.consoldateFiles=true
原hash下的原理:

优化原理:
5.sort shuffle
在1.2版本之后,默认是SortManager,就是sort
小问题:所有的情况都进行排序(不管数据量的大小)<通过bypass运行模式可以解决>
两种运行:
普通运行模式:
中间会涉及到sort操作
bypass运行模式:
针对小数据量的情况下,不进行排序,类似于优化后的HashManager(性能没有HashManager<优化后>高)
下面是两个条件,就会走bypass模式,小数据量不排序:
-1. 当RDD的task数量小于spark.shuffle.sort.bypassMergeThreshold(默认200)的时候启用
-2. 不是聚合类shuffle算子(比如:不能是reduceByKey,可以是join)
二:shuffle与依赖的关系
1.说明
在后面补充一下知识点
2.关系
022 Spark shuffle过程的更多相关文章
- Spark Shuffle 过程
本文参考:http://www.cnblogs.com/cenyuhai/p/3826227.html 在数据流动的整个过程中,最复杂最影响性能的环节,就是 Shuffle 过程,本文将参考大神的博客 ...
- 浅析 Spark Shuffle 内存使用
在使用 Spark 进行计算时,我们经常会碰到作业 (Job) Out Of Memory(OOM) 的情况,而且很大一部分情况是发生在 Shuffle 阶段.那么在 Spark Shuffle 中具 ...
- Spark Shuffle数据处理过程与部分调优(源码阅读七)
shuffle...相当重要,为什么咩,因为shuffle的性能优劣直接决定了整个计算引擎的性能和吞吐量.相比于Hadoop的MapReduce,可以看到Spark提供多种计算结果处理方式,对shuf ...
- Spark shuffle详细过程
有许多场景下,我们需要进行跨服务器的数据整合,比如两个表之间,通过Id进行join操作,你必须确保所有具有相同id的数据整合到相同的块文件中.那么我们先说一下mapreduce的shuffle过程. ...
- 彻底搞懂spark的shuffle过程(shuffle write)
什么时候需要 shuffle writer 假如我们有个 spark job 依赖关系如下 我们抽象出来其中的rdd和依赖关系: E <-------n------, ...
- Spark 的 Shuffle过程介绍`
Spark的Shuffle过程介绍 Shuffle Writer Spark丰富了任务类型,有些任务之间数据流转不需要通过Shuffle,但是有些任务之间还是需要通过Shuffle来传递数据,比如wi ...
- 剖析Hadoop和Spark的Shuffle过程差异
一.前言 对于基于MapReduce编程范式的分布式计算来说,本质上而言,就是在计算数据的交.并.差.聚合.排序等过程.而分布式计算分而治之的思想,让每个节点只计算部分数据,也就是只处理一个分片,那么 ...
- 剖析Hadoop和Spark的Shuffle过程差异(一)
一.前言 对于基于MapReduce编程范式的分布式计算来说,本质上而言,就是在计算数据的交.并.差.聚合.排序等过程.而分布式计算分而治之的思想,让每个节点只计算部分数据,也就是只处理一个分片,那么 ...
- Spark的Shuffle过程介绍
Spark的Shuffle过程介绍 Shuffle Writer Spark丰富了任务类型,有些任务之间数据流转不需要通过Shuffle,但是有些任务之间还是需要通过Shuffle来传递数据,比如wi ...
随机推荐
- u-boot移植(七)---代码修改---存储控制器
一.CPU访问芯片的条件 CPU通过访问存储控制器,来读取外部设备的数据. CPU想访问一个芯片,需要如下条件(配置信息): 地址线 数据线:8位/16位/32位数据宽度 时钟/频率 其他芯片相关的特 ...
- DTP协议攻击
DTP协议 动态中继协议DTP(Dynamic Trunking Protocol)是一种Cisco私有协议.DTP用于两台交换机的直连二层端口探测对端的配置,自动协商出二层端口的链路类型和以太网封装 ...
- 列表控件QListWidget
列表控件可以让我们以列表形式呈现内容,是界面更加有序美观.QListWidget列表控件应当与QListWidgetItem一起使用,后者作为项被添加入列表控件中,也就是说列表控件中的每一项都是一个Q ...
- luogu P3565 [POI2014]HOT-Hotels
传送门 无脑暴力+O2=AC 题目要统计距离两两相等的三个点的组数,这三个点之间显然有一个点,并且这三个点到这个点的距离都相同.所以枚举中间这个点作为根,然后bfs整棵树,对于每一层,把以根的某个儿子 ...
- String split方法与Guava Splitter用法区别
String split方法与Guava Splitter用法区别 今天同事写了一段使用String split方法的代码,如下所示,同事期望得到的是字符"1",但是没想到却得到空 ...
- 2017-2018-2 20155303『网络对抗技术』Final:Web渗透获取WebShell权限
2017-2018-2 『网络对抗技术』Final:Web渗透获取WebShell权限 --------CONTENTS-------- 一.Webshell原理 1.什么是WebShell 2.We ...
- EMCA和EMCTL的简单用法
背景 其实这两个完全是两回事,不过倒是有关系,emca就是建立的资料库,建立后就用emctl来管理服务了.oem有问题基本都是重建emca,然后用emctl来操作. 当时用emca感觉真是一阵空白,太 ...
- 前端web服务器数据同步方案
概述: 网站采用了web和mysql数据库分离的架构,前端有web1.web2.web3需要对他们进行上传文件同步 方案: 在web2的windows服务器上安装GoodSync软件,利用其双向同步特 ...
- centos下编译安装mysql5.5/5.6/5.7
2018-12-28 14:38:46 星期五 centos 系统在mysql官网, 按照教程去配置yum源, 然后安装, 不用自己找依赖了: https://dev.mysql.com/doc/my ...
- FreeSWITCH Git版本管理
由于测试FreeSWITCH不同版本的需要,研究了下Git的使用,通过Git来管理所有的版本,方便了测试.以下就总结下具体的使用方法: 其中:git clone ..是现在git仓库:git tag ...