
Spark shuffle详细过程
有许多场景下,我们需要进行跨服务器的数据整合,比如两个表之间,通过Id进行join操作,你必须确保所有具有相同id的数据整合到相同的块文件中。那么我们先说一下mapreduce的shuffle过程。
Mapreduce的shuffle的计算过程是在executor中划分mapper与reducer。Spark的Shuffling中有两个重要的压缩参数。spark.shuffle.compress true---是否将会将shuffle中outputs的过程进行压缩。将spark.io.compression.codec编码器设置为压缩数据,默认是true.同时,通过spark.shuffle.manager 来设置shuffle时的排序算法,有hash,sort,tungsten-sort。(用hash会快一点,我不需要排序啊~)
Hash Shuffle
使用hash散列有很多缺点,主要是因为每个Map task都会为每个reduce生成一份文件,所以最后就会有M * R个文件数量。那么如果在比较多的Map和Reduce的情况下就会出问题,输出缓冲区的大小,系统中打开文件的数量,创建和删除所有这些文件的速度都会受到影响。如下图:
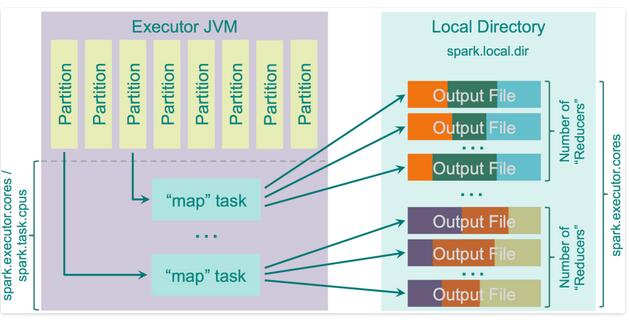
这里有一个优化的参数spark.shuffle.consolidateFiles,默认为false,当设置成true时,会对mapper output时的文件进行合并。如果你集群有E个executors(“-num-excutors”)以及C个cores("-executor-cores”),以及每个task又T个CPUs(“spark.task.cpus”),那么总共的execution的slot在集群上的个数就是E * C / T(也就是executor个数×CORE的数量/CPU个数)个,那么shuffle过程中所创建的文件就为E * C / T * R(也就是executor个数 × core的个数/CPU个数×reduce个数)个。外文文献写的太公式化,那么我用通俗易懂的形式阐述下。就好比总共的并行度是20(5个executor,4个task) Map阶段会将数据写入磁盘,当它完成时,他将会以reduce的个数来生成文件数。那么每个executor就只会计算core的数量/cpu个数的tasks.如果task数量大于总共集群并行度,那么将开启下一轮,轮询执行。
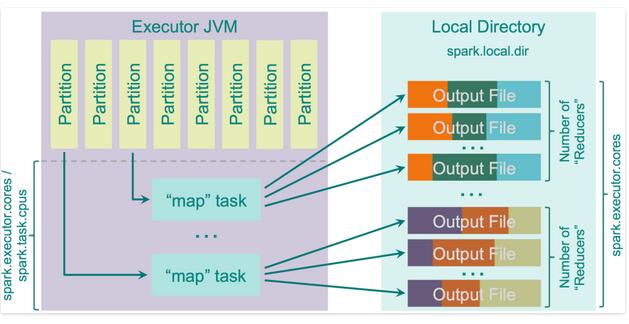
速度较快,因为没有再对中间结果进行排序,减少了reduce打开文件时的性能消耗。
当然,当数据是经过序列化以及压缩的。当重新读取文件,数据将进行解压缩与反序列化,这里reduce端数据的拉取有个参数spark.reducer.maxSizeInFlight(默认为48MB),它将决定每次数据从远程的executors中拉取大小。这个拉取过程是由5个并行的request,从不同的executor中拉取过来,从而提升了fetch的效率。 如果你加大了这个参数,那么reducers将会请求更多的文数据进来,它将提高性能,但是也会增加reduce时的内存开销。
Sort Shuffle
Sort Shuffle如同hash shuffle map写入磁盘,reduce拉取数据的一个性质,当在进行sort shuffle时,总共的reducers要小于spark.shuffle.sort.bypassMergeThrshold(默认为200),将会执行回退计划,使用hash将数据写入单独的文件中,然后将这些小文件聚集到一个文件中,从而加快了效率。(实现自BypassMergeSortShuffleWriter中)
那么它的实现逻辑是在reducer端合并mappers的输出结果。Spark在reduce端的排序是用了TimSort,它就是在reduce前,提前用算法进行了排序。 那么用算法的思想来说,合并的M N个元素进行排序,那么其复杂度为O(MNlogM) 具体算法不讲了~要慢慢看~
随之,当你没有足够的内存保存map的输出结果时,在溢出前,会将它们disk到磁盘,那么缓存到内存的大小便是 spark.shuffle.memoryFraction * spark.shuffle.safyFraction.默认的情况下是”JVM Heap Size * 0.2 * 0.8 = JVM Heap Size * 0.16”。需要注意的是,当你多个线程同时在一个executor中运行时(spark.executor.cores/spark.task.cpus 大于1的情况下),那么map output的每个task将会拥有 “JVM Heap Size * spark.shuffle.memoryFraction * spark.shuffle.safetyFraction / spark.executor.cores * spark.task.cpus。运行原理如下图:
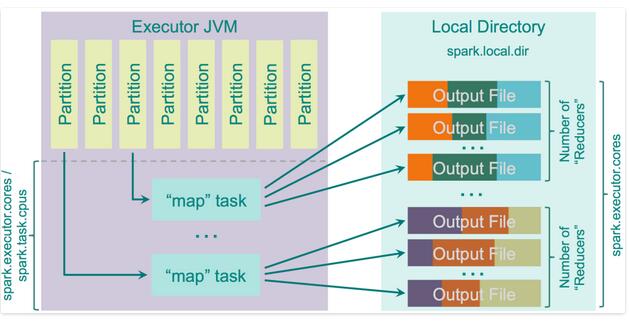
使用此种模式,会比使用hashing要慢一点,可通过bypassMergeThreshold找到集群的最快平衡点。
Tungsten Sort
使用此种排序方法的优点在于,操作的二进制数据不需要进行反序列化。它使用 sun.misc.Unsafe模式进行直接数据的复制,因为没有反序列化,所以直接是个字节数组。同时,它使用特殊的高效缓存器ShuffleExtemalSorter压记录与指针以及排序的分区id.只用了8 Bytes的空间的排序数组。这将会比使用CPU缓存要效率。
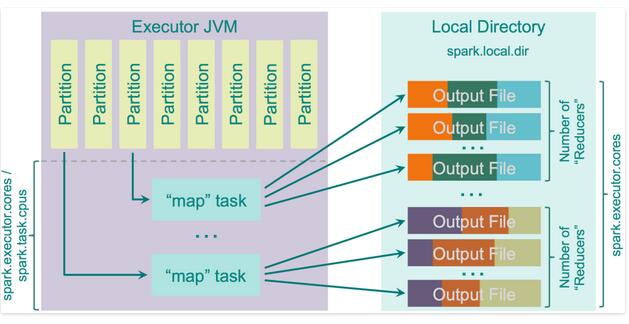
每个spill的数据、指针进行排序,输出到一个索引文件中。随后将这些partitions再次合并到一个输出文件中。
本文翻译自一位国外大神的博客:https://0x0fff.com/spark-memory-management/
Spark shuffle详细过程的更多相关文章
- Mac配置Scala和Spark最详细过程
Mac配置Scala和Spark最详细过程 原文链接: http://www.cnblogs.com/blog5277/p/8567337.html 原文作者: 博客园--曲高终和寡 一,准备工作 1 ...
- Spark Shuffle数据处理过程与部分调优(源码阅读七)
shuffle...相当重要,为什么咩,因为shuffle的性能优劣直接决定了整个计算引擎的性能和吞吐量.相比于Hadoop的MapReduce,可以看到Spark提供多种计算结果处理方式,对shuf ...
- 浅析 Spark Shuffle 内存使用
在使用 Spark 进行计算时,我们经常会碰到作业 (Job) Out Of Memory(OOM) 的情况,而且很大一部分情况是发生在 Shuffle 阶段.那么在 Spark Shuffle 中具 ...
- Spark源码系列(六)Shuffle的过程解析
Spark大会上,所有的演讲嘉宾都认为shuffle是最影响性能的地方,但是又无可奈何.之前去百度面试hadoop的时候,也被问到了这个问题,直接回答了不知道. 这篇文章主要是沿着下面几个问题来开展: ...
- 022 Spark shuffle过程
1.官网 http://spark.apache.org/docs/1.6.1/configuration.html#shuffle-behavior Spark数据进行重新分区的操作就叫做shuf ...
- Spark 源码系列(六)Shuffle 的过程解析
Spark 大会上,所有的演讲嘉宾都认为 shuffle 是最影响性能的地方,但是又无可奈何.之前去百度面试 hadoop 的时候,也被问到了这个问题,直接回答了不知道. 这篇文章主要是沿着下面几个问 ...
- Spark原始码系列(六)Shuffle的过程解析
问题导读: 1.shuffle过程的划分? 2.shuffle的中间结果如何存储? 3.shuffle的数据如何拉取过来? Shuffle过程的划分 Spark的操作模型是基于RDD的,当调用RD ...
- Spark Shuffle机制详细源码解析
Shuffle过程主要分为Shuffle write和Shuffle read两个阶段,2.0版本之后hash shuffle被删除,只保留sort shuffle,下面结合代码分析: 1.Shuff ...
- Spark Shuffle原理、Shuffle操作问题解决和参数调优
摘要: 1 shuffle原理 1.1 mapreduce的shuffle原理 1.1.1 map task端操作 1.1.2 reduce task端操作 1.2 spark现在的SortShuff ...
随机推荐
- codeforces 722C (并查集)
题目链接:http://codeforces.com/contest/722/problem/C 题意:每次破坏一个数,求每次操作后的最大连续子串和. 思路:并查集逆向操作 #include<b ...
- Ansible-Tower快速入门-4.以超级用户帐号登录【翻译】
以超级用户帐号登录 首先,登录tower需要使用tower服务器所在的URL,格式如下:https://<tower server name>/ 注意:tower安装了一个自签名证书用于H ...
- (转)CSS中的绝对定位与相对定位定位
层级关系为: <div ——————————— position:relative; 不是最近的祖先定位元素,不是参照物<div—————————-没有设置为定位元素,不是参照物<d ...
- [转]Jenkins使用 管理节点
现在我们已经搭建好了基本的Jenkins环境,在这一集里,我们说一说如何管理节点. 进入“系统管理”中的“管理节点”. 创建Windos系统的奴隶节点 先创建一台安装了Win7系统的虚拟机,作为Jen ...
- python 新旧类的问题
老式类就是经典类,不是继承自object类.在多继承时采用深度优先遍历父类.新式类就是基类继承自object类 class xxx(object).多继承时采用一种新的C3 算法来遍历父类.实例如下: ...
- javascript设计模式之观察者模式
观察者模式又称发布/订阅模式 publish/subscribe 它是一种一对多的关系,让多个观察者对象同时监听某一主题对象,这个主题对象的状态发生变化时就会通知所有的观察者对象,使得他们能够自动 ...
- 【转载】ANSYS 动力分析 (9) - 瞬态动力分析 (1)
原文地址:http://htbbzzg.blog.163.com/blog/static/69725206201081663611208/ 第四章 瞬态动力分析 第一节:瞬态动力分析的定义和目的 ...
- SQL-server的事务,视图和索引
(1): A: B: C: D: 选错误A,D 因为bc不对所以选AD,A:关系数据库中,数据是保存在数据页中的,而索引则是存储在索引页中.因此,数据表中的索引并非越多越好,一个表中如果有大量的索引 ...
- P1834 种花小游戏
我只是想做壮鸭低劈啊,为什么只有状压没有DP-- 原题: 植物大战僵尸这款游戏中,还有个特别有意思的赚钱方式--种花(能长金币的花).种出来的金币需要玩家点击才能得到,或者,玩家可以购买一只蜗牛来帮助 ...
- Fiddler (HTTP抓包)简介
1.什么是Fiddler? Fiddler是位于客户端和服务器端的HTTP代理,也是目前最常用的http抓包工具之一.它能够记录客户端和服务器之间的所有HTTP请求,可以针对特定的HTTP请求,分析请 ...