
Scrapy项目创建以及目录详情
Scrapy项目创建已经目录详情
一、新建项目(scrapy startproject)
- 在开始爬取之前,必须创建一个新的Scrapy项目。进入自定义的项目目录中,运行下列命令:
PS C:\scrapy> scrapy startproject sp1

You can start your first spider with:

    cd sp1

    scrapy genspider example example.com
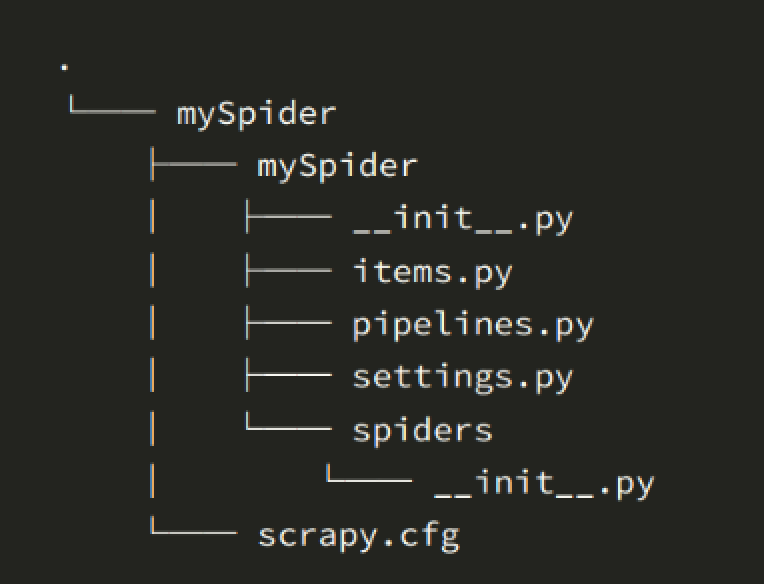
- scrapy.cfg # 项目的配置文件
- sp1/ # 项目的Python模块,将会从这里引用代码
- sp1/items.py # 项目的目标文件
- sp1/pipelines.py # 项目的管道文件用于文件持久化
- sp1/settings.py # 项目的设置文件
- sp1/middlewares.py # 中间件
- sp1/spiders/ # 存储爬虫代码目录
settings.py内容详情
settings.py
# 项目名

BOT_NAME = 'sp1'

# 爬虫所在的位置

SPIDER_MODULES = ['sp1.spiders']

NEWSPIDER_MODULE = 'sp1.spiders'

# 爬虫是否遵循 robots 协议

ROBOTSTXT_OBEY = False

# 爬虫的并发量 默认 16 个

# CONCURRENT_REQUESTS = 32

# 下载延时 3 s

#DOWNLOAD_DELAY = 3

# 是否禁用cookies  默认不禁用

#COOKIES_ENABLED = False        # 表示为禁用

# 请求包头

DEFAULT_REQUEST_HEADERS = {

    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.186 Safari/537.36',

    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

    # 语言可以关闭,按照服务器返回值为准

    # 'Accept-Language': 'en',

}

# 下载中间件,值越小优先级越高

DOWNLOADER_MIDDLEWARES = {

   'sp1.middlewares.Sp1DownloaderMiddleware': 543,

}

# 下载后的数据如何处理,存储过程

ITEM_PIPELINES = {

   'sp1.pipelines.FilePipeline': 300,

}
创建一个爬虫文件
在当前目录下输入命令,将在sp1/spider目录下创建一个名为itcast的爬虫,并指定爬取域的范围:
PS C:\scrapy> cd sp1

# scrapy genspider关键字    chouti 爬虫名         chouti.com 一般指定站点域名

PS C:\scrapy\sp1> scrapy genspider chouti chouti.com

Created spider 'chouti' using template 'basic' in module:

  sp1.spiders.chouti
通过pycharm调试scrapy项目
1.使用pycharm打开项目
2.在项目等级目录创建main.py
from scrapy.cmdline import execute

import sys

import os

BASE_DIR = os.path.dirname(os.path.abspath(__file__))

print(BASE_DIR)

execute(["scrapy","crawl","chouti"])
Scrapy项目创建以及目录详情的更多相关文章
- Python Scrapy项目创建(基础普及篇)
在使用Scrapy开发爬虫时,通常需要创建一个Scrapy项目.通过如下命令即可创建 Scrapy 项目: scrapy startproject ZhipinSpider 在上面命令中,scrapy ...
- IDEA中Java项目创建lib目录并生成依赖
首先介绍说明一下idea在创建普通的Java项目,是没有lib文件夹的,下面我来带大家来创建一下1.右键点击项目,创建一个普通的文件夹 2.取名为lib 3.把项目所需的jar包复制到lib文件夹下 ...
- 创建第一个Scrapy项目
d:进入D盘 scrapy startproject tutorial建立一个新的Scrapy项目 工程的目录结构: tutorial/ scrapy.cfg # 部署配置文件 tutorial/ # ...
- Scrapy项目结构分析和工作流程
新建的空Scrapy项目: spiders目录: 负责存放继承自scrapy的爬虫类.里面主要是用于分析response并提取返回的item或者是下一个URL信息,每个Spider负责处理特定的网站或 ...
- 【pycharm基本操作】项目创建、切换、运行、字体颜色设置,常见包的安装步骤
创建新项目 退出项目 怎样区别虚拟环境和系统环境? 虚拟环境和系统环境切换:进入项目切换解释器 切换项目 创建python目录和文件 代码运行方式一: 还可以这样执行代码方式二: 文件的剪切.复制.删 ...
- pycharm创建scrapy项目教程及遇到的坑
最近学习scrapy爬虫框架,在使用pycharm安装scrapy类库及创建scrapy项目时花费了好长的时间,遇到各种坑,根据网上的各种教程,花费了一晚上的时间,终于成功,其中也踩了一些坑,现在整理 ...
- eclipse创建scrapy项目
1. 您必须创建一个新的Scrapy项目. 进入您打算存储代码的目录中(比如否F:/demo),运行下列命令: scrapy startproject tutorial 2.在eclipse中创建一个 ...
- Python -- Scrapy 框架简单介绍(Scrapy 安装及项目创建)
Python -- Scrapy 框架简单介绍 最近在学习python 爬虫,先后了解学习urllib.urllib2.requests等,后来发现爬虫也有很多框架,而推荐学习最多就是Scrapy框架 ...
- Scrapy库安装和项目创建
Scrapy是一个流行的网络爬虫框架,从现在起将陆续记录Python3.6下Scrapy整个学习过程,方便后续补充和学习.本文主要介绍scrapy安装.项目创建和测试基本命令操作 scrapy库安装 ...
随机推荐
- Selenium: Trying to log in with cookies and get the errorMessage - “Can only set cookies for current domain” or "Unable to set Cookie"
from selenium import webdriver driver = webdriver.PhantomJS(executable_path='G:/OpenSources/phantomj ...
- 【转】python模块分析之hashlib加密(二)
[转]python模块分析之hashlib加密(二) hashlib模块是用来对字符串进行hash加密的模块,明文与密文是一一对应不变的关系:用于注册.登录时用户名.密码等加密使用.一.函数分析:1. ...
- python3 - 默认参数为列表
默认参数的坑 定义一个函数,传入一个list,添加一个end再返回 1 2 3 def add_end(L=[]): L.append('END') return L 正常调用时,结 ...
- 使用chttpfile的一个错误
先贴一部分代码 CString strHttpName="http://localhost/TestReg/RegForm.aspx"; // 需要提交数据的页面 CString ...
- PostgreSQL安装和创建用户和创建数据库
一.安装 可以参考postgresql官网安装教程:https://www.postgresql.org/download/linux/redhat/ Centos 6 安装postgresql 10 ...
- 洛谷P3317 [SDOI2014]重建 [Matrix-Tree定理]
传送门 思路 相信很多人像我一样想直接搞Matrix-Tree定理,而且还过了样例,然后交上去一分没有. 但不管怎样这还是对我们的思路有一定启发的. 用Matrix-Tree定理搞,求出的答案是 \[ ...
- Codeforces 1107G Vasya and Maximum Profit [单调栈]
洛谷 Codeforces 我竟然能在有生之年踩标算. 思路 首先考虑暴力:枚举左右端点直接计算. 考虑记录\(sum_x=\sum_{i=1}^x c_i\),设选\([l,r]\)时那个奇怪东西的 ...
- Codeforces 446C DZY Loves Fibonacci Numbers [线段树,数论]
洛谷 Codeforces 思路 这题知道结论就是水题,不知道就是神仙题-- 斐波那契数有这样一个性质:\(f_{n+m}=f_{n+1}f_m+f_{n}f_{m-1}\). 至于怎么证明嘛-- 即 ...
- 虚拟机时间同步14 Aug 04:09:18 ntpdate[2941]: no server suitable for synchronization found
因为虚拟机经常挂起,所以需要时间同步 [root@slave1 /root]$ cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime cp: over ...
- 如果Android真的收费了,你怎么看?
前言 今天突然看到一群里有人发了下面这样一张图片,然后群里又炸了! 于是又和同事讨论了android收费的问题,然后隔壁正在玩农药的UI妹子就笑了... 没错! 安卓可能要收费了!安卓可能要收费了 ...