
python抓取网页数据处理后可视化
抓取文章的链接,访问量保存到本地
 #coding=utf-8

 import requests as req

 import re

 import urllib

 from bs4 import BeautifulSoup

 import sys

 import codecs

 import time

 r=req.get('https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000',

          headers={'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36'})

 content=r.text

 #print(content)

 soup=BeautifulSoup(content,'html.parser')

 #下面2行内容解决UnicodeEncodeError: 'ascii' codec can't encode characters in position 63-64问题,但是加了后print就打印不出来了,需要查原因

 reload(sys)

 sys.setdefaultencoding('utf-8')

 i=0

 for tag in soup.find_all(re.compile(r'^a{1}'),{'class':'x-wiki-index-item'}):

     i=i+1

     if i%3==0:

         time.sleep(30)

     name=tag.get_text()

     href='https://www.liaoxuefeng.com'+tag['href']

     req2=req.get(href,headers={'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36'})

     time.sleep(3)

     soup2=BeautifulSoup(req2.text,'html.parser')

     count=soup2.find_all('div',{'class':'x-wiki-info'})

     try:

         co=count[0].find('span').get_text()

         co=co[7:]

     except IndexError as e:

         co=''

     with open('E:/sg_articles.xlsx', 'a+') as f:

         f.write(codecs.BOM_UTF8)#解决写入csv后乱码问题

         f.write(name+','+href+','+co+'\n')

 '''

 睡眠是因为网页访问过多就会报503 Service Unavailable for Bot网站超过了iis限制造成的由于2003的操作系统在提示IIS过多时并非像2000系统提示“链接人数过多”

 http://www.51testing.com/html/53/15150753-4455790.html --数据可视化

 http://www.cnblogs.com/xxoome/p/5880693.html --python引入模块时import与from ... import的区别

 https://www.cnblogs.com/amou/p/9184614.html --讲解几种爬取网页的匹配方式

 https://www.cnblogs.com/yinheyi/p/6043571.html --python基本语法

 '''
上面代码的思路:先获取主网页,再遍历主网页上的文章链接并请求这些链接以进入子网页,从而获得子网页中span标签保存的访问量。
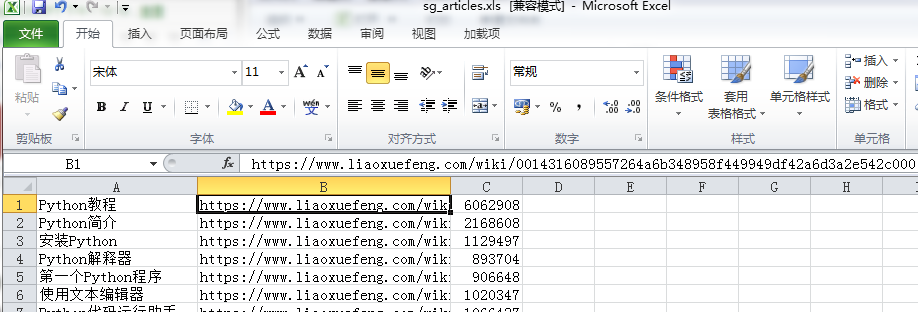
下面打开本地文件,pandas进行数据分析,然后pyecharts实现图形化
 #coding=utf-8

 from pyecharts import Bar

 import pandas as pd

 p=pd.read_excel('E:\sg_articles.xls',names=["title","href","count"])

 a=p.sort_values(by='count',ascending=False)[0:3]

 title=a['title']

 count=a['count']

 bar=Bar("点击量TOP3", title_pos='center', title_top='', width=800, height=400)

 bar.add("", title, count, is_convert=True, xaxis_min=10, yaxis_rotate=30, yaxis_label_textsize=10, is_yaxis_boundarygap=True, yaxis_interval=0,

         is_label_show=True, is_legend_show=False, label_pos='right',is_yaxis_inverse=True, is_splitline_show=False)

 bar.render("E:\点击量TOP3.html")
最后的结果

同时还有很多疑问,需要懂的朋友帮忙解答:
1.第一段代码中保存的xlsx格式,实际保存后打开是提示有损坏的,使用xml打开则就没有问题,另存为xls格式后打开也没有问题
2.访问量过多会报错,我就利用了sleep,但实际上访问量间断性的读取到了值,有的为什么读不到值了?
3.利用sort_values对count列进行排序取前3,这个会自动排除掉excel表格的第一行,不知道是为什么
感觉后面我还需要强化1)pandas数据处理的方法,比如分组排序等
2)正则表达式的提取
3)pyecharts的图形绘制
4)在遇到网页有反爬情况下的虚拟ip设置等
记录我的python学习之路,大家一起努力哟~~
python抓取网页数据处理后可视化的更多相关文章
- Python 抓取网页并提取信息(程序详解)
最近因项目需要用到python处理网页,因此学习相关知识.下面程序使用python抓取网页并提取信息,具体内容如下: #---------------------------------------- ...
- python抓取网页例子
python抓取网页例子 最近在学习python,刚刚完成了一个网页抓取的例子,通过python抓取全世界所有的学校以及学院的数据,并存为xml文件.数据源是人人网. 因为刚学习python,写的代码 ...
- python抓取网页过程
准备过程 1.抓取网页的过程 准备好http请求(http request)->提交对应的请求->获得返回的响应(http response)->获得网页源码 2.GET还是POST ...
- Python抓取网页中的图片到本地
今天在网上找了个从网页中通过图片URL,抓取图片并保存到本地的例子: #!/usr/bin/env python # -*- coding:utf- -*- # Author: xixihuang # ...
- python抓取网页引用的模块和类
在Python3.x中,我们可以使用urlib这个组件抓取网页,urllib是一个URL处理包,这个包中集合了一些处理URL的模块,如下:1.urllib.request模块用来打开和读取URLs:2 ...
- python抓取网页中图片并保存到本地
#-*-coding:utf-8-*- import os import uuid import urllib2 import cookielib '''获取文件后缀名''' def get_file ...
- python 抓取网页一部分
import re import requests from bs4 import BeautifulSoup response = requests.get("https://jecvay ...
- 网络爬虫-使用Python抓取网页数据
搬自大神boyXiong的干货! 闲来无事,看看了Python,发现这东西挺爽的,废话少说,就是干 准备搭建环境 因为是MAC电脑,所以自动安装了Python 2.7的版本 添加一个 库 Beauti ...
- 浅谈如何使用python抓取网页中的动态数据
我们经常会发现网页中的许多数据并不是写死在HTML中的,而是通过js动态载入的.所以也就引出了什么是动态数据的概念, 动态数据在这里指的是网页中由Javascript动态生成的页面内容,是在页面加载到 ...
随机推荐
- Redis集群搭建-韩国庆
认真一步一步搭建下来,就可以成功.... Redis-cluster集群架构讲解 redis集群专业名词称之为Redis-cluster,redis集群是从3.0版本以后才有的概念,也就是说在3.0之 ...
- 通过nginx日志,统计最近两天的交易笔数
#!/bin/bash yesterday=`date -d last-day +%Y-%m-%d` dayago=`date -d '2 days ago' +%Y-%m-%d` #echo $ye ...
- js中各种弹窗
** * JS提示跳转 * @param $tip 弹窗口提示信息(为空没有提示) * @param $type 设置类型 close = 关闭 ,back=返回 ,refresh=提示重载,j ...
- Eclipse配置“运行时依赖路径”
Python项目 本地有项目A,项目B,项目A,依赖项目B,在eclipse中,将项目B的路径添加到项目A的PYTHONPATH中. Java项目Build path(略)
- makefile中打印变量名字,方便调试
$(warning $(DVD_SERVICE)) // DVD_SerVICE是Makefile中的变量 $(warning ST40_IMPORTS is $(ST40_IMPORTS)) 变 ...
- python web编程之网络基础
1.TCP/IP协议 1)分层 应用层,传输层,网络层,接口层 2)Ip地址 3)域名 4)URL统一资源定位符 格式: [协议]://[主机]:[端口]/[路径]?[参数] 协议是HTTP,F ...
- 进制与进制转换DAY2
进制和进制转换 一.进制的基础 1.十进制(案例) 系数:0-9 进位规则:逢十进一 权:基数的次幂 基数:几进制基数就是几 规律:右侧第一位的权是10的0次幂,每向左移动一位次幂会+1. 进制的表示 ...
- JAVA设计方法思考之如何实现一个方法执行完毕后自动执行下一个方法
今天编程时,突然想起来在一些异步操作或Android原生库的时候,需要我们实现一些方法, 这些方法只需要我们具体实现,然后他们会在适当的时候,自动被调用! 例如AsyncTask,执行玩doInBac ...
- Mysql千万级大表优化
Mysql的单张表的最大数据存储量尚没有定论,一般情况下mysql单表记录超过千万以后性能会变得很差.因此,总结一些相关的Mysql千万级大表的优化策略. 1.优化sql以及索引 1.1优化sql 1 ...
- Rsync + Lsyncd服务实现文件实时同步/备份
1.接受端安装rsync yum -y install rsync 2.配置同步模块 vim /etc/rsyncd.conf # any name you like [backup] # desti ...