
Spark Stage 的划分
Spark作业调度
对RDD的操作分为transformation和action两类,真正的作业提交运行发生在action之后,调用action之后会将对原始输入数据的所有transformation操作封装成作业并向集群提交运行。这个过程大致可以如下描述:
- 由DAGScheduler对RDD之间的依赖性进行分析,通过DAG来分析各个RDD之间的转换依赖关系
- 根据DAGScheduler分析得到的RDD依赖关系将Job划分成多个stage
- 每个stage会生成一个TaskSet并提交给TaskScheduler,调度权转交给TaskScheduler,由它来负责分发task到worker执行
接下来,理解 Spark 中RDD的依赖关系.
RDD依赖关系
Spark中RDD的粗粒度操作,每一次transformation都会生成一个新的RDD,这样就会建立RDD之间的前后依赖关系,在Spark中,依赖关系被定义为两种类型,分别是窄依赖和宽依赖
- 窄依赖,父RDD的分区最多只会被子RDD的一个分区使用,
- 宽依赖,父RDD的一个分区会被子RDD的多个分区使用(宽依赖指子RDD的每个分区都要依赖于父RDD的所有分区,这是shuffle类操作)
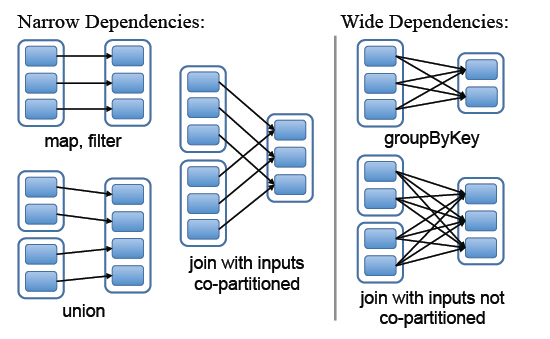
图中左边都是窄依赖关系,可以看出分区是1对1的。右边为宽依赖关系,有分区是1对多。(map,filter,union属于第一类窄依赖)
stage的划分
stage的划分是Spark作业调度的关键一步,它基于DAG确定依赖关系,借此来划分stage,将依赖链断开,每个stage内部可以并行运行,整个作业按照stage顺序依次执行,最终完成整个Job。实际应用提交的Job中RDD依赖关系是十分复杂的,依据这些依赖关系来划分stage自然是十分困难的,Spark此时就利用了前文提到的依赖关系,调度器从DAG图末端出发,逆向遍历整个依赖关系链,遇到ShuffleDependency(宽依赖关系的一种叫法)就断开,遇到NarrowDependency就将其加入到当前stage。stage中task数目由stage末端的RDD分区个数来决定,RDD转换是基于分区的一种粗粒度计算,一个stage执行的结果就是这几个分区构成的RDD。
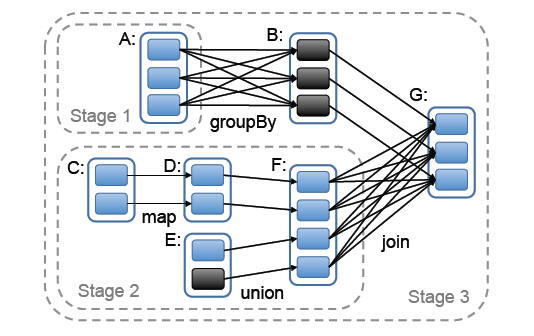
图中可以看出,在宽依赖关系处就会断开依赖链,划分stage,这里的stage1不需要计算,只需要计算stage2和stage3,就可以完成整个Job。
总结:遇到一个宽依赖就分一个stage
参考博客:https://blog.csdn.net/mahuacai/article/details/51919615
Spark Stage 的划分的更多相关文章
- 【Spark篇】--Spark中的宽窄依赖和Stage的划分
一.前述 RDD之间有一系列的依赖关系,依赖关系又分为窄依赖和宽依赖. Spark中的Stage其实就是一组并行的任务,任务是一个个的task . 二.具体细节 窄依赖 父RDD和子RDD parti ...
- 用实例说明Spark stage划分原理
注意:此文的stage划分有错,stage的划分是以shuffle操作作为边界的,可以参考<spark大数据处理技术>第四章page rank例子! 参考:http://litaotao. ...
- spark 源码分析之十九 -- DAG的生成和Stage的划分
上篇文章 spark 源码分析之十八 -- Spark存储体系剖析 重点剖析了 Spark的存储体系.从本篇文章开始,剖析Spark作业的调度和计算体系. 在说DAG之前,先简单说一下RDD. 对RD ...
- 021 RDD的依赖关系,以及造成的stage的划分
一:RDD的依赖关系 1.在代码中观察 val data = Array(1, 2, 3, 4, 5) val distData = sc.parallelize(data) val resultRD ...
- stage的划分
stage的划分是以shuffle操作作为边界的,遇到一个宽依赖就分一个stage 一个Job会被拆分为多组Task,每组任务被称为一个Stage就像Map Stage, Reduce Stage.S ...
- 窄依赖与宽依赖&stage的划分依据
RDD根据对父RDD的依赖关系,可分为窄依赖与宽依赖2种. 主要的区分之处在于父RDD的分区被多少个子RDD分区所依赖,如果一个就为窄依赖,多个则为宽依赖.更好的定义应该是: 窄依赖的定义是子RDD的 ...
- Spark 宽窄依赖和stage的划分
窄依赖 父RDD和子RDD partition之间的关系是一对一的,或者父RDD一个partition只对应一个子RDD的partition情况下的父RDD和子RDD partition关系是多对一的 ...
- Spark Stage切分 源码剖析——DAGScheduler
Spark中的任务管理是很重要的内容,可以说想要理解Spark的计算流程,就必须对它的任务的切分有一定的了解.不然你就看不懂Spark UI,看不懂Spark UI就无法去做优化...因此本篇就从源码 ...
- spark的知识的链接
IDEA 创建scala spark的Mvn项目:https://blog.csdn.net/u014646662/article/details/84618032 Spark详解03Job 物理执行 ...
随机推荐
- linux hostid与lmhostid
https://wangchujiang.com/linux-command/c/hostid.html hostid(host identifier) 显示当前主机的十六进制数字标识. 概要 hos ...
- 寻找下一个结点 牛客网 程序员面试金典 C++ java Python
寻找下一个结点 牛客网 程序员面试金典 C++ java Python 题目描述 请设计一个算法,寻找二叉树中指定结点的下一个结点(即中序遍历的后继). 给定树的根结点指针TreeNode* root ...
- hdu 1027 Ignatius and the Princess II(正、逆康托)
题意: 给N和M. 输出1,2,...,N的第M大全排列. 思路: 将M逆康托,求出a1,a2,...aN. 看代码. 代码: int const MAXM=10000; int fac[15]; i ...
- 第04课 OpenGL 旋转
旋转: 在这一课里,我将教会你如何旋转三角形和四边形.左图中的三角形沿Y轴旋转,四边形沿着X轴旋转. 上一课中我教给您三角形和四边形的着色.这一课我将教您如何将这些彩色对象绕着坐标轴旋转.其实只需在上 ...
- nodejs:使用puppeteer在服务器中构建一个获取电影电视剧剧集的接口
首先我们看下数据来源: 来源于这个网站:https://z1.m1907.cn/ 可以说这个网站上能找到很多你想看的很多电影或电视剧,最重要的是很多电影电视剧在别的网站是收费的,但是在这里看是免费的, ...
- Docker 搭建 Jenkins 持续集成自动化构建环境
1.Docker镜像拉取 Jenkins 环境命令 docker pull jenkins/jenkins:lts 查看下拉取的镜像 docker images 2.通过容器编排方式构建 Jenkin ...
- 编译安装与gcc编译器
先说一下gcc编译器,只知道这是一个老款的编译器.编译的目的也比较重要,就是将c语言的代码编译成可以执行的binary文件. gcc 简单使用(后期补充) eg: gcc example.c # ...
- 利用DNS缓存和TLS协议将受限SSRF变为通用SSRF
本文首发于先知社区 前言 这是今年BlackHat上的一个议题:When TLS Hacks You,作者是latacora的Joshua Maddux 议题提出了一个新的ssrf攻击思路,利用DNS ...
- 问题 C: A+B Problem II
题目描述 I have a very simple problem for you. Given two integers A and B, your job is to calculate the ...
- 网络安全协议之IPsec
声明 本文仅发表在博客园,作者LightningStar. 简介[1] IPSec(Internet 协议安全)是一个工业标准网络安全协议,工作在OSI模型的第三层,即网络层,为IP网络通信提供透明的 ...