
【Spark篇】--Spark中的宽窄依赖和Stage的划分
一、前述
RDD之间有一系列的依赖关系,依赖关系又分为窄依赖和宽依赖。
Spark中的Stage其实就是一组并行的任务,任务是一个个的task 。
二、具体细节
- 窄依赖
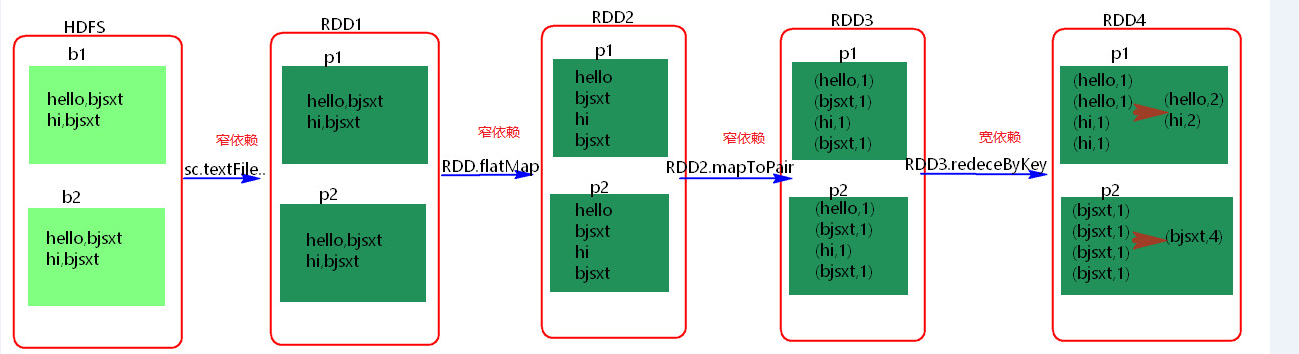
父RDD和子RDD partition之间的关系是一对一的。或者父RDD一个partition只对应一个子RDD的partition情况下的父RDD和子RDD partition关系是多对一的。不会有shuffle的产生。父RDD的一个分区去到子RDD的一个分区。
- 宽依赖
父RDD与子RDD partition之间的关系是一对多。会有shuffle的产生。父RDD的一个分区的数据去到子RDD的不同分区里面。
其实区分宽窄依赖主要就是看父RDD的一个Partition的流向,要是流向一个的话就是窄依赖,流向多个的话就是宽依赖。看图理解:
- Stage概念
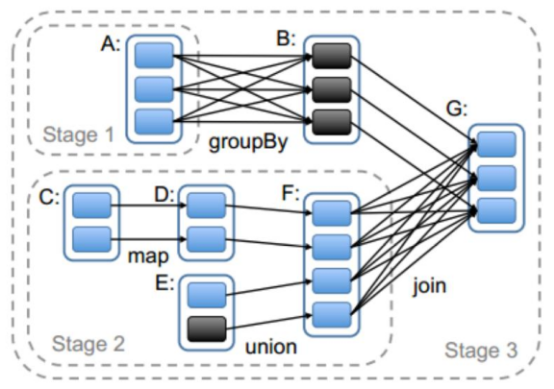
Spark任务会根据RDD之间的依赖关系,形成一个DAG有向无环图,DAG会提交给DAGScheduler,DAGScheduler会把DAG划分相互依赖的多个stage,划分stage的依据就是RDD之间的宽窄依赖。遇到宽依赖就划分stage,每个stage包含一个或多个task任务。然后将这些task以taskSet的形式提交给TaskScheduler运行。 stage是由一组并行的task组成。
- stage切割规则
切割规则:从后往前,遇到宽依赖就切割stage。
- stage计算模式
pipeline管道计算模式,pipeline只是一种计算思想,模式。

备注:图中几个理解点:
1、Spark的pipeLine的计算模式,相当于执行了一个高阶函数f3(f2(f1(textFile))) !+!+!=3 也就是来一条数据然后计算一条数据,把所有的逻辑走完,然后落地,准确的说一个task处理遗传分区的数据 因为跨过了不同的逻辑的分区。而MapReduce是 1+1=2,2+1=3的模式,也就是计算完落地,然后在计算,然后再落地到磁盘或内存,最后数据是落在计算节点上,按reduce的hash分区落地。所以这也是比Mapreduce快的原因,完全基于内存计算。
2、管道中的数据何时落地:shuffle write的时候,对RDD进行持久化的时候。
3. Stage的task并行度是由stage的最后一个RDD的分区数来决定的 。一般来说,一个partiotion对应一个task,但最后reduce的时候可以手动改变reduce的个数,也就是分区数,即改变了并行度。例如reduceByKey(XXX,3),GroupByKey(4),union由的分区数由前面的相加。
4.、如何提高stage的并行度:reduceBykey(xxx,numpartiotion),join(xxx,numpartiotion)
- 测试验证pipeline计算模式
import org.apache.spark.SparkConf

import org.apache.spark.SparkContext

import java.util.Arrays

object PipelineTest {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf()

    conf.setMaster("local").setAppName("pipeline");

    val sc = new SparkContext(conf)

    val rdd = sc.parallelize(Array(1,2,3,4))

    val rdd1 = rdd.map { x => {

      println("map--------"+x)

      x

    }}

    val rdd2 = rdd1.filter { x => {

      println("fliter********"+x)

      true

    } }

    rdd2.collect()

    sc.stop()

  }

}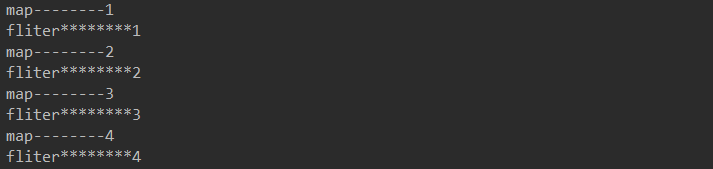
可见是按照所有的逻辑将数据一条条的执行。!!!
【Spark篇】--Spark中的宽窄依赖和Stage的划分的更多相关文章
- Spark 宽窄依赖和stage的划分
窄依赖 父RDD和子RDD partition之间的关系是一对一的,或者父RDD一个partition只对应一个子RDD的partition情况下的父RDD和子RDD partition关系是多对一的 ...
- 【转载】Spark学习——spark中的几个概念的理解及参数配置
首先是一张Spark的部署图: 节点类型有: 1. master 节点: 常驻master进程,负责管理全部worker节点.2. worker 节点: 常驻worker进程,负责管理executor ...
- Spark中文指南(入门篇)-Spark编程模型(一)
前言 本章将对Spark做一个简单的介绍,更多教程请参考:Spark教程 本章知识点概括 Apache Spark简介 Spark的四种运行模式 Spark基于Standlone的运行流程 Spark ...
- 【原】Spark中Job如何划分为Stage
版权声明:本文为原创文章,未经允许不得转载. 复习内容: Spark中Job的提交 http://www.cnblogs.com/yourarebest/p/5342404.html 1.Spark中 ...
- HBase读写的几种方式(二)spark篇
1. HBase读写的方式概况 主要分为: 纯Java API读写HBase的方式: Spark读写HBase的方式: Flink读写HBase的方式: HBase通过Phoenix读写的方式: 第一 ...
- spark在idea中本地如何运行?(处理问题NoSuchFieldException: SHUTDOWN_HOOK_PRIORITY)
spark在idea中本地如何运行? 前几天尝试使用idea在本地运行spark+scala的程序,出现了问题,http://www.cnblogs.com/yjf512/p/7662105.html ...
- Spark 2.x 中 Sort-Based Shuffle 产生的内幕
本课主题 Sorted-Based Shuffle 的诞生和介绍 Shuffle 中六大令人费解的问题 Sorted-Based Shuffle 的排序和源码鉴赏 Shuffle 在运行时的内存管理 ...
- Spark调研笔记第6篇 - Spark编程实战FAQ
本文主要记录我使用Spark以来遇到的一些典型问题及其解决的方法,希望对遇到相同问题的同学们有所帮助. 1. Spark环境或配置相关 Q: Sparkclient配置文件spark-defaults ...
- 【转帖】HBase读写的几种方式(二)spark篇
HBase读写的几种方式(二)spark篇 https://www.cnblogs.com/swordfall/p/10517177.html 分类: HBase undefined 1. HBase ...
随机推荐
- Linux从入门到进阶全集——【第十四集:Shell基础命令】
1,Shell就是命令行执行器 2,作用:将外层引用程序的例如ls ll等命令进行解释成01表示的二进制代码给内核,从而让硬件执行:硬件的执行结果返回给shell,shell解释成我们能看得懂的代码返 ...
- 在VUE-CLI 3下的第一个Element-ui项目(菜鸟专用)
vue-cli3.0使用及配置 (https://www.cnblogs.com/xzqyun/p/10779891.html ) 以上是 vue-cli3.0使用及配置 这里我们来引用基于v ...
- 【ABP.Net】1.创建项目&介绍框架结构
既然已经打开这个页面了,我就不介绍什么是ABP了.哈哈哈,如果想知道,请移驾.反正我是不说. 1.首先打开https://aspnetboilerplate.com/Templates 下载所需要的A ...
- input里面的submit鼠标按钮属性cursor
属性cursor 属性值: pointer 小手 move 移动 help 帮助 wait 等待
- ORM之SQLALchemy
今天来聊一聊 Python 的 ORM 框架 SQLAlchemy SQLAlchemy 没有 Django 的 Models 好用!因为models是Django自带的ORM框架,也正是因为是Dja ...
- BZOJ.4212.神牛的养成计划(Trie 可持久化Trie)
BZOJ 为啥hzw的题也是权限题啊 考虑能够匹配\(s1\)这一前缀的串有哪些性质.对所有串排序,能发现可以匹配\(s1\)的是一段区间,可以建一棵\(Trie\)求出来,设为\([l,r]\). ...
- 06flask_migrate
1,flask-migrate介绍: 因为采用db.create_all()在后期修改字段的时候不会自动的映射到数据库中,必须删去表,然后运行 db.create_all()才会重新映射,这样不符合我 ...
- 下载Spring4.3.18.RELEASE的官方文档
wget -p --page-requisites --convert-links -P /root/spring https://docs.spring.io/spring/docs/4.3.18. ...
- BZOJ3592 : Architext
首先特判多边形面积$=0$的情况,此时内部没有点,答案只会在顶点处取到. 对于面积$>0$的情况,离线询问,将所有多边形合在一起得到平面图,然后求出对偶图,那么每条多边形边的两侧分别对应对偶图中 ...
- git 提交代码到库
今天用git commit -m “注释”提交的时候,注释写错了,于是各种查资料开始了和git bash vim的纠缠...(网上的资料我真是没操作成功,不过最后还是摸索出来了) 首先 使用 git ...