
为什么使用 LSTM 训练速度远大于 SimpleRNN?
今天试验 TensorFlow 2.x , Keras 的 SimpleRNN 和 LSTM,发现同样的输入、同样的超参数设置、同样的参数规模,LSTM 的训练时长竟然远少于 SimpleRNN。
模型定义:
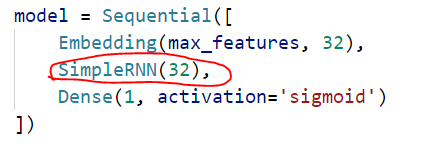
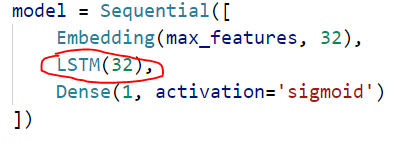
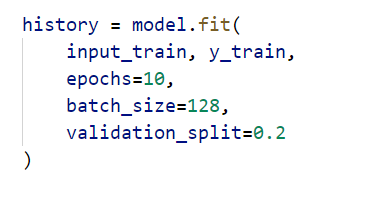
训练参数都这样传入:
我们知道,LSTM 是修正了的 SimpleRNN(我随意想出来的词,“修正”),或者说,是在 SimpleRNN 基础之上又添加了别的措施使模型能考虑到超长序列的标记之间的依赖。 缓解了梯度消失和梯度爆炸的问题。
所以,LSTM 比 SimpleRNN 是多了很多参数矩阵的,且每一步也多了一些计算。而训练过程既有前向,又有反向,不管哪个过程,理论上 LSTM都是比SimpleRNN要花更多时间的,那么为什么我在使用 TensorFlow with Keras 时会出现相反的情况呢?
训练情况(第一个 epoch):
SimpleRNN 的

LSTM的
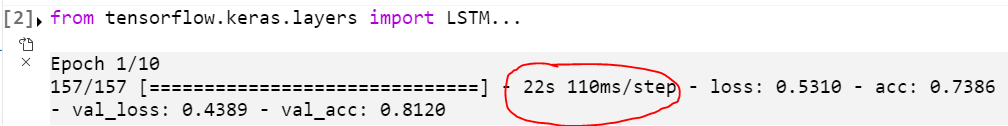
原因,就在于:版本。
按住 Ctrl,点击两个类名 SimpleRNN 和 LSTM,进入定义的模块,会发现 from tensorflow.keras.layers import SimpleRNN 的 SimpleRNN定义所在的模块分别是这样的
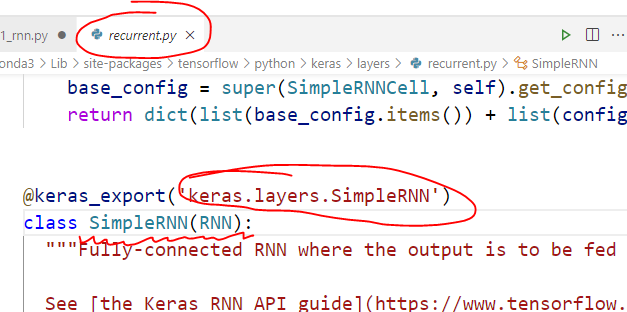
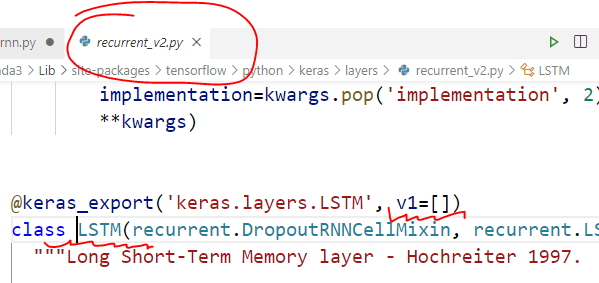
懂了,SimpleRNN 是 TensorFlow 1.xx 的东西,而这个 LSTM 是 TensorFlow 2.xx 的东西,肯定内部做了优化,反正二者一开始就不是一个起跑线上的东西。虽然我们写代码表面上都是from tensorflow.kears.layers 里 import 的,但是这种模块导入真的不能证明他们是放在同一个模块里定义的,因为导入是可以导来导去的,有的一个 import 就找到了它的定义,有的需要经过好几次 import 的传递,就像是个链,从我们的源文件一直到达最终定义的模块,这个 LSTM 隐藏的就很深(或者封装的很好(皮))。
要找到 这个 SimpleRNN 的 counterpart,就须使用 tensorflow.compat.v1.keras.layers.LSTM,找到它,发现
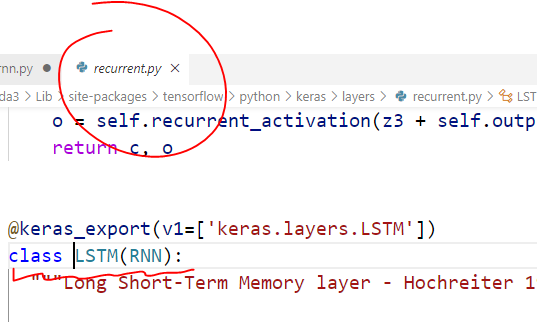
这就与上述 SimpleRNN 所在同一个模块了。
试验训练一下。

果然,比 SimpleRNN 慢得多,合理了。舒服了。
-------------------------------------------
我发现我真的好无聊,整天搞这些没用的。
抓主要矛盾,抓主要矛盾,主要矛盾!!!
下次一定 :)
为什么使用 LSTM 训练速度远大于 SimpleRNN?的更多相关文章
- 进程物理内存远大于Xmx的问题分析
问题描述 最近经常被问到一个问题,”为什么我们系统进程占用的物理内存(Res/Rss)会远远大于设置的Xmx值”,比如Xmx设置1.7G,但是top看到的Res的值却达到了3.0G,随着进程的运行,R ...
- [转载]Java进程物理内存远大于Xmx的问题分析
进程物理内存远大于Xmx的问题分析 问题描述 最近经常被问到一个问题,”为什么我们系统进程占用的物理内存(Res/Rss)会远远大于设置的Xmx值”,比如Xmx设置1.7G,但是top看到的Res的值 ...
- iGear 用了这个小魔法,模型训练速度提升 300%
一个高精度AI模型离不开大量的优质数据集,这些数据集往往由标注结果文件和海量的图片组成.在数据量比较大的情况下,模型训练周期也会相应加长.那么有什么加快训练速度的好方法呢? 壕气的老板第一时间想到的通 ...
- 实例演示 C# 中 Dictionary<Key, Value> 的检索速度远远大于 hobbyList.Where(c => c.UserId == user.Id)
前言 我们知道,有时候在一些项目中,为了性能,往往会一次性加载很多条记录来进行循环处理(备注:而非列表呈现).比如:从数据库中加载 10000 个用户,并且每个用户包含了 20 个“爱好”,在 Wi ...
- C++,1....n中随机等概率的输出m个不重复的数(假设n远大于m)。
#include <stdlib.h> #include <time.h> knuth(int n, int m) { srand((unsigned )); ; i < ...
- 高性能网络编程(一)----accept建立连接
编写服务器时,许多程序员习惯于使用高层次的组件.中间件(例如OO(面向对象)层层封装过的开源组件),相比于服务器的运行效率而言,他们更关注程序开发的效率,追求更快的完成项目功能点.希望应用代码完全不关 ...
- Linux Cache Mechanism Summary(undone)
目录 . 缓存机制简介 . 内核缓存机制 . 内存缓存机制 . 文件缓存机制 . 数据库缓存机制 1. 缓存机制简介 0x1: 什么是缓存cache 在计算机整个领域中,缓存(cache)这个词是一个 ...
- D. Powerful array 莫队算法或者说块状数组 其实都是有点优化的暴力
莫队算法就是优化的暴力算法.莫队算法是要把询问先按左端点属于的块排序,再按右端点排序.只是预先知道了所有的询问.可以合理的组织计算每个询问的顺序以此来降低复杂度. D. Powerful array ...
- 高性能网络编程1----accept建立连接
转 http://taohui.org.cn/tcpperf1.html 陶辉 taohui.org.cn 回到应用层,往往只需要调用类似于accept的API就可以建立TCP连接.建立连接的流程大 ...
随机推荐
- Docker之tomcat安装与部署项目
docker安装tomcat docker pull tomcat:8.5 等待... (1)正常的方式启动tomcat docker run -d --name tomcat -p 80:808 ...
- 深入 Go 语言 defer 实现原理
转载请声明出处哦~,本篇文章发布于luozhiyun的博客: https://www.luozhiyun.com/archives/523 本文使用的go的源码 1.15.7 介绍 defer 执行规 ...
- GO学习-(17) Go语言基础之反射
Go语言基础之反射 本文介绍了Go语言反射的意义和基本使用. 变量的内在机制 Go语言中的变量是分为两部分的: 类型信息:预先定义好的元信息. 值信息:程序运行过程中可动态变化的. 反射介绍 反射是指 ...
- GO语言异常处理02---返回错误
package main import ( "errors" "fmt" "math" ) /*计算圆面积,同时返回[结果-错误对]*/ f ...
- 十四、.net core(.NET 6)搭建ElasticSearch(ES)系列之给ElasticSearch添加SQL插件和浏览器插件
给ES添加SQL插件的方法: 下载SQL插件地址:https://github.com/NLPchina/elasticsearch-sql 当前最新的是7.12版本,我的ES是7.13版本,暂且将 ...
- 快速人体姿态估计:CVPR2019论文阅读
快速人体姿态估计:CVPR2019论文阅读 Fast Human Pose Estimation 论文链接: http://openaccess.thecvf.com/content_CVPR_201 ...
- 机器学习PAL基本概念
机器学习PAL基本概念 本文介绍PAI-Studio.PAI-DSW及PAI-EAS的基本概念. PAI-Studio PAI-DSW PAI-EAS
- MindSpore整体架构介绍
MindSpore整体架构介绍 MindSpore框架架构总体分为MindSpore前端表示层.MindSpore计算图引擎和MindSpore后端运行时三层. MindSpore前端表示层(Mind ...
- 用java实现图书管理系统。
图书管理系统. 一.项目设计到的知识 1.MVC设计模式思想(分包) >项目分包 >MVC简单介绍 2.GUI(图形化界面) 3.JDBC连接MySql数据库 4.I/O流 5.面向对象思 ...
- Redis 5种数据结构及对应使用场景
本文案例收录在 https://github.com/chengxy-nds/Springboot-Notebook 也当过面试官,面试过不少应聘者,因为是我自己招人自己用,所以我不会看应聘者造火箭的 ...