
深度学习模型训练技巧 Tips for Deep Learning
一、深度学习建模与调试流程
先看训练集上的结果怎么样(有些机器学习模型没必要这么做,比如决策树、KNN、Adaboost 啥的,理论上在训练集上一定能做到完全正确,没啥好检查的)
Deep Learning 里面过拟合并不是首要的问题,或者说想要把神经网络训练得好,至少先在训练集上结果非常好,再考虑那些改善过拟合的技术(BN,Dropout 之类的)。否则的话回去检查三个 step 哪里有问题。
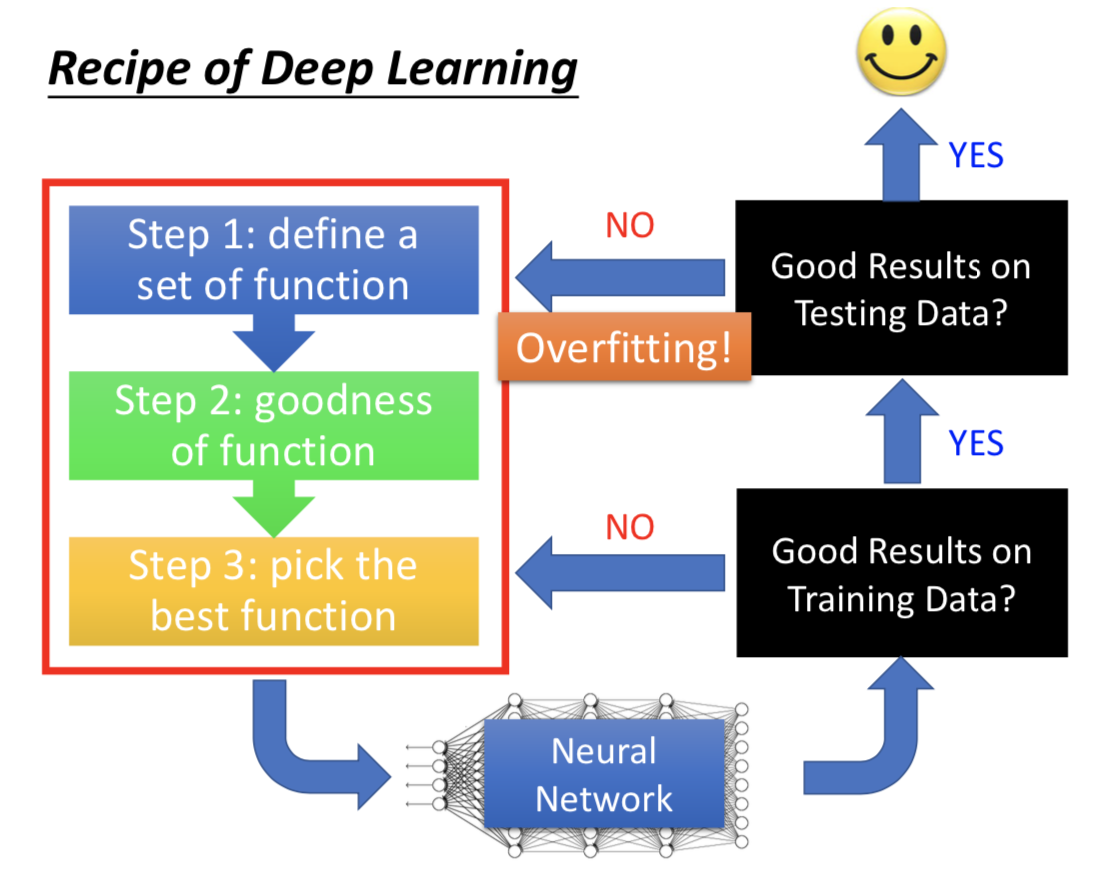
Deep Learning 中的方法为了解决两个主要问题而提出:1.训练集做得不好;2.训练集做得好,测试集做得不好
实际应用的时候搞清楚自己面对的问题,选择对应的技巧。
二、激活函数
1. sigmoid
梯度消失:网络很深的时候,靠近输入的 hidden layers 的梯度对损失函数影响很小, 参数更新的就很慢;靠近输出的情况反之。前面几层的参数都还没怎么更新的时候就收敛了。
原因也比较简单,反向传播的时候每经过一层,都会乘上小于 1 的数(sigmoid 函数 会把输入压到 0~1 之间),结果就越来越衰减。
早期用 RBM ,先训练好前面几层。
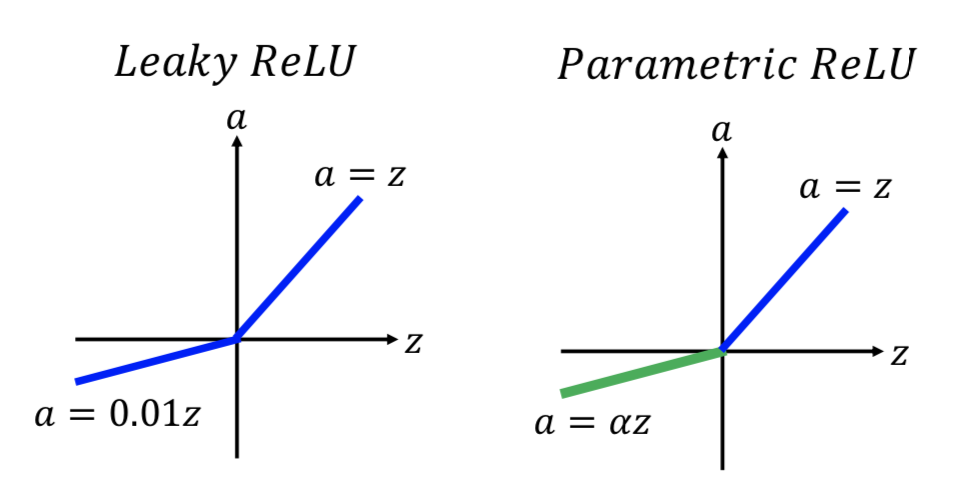
2. ReLU
3. maxout network
每个神经元的激活函数的具体形式,是可以学习来的(不一定非得像 ReLU 那样在原点分段):
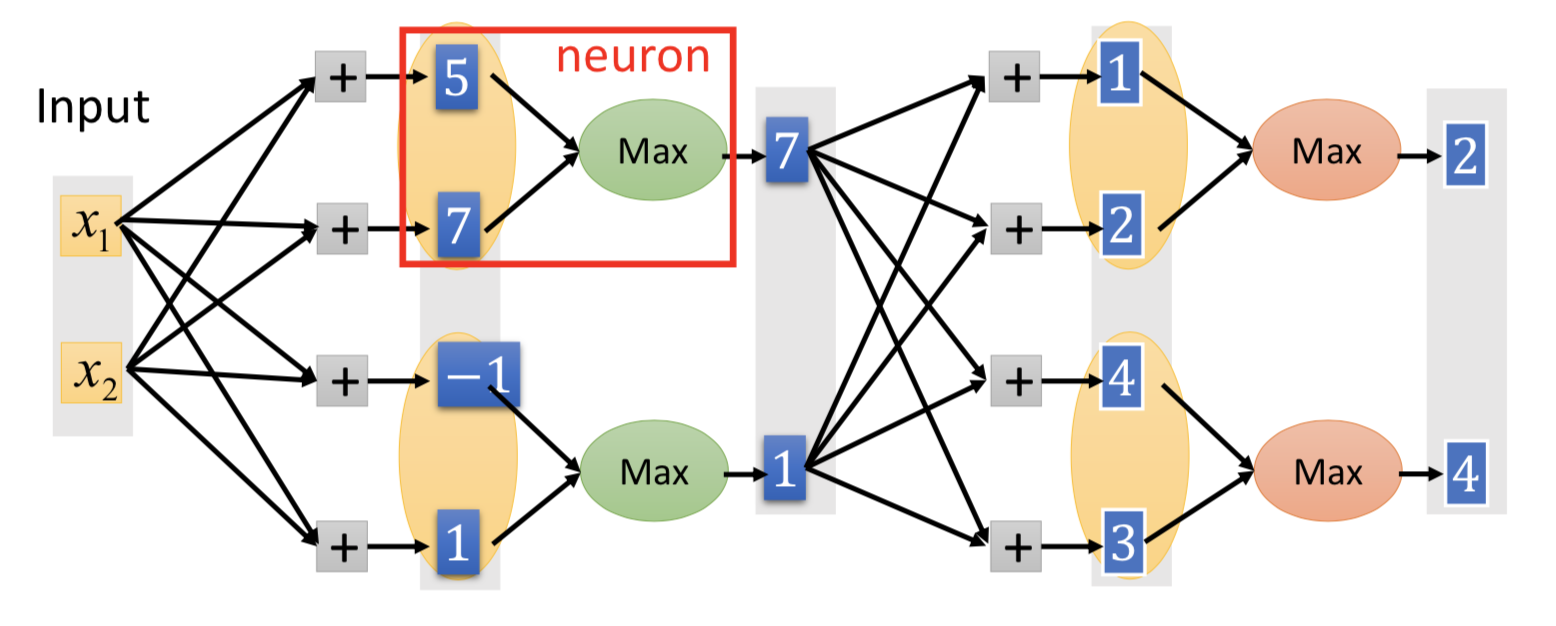
哪些神经元要被 group 起来是事先决定的(比如随机2个或者3个一组之类的,几个一组也可以作为一个参数来学习)。
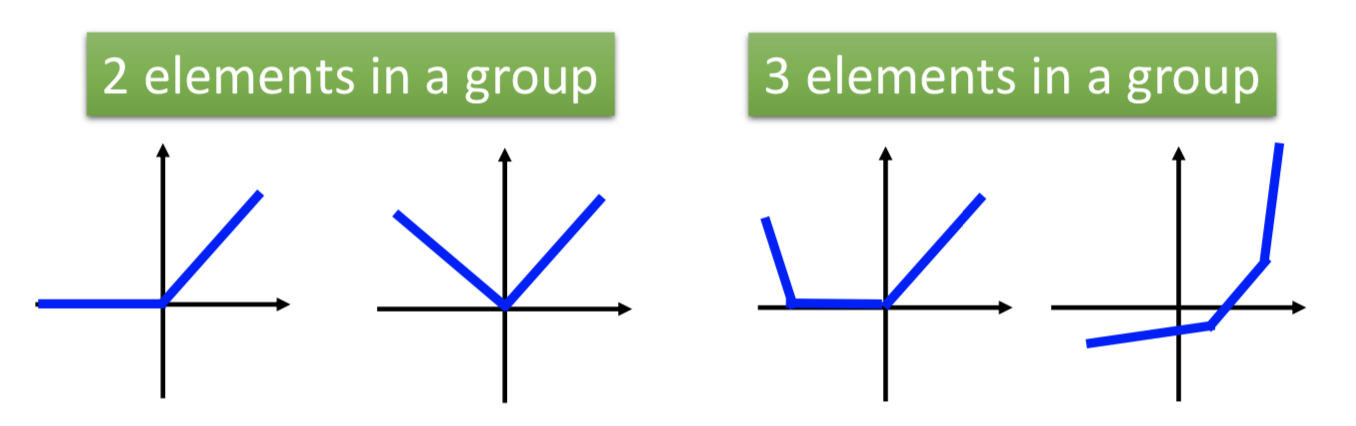
ReLU 就是特殊情况下的 maxout ;但 maxout 可以实现更多可能的激活函数(具体是什么样的函数,根本上是由参数 w 决定的)。
三、梯度下降的改进
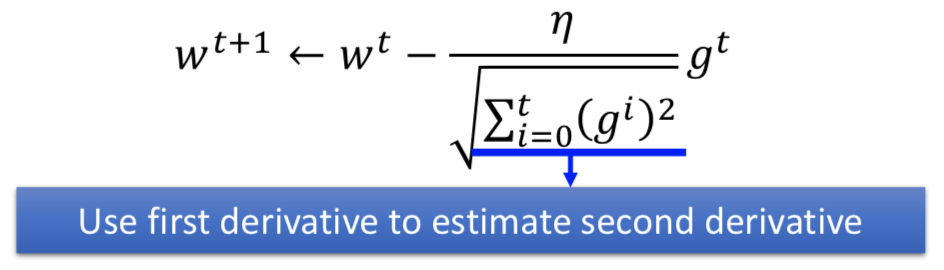
1. Adagrad
在梯度下降中已经总结过,在不同方向上需要不同的学习率。
学习率时间衰减 + 从开始到当前时刻的梯度平方和求平均来估计二阶微分的大小趋势
2. RMSProp
error surface 非常复杂,即使在同一个方向上,学习率也需要不断调整。进阶版 Adagrad,动态调整学习率。
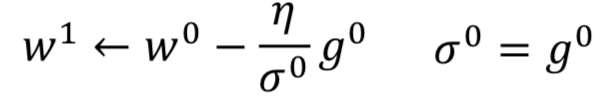
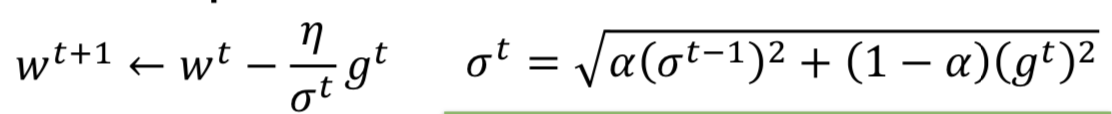
在 decaying 累计的先前梯度,通过调整alpha的大小,来选择是考虑先前的梯度(t 时刻之前的累积)多一些,还是当前的梯度(t时刻的)多一些
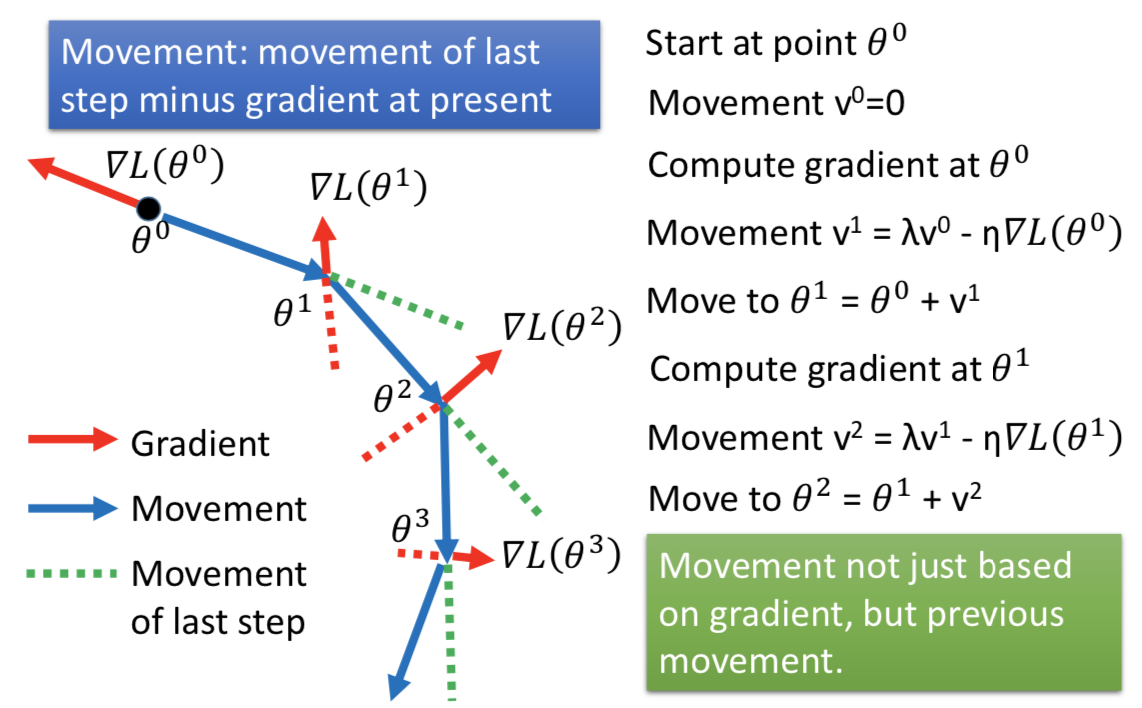
3. Momentum
解决一点 local minima 和 plateau 的问题
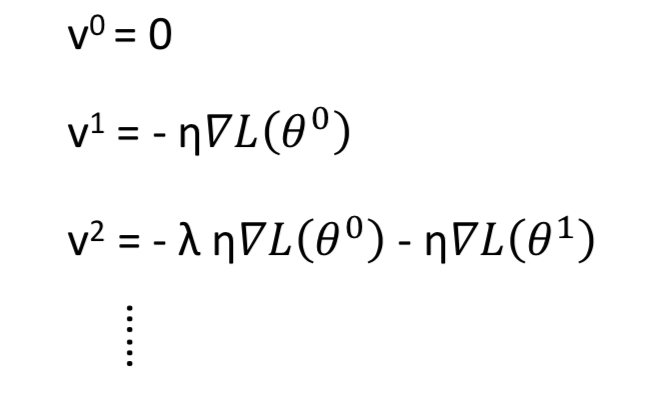
4. Adam
RMSProp + Momentum,利用梯度的一阶矩估计和二阶矩估计动态调整每个参数的学习率。
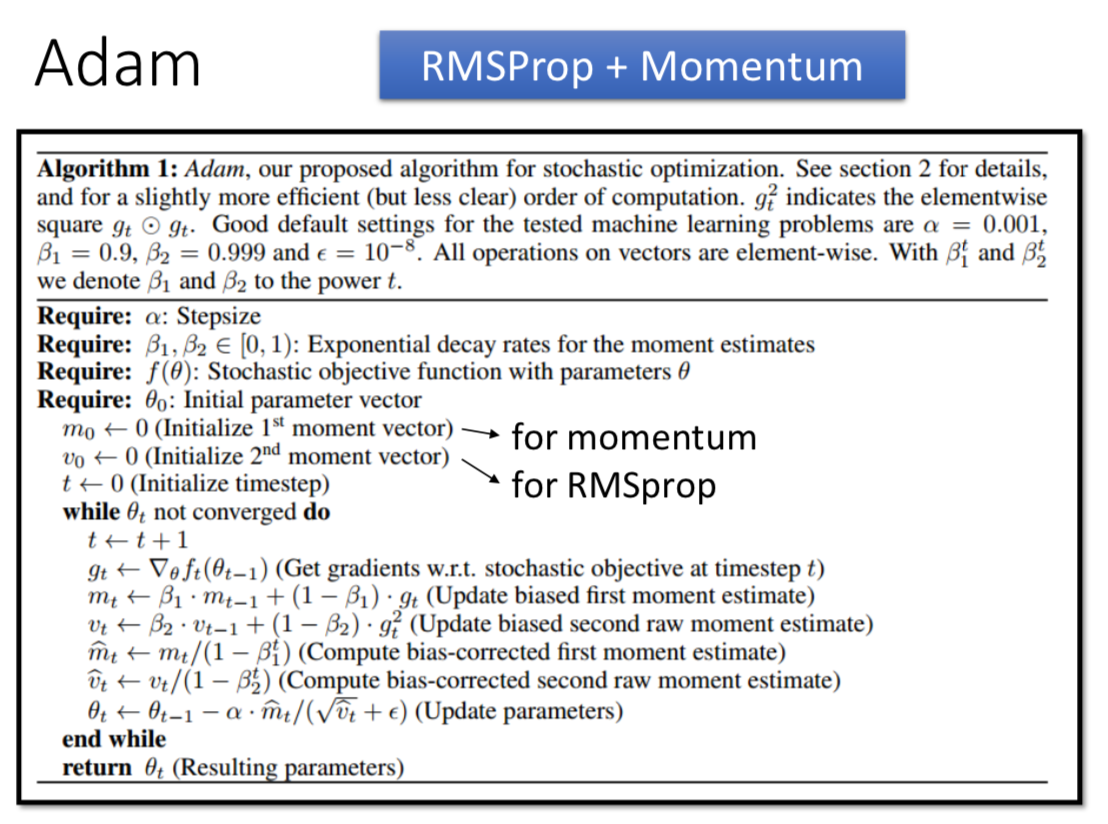
其中,在迭代初始阶段,mt 和 vt 有一个向初值的偏移(过多的偏向了 0),因此可以对一阶和二阶动量做偏置校正 (bias correction),这样每次迭代学习率都有一个确定的范围,参数更新比较平稳。
四、正则化
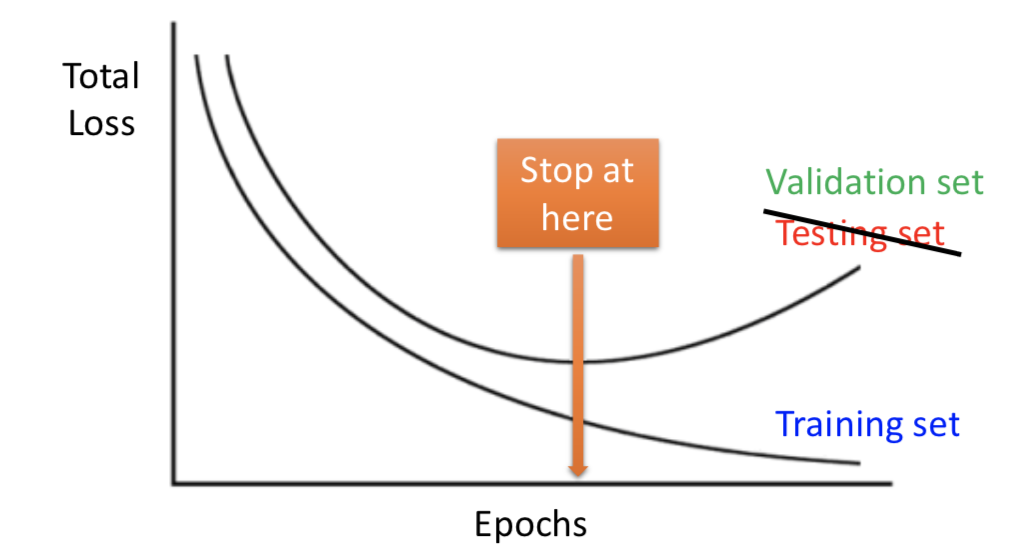
1. Early Stopping
机器学习中比较常见的技巧
2. Dropout
神经网络中才会用
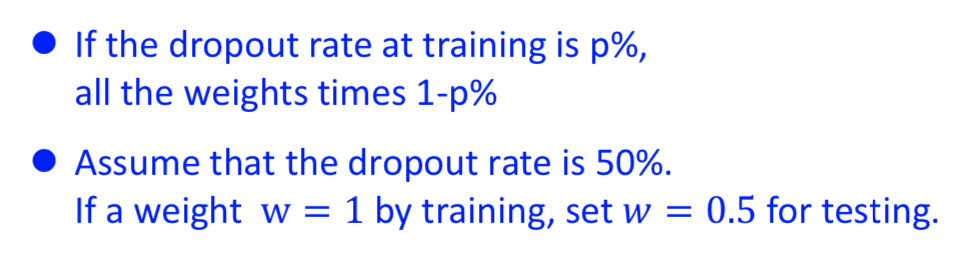
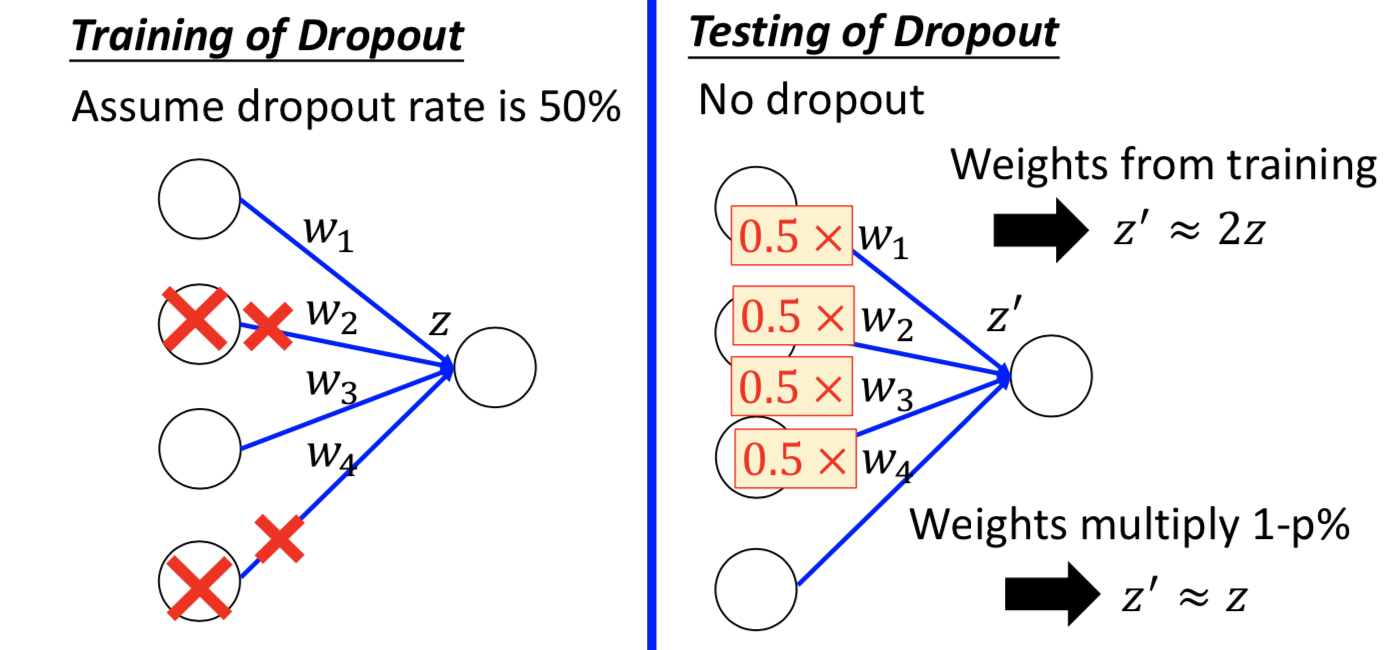
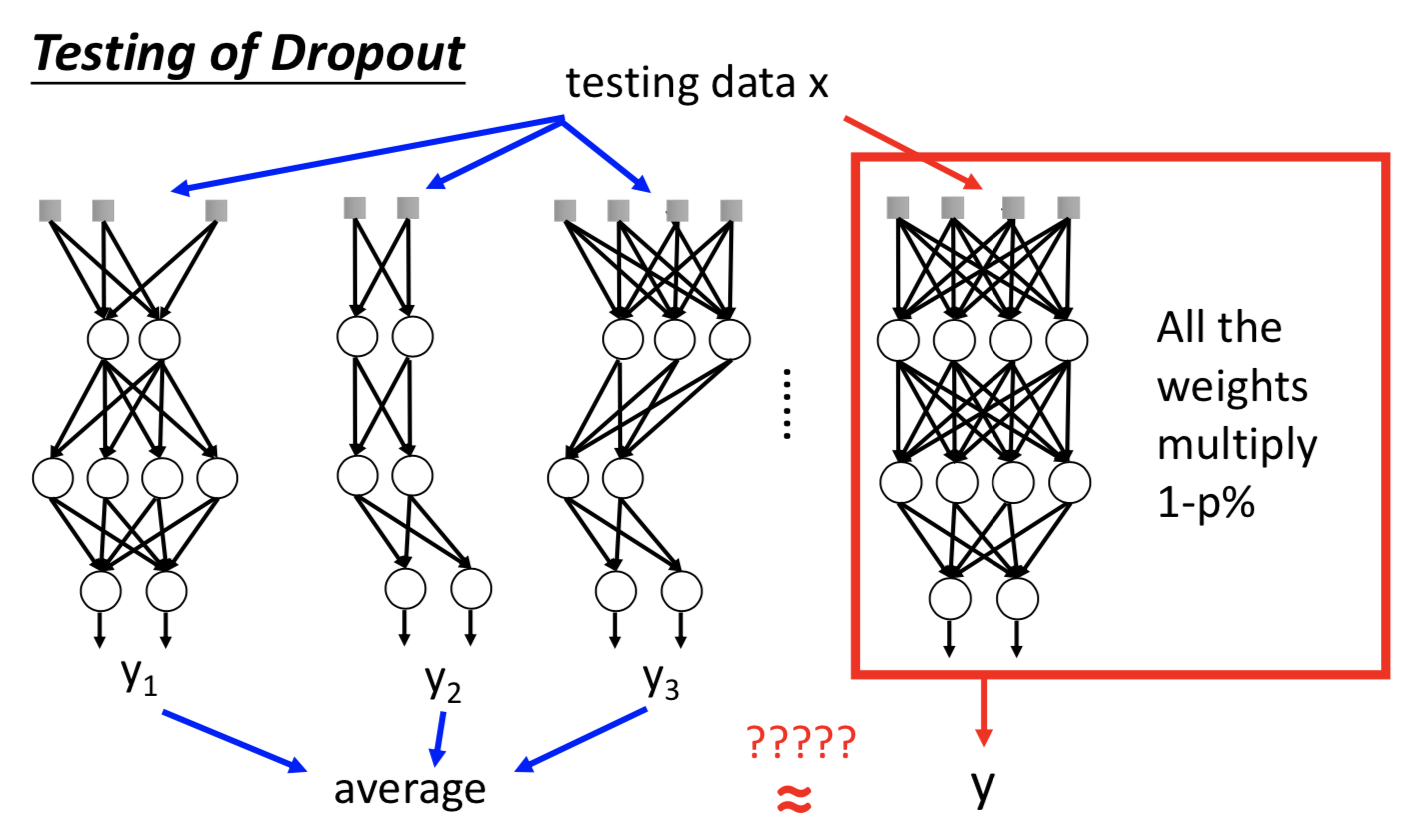
随机 kill 掉一定比例的神经元。测试的时候不做,而且还要补偿参数。
深度学习模型训练技巧 Tips for Deep Learning的更多相关文章
- 深度学习模型调优方法(Deep Learning学习记录)
深度学习模型的调优,首先需要对各方面进行评估,主要包括定义函数.模型在训练集和测试集拟合效果.交叉验证.激活函数和优化算法的选择等. 那如何对我们自己的模型进行判断呢?——通过模型训练跑代码,我们可以 ...
- AI佳作解读系列(一)——深度学习模型训练痛点及解决方法
1 模型训练基本步骤 进入了AI领域,学习了手写字识别等几个demo后,就会发现深度学习模型训练是十分关键和有挑战性的.选定了网络结构后,深度学习训练过程基本大同小异,一般分为如下几个步骤 定义算法公 ...
- 深度学习与计算机视觉(11)_基于deep learning的快速图像检索系统
深度学习与计算机视觉(11)_基于deep learning的快速图像检索系统 作者:寒小阳 时间:2016年3月. 出处:http://blog.csdn.net/han_xiaoyang/arti ...
- TensorFlow和深度学习入门教程(TensorFlow and deep learning without a PhD)【转】
本文转载自:https://blog.csdn.net/xummgg/article/details/69214366 前言 上月导师在组会上交我们用tensorflow写深度学习和卷积神经网络,并把 ...
- TensorFlow和深度学习新手教程(TensorFlow and deep learning without a PhD)
前言 上月导师在组会上交我们用tensorflow写深度学习和卷积神经网络.并把其PPT的參考学习资料给了我们, 这是codelabs上的教程:<TensorFlow and deep lear ...
- 深度学习FPGA实现基础知识10(Deep Learning(深度学习)卷积神经网络(Convolutional Neural Network,CNN))
需求说明:深度学习FPGA实现知识储备 来自:http://blog.csdn.net/stdcoutzyx/article/details/41596663 说明:图文并茂,言简意赅. 自今年七月份 ...
- 用 Java 训练深度学习模型,原来可以这么简单!
本文适合有 Java 基础的人群 作者:DJL-Keerthan&Lanking HelloGitHub 推出的<讲解开源项目> 系列.这一期是由亚马逊工程师:Keerthan V ...
- 利用 TFLearn 快速搭建经典深度学习模型
利用 TFLearn 快速搭建经典深度学习模型 使用 TensorFlow 一个最大的好处是可以用各种运算符(Ops)灵活构建计算图,同时可以支持自定义运算符(见本公众号早期文章<Tenso ...
- 在NLP中深度学习模型何时需要树形结构?
在NLP中深度学习模型何时需要树形结构? 前段时间阅读了Jiwei Li等人[1]在EMNLP2015上发表的论文<When Are Tree Structures Necessary for ...
随机推荐
- iOS组件化开发一pod库包含MRC的文件处理(五)
在做项目的过程中,建立了一个私有pod库,在这个库中存在mrc类文件这个时候如果在使用了arc的工程中引用这个pod的工程中手动设置当然也可以就是费时费力.现在我们来看看如何在私有库配置文件里配置自动 ...
- python接口自动化(二十九)--html测试报告通过邮件发出去——上(详解)
简介 前边几篇,已经教小伙伴们掌握了如何生成HTML的测试报告,那么生成测试报告,我们也不能放在那里不管了,这样即使你报告在漂亮,领导也看不到.因此如果想向领导汇报工作,不仅需要提供更直观的测试报告. ...
- Hadoop现在怎么样了?
之前我们提到大数据的时候就会提到Hadoop,Hadoop是大数据的基础框架,是大数据技术的代表.提到HDFS.MapReduce.Yarn,提到HBase.Hive.TEZ等Hadoop生态圈中的一 ...
- [转载]nginx负载均衡+keepalived三主(多主)配置
nginx负载均衡+keepalived三主(多主)配置 1.实验环境,实现目标三台主机分别配置nginx负载均衡对后端多台主机做转发,同时配置keepalived实现HA,保证任意主机出现故障时其他 ...
- MFC在一个工程中启动其他工程的exe文件
说明:有的时候把两个工程合并,但是偷懒不想在工程中添加代码,所以想到了这个办法,仅限偷懒哈哈哈哈 方法:新建一个主程序,在主程序的界面中添加按钮,在按钮的程序代码中添加以下语句: void CMain ...
- 利用openpyxl模块处理excel表格
一.选取表格中的内容创建图表 1.openpyxl支持利用工作表中单元格的数据,创建条形图.折线图.散点图等.步骤如下: 1).从一个矩形区域选择的单元格,创建一个Reference对象. 2).通过 ...
- WePY的脱胎换骨
对于前端来说,尤其是开发小程序的前端来说,WePY框架一定不陌生,他是一种小程序开发框架.而且是属于类Vue风格,掌握Vue再来学习WePY学习成本极低. 今天为啥要写这篇文章呢,因为在复习WePY时 ...
- java高并发系列 - 第17天:JUC中的循环栅栏CyclicBarrier常见的6种使用场景及代码示例
这是java高并发系列第17篇. 本文主要内容: 介绍CyclicBarrier 6个示例介绍CyclicBarrier的使用 对比CyclicBarrier和CountDownLatch Cycli ...
- GCC 编译多个文件
今天写数据结构的example,定义了3个文件:lish.h list.c main.c list.h是list.c的头文件,mian.c中对list.h进行了引用.代码如下: list.h 1 #i ...
- linux初学者-iscsi篇
linux初学者-iscsi篇 之前介绍过网络文件共享系统NFS和CIFS.在系统中,设备也是可以共享的,这就是iSCSI,它可以用来建立和管理IP存储设备.主机和客户机等之间的相互 ...