
MR案例:多文件输出MultipleOutputs
问题描述:现有 ip-to-hosts.txt 数据文件,文件中每行数据有两个字段:分别是ip地址和该ip地址对应的国家,以'\t'分隔。要求汇总不同国家的IP数,并以国家名为文件名将其输出。解读:MultipleOutputs类
测试数据:ip-to-hosts.txt
18.217.167.70 United States

206.96.54.107 United States

196.109.151.139 Mauritius

174.52.58.113 United States

142.111.216.8 Canada
代码实现:
package country;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.mapreduce.lib.output.LazyOutputFormat;

import org.apache.hadoop.mapreduce.lib.output.MultipleOutputs;

import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

public class Ip2Hosts {

    public static void main(String[] args) throws Exception {

        //指定输入输出路径

        args =new String[] {"hdfs://10.16.17.182:9000/test/in/ip-to-hosts.txt","hdfs://10.16.17.182:9000/test/out/0821/09"};

        System.exit(run(args));

    }

    public static int run(String[] args) throws Exception {

        Job job = Job.getInstance(new Configuration());

        job.setJarByClass(Ip2Hosts.class);

        job.setMapperClass(IPCountryMapper.class);

        job.setReducerClass(IPCountryReducer.class);

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(IntWritable.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        FileInputFormat.addInputPath(job, new Path(args[0]));

        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        /**

         * 输出 08 和 09 需要调用此设置,07 就需要注释掉

         */
        MultipleOutputs.addNamedOutput(job,"abc",TextOutputFormat.class,Text.class,IntWritable.class);

        //通过此配置可以不再产生默认的空文件【part-*-00000】

        LazyOutputFormat.setOutputFormatClass(job, TextOutputFormat.class);

        return job.waitForCompletion(true) ? 1 : 0;

    }

    //map阶段

    public static class IPCountryMapper    extends Mapper<LongWritable, Text, Text, IntWritable> {

        @Override

        protected void map(LongWritable key, Text value,Context context) throws IOException, InterruptedException {

            String[] splited = value.toString().split("\t");

            context.write(new Text(splited[1]), new IntWritable(1));

        }

    }

    //reduce阶段

    public static class IPCountryReducer extends Reducer<Text, IntWritable, Text, IntWritable> {

        //1.定义多文件输出类MultipleOutputs

        private MultipleOutputs<Text, IntWritable> mos;

        @Override

        protected void setup(Context context

                ) throws IOException, InterruptedException {

            //2.MultipleOutputs初始化

            mos = new MultipleOutputs<Text, IntWritable>(context);

        }

        @Override

        protected void reduce(Text key, Iterable<IntWritable> values, Context context

                ) throws IOException, InterruptedException {

            int total = 0;

            for(IntWritable value: values) {

                total += value.get();

            }

        //3.调用MultipleOutputs中的write()方法
            //07-输出

            mos.write(/*"abc",*/ key, new IntWritable(total),key.toString());

            //08-输出

            mos.write("abc", key, new IntWritable(total)/*,key.toString()*/);

            //09-输出

            mos.write("abc", key, new IntWritable(total),key.toString());

        }

        @Override

        protected void cleanup(Context context

                ) throws IOException, InterruptedException {

            //4.关闭流资源

            mos.close();

        }

    }

}
代码解读:
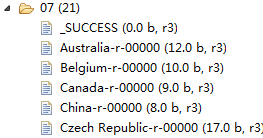
1).输出-07所调用的方法和对应的输出结果:
/**

 * @ 输出的key类型

 * @ 输出的value类型

 * @ 输出的基路径,实际输出结果为:'基路径-r-00000'

 */

MultipleOutputs.write(KEYOUT key, VALUEOUT value, String baseOutputPath)
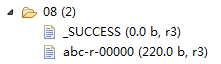
2).输出-所调用的方法和对应的输出结果:
/**

 * @ 自定义的输出.对于不指定'基路径',则结果为:'自定义的输出-r-00000'

 * @ 输出的key类型

 * @ 输出的value类型

 */

MultipleOutputs.write(String namedOutput, K key, V value)
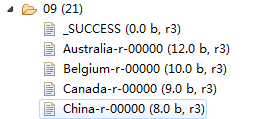
 3).输出-09所调用的方法和对应的输出结果:
/**

 * @ 自定义的输出.

 * @ 输出的key类型

 * @ 输出的value类型

 * @ 输出的基路径,指定输出'基路径',则结果为:'基路径-r-00000'

 */

MultipleOutputs.write(String namedOutput, K key, V value, String baseOutputPath)
用法总结:
- 在Mapper或Reducer类中创建 MultipleOutputs 成员变量 mos
- 在setup()方法中初始化 mos 变量,
- 在map()或reduce()方法中调用 mos.write() 方法输出数据,代替context.write()
- mos.write() 方法具有三个重载,对于 输出-08-09 还需在Job配置中指定输出格式
- 在cleanup()方法中调用 mos.close() 方法关闭输出流
MR案例:多文件输出MultipleOutputs的更多相关文章
- MR案例:小文件处理方案
HDFS被设计来存储大文件,而有时候会有大量的小文件生成,造成NameNode资源的浪费,同时也影响MapReduce的处理效率.有哪些方案可以合并这些小文件,或者提高处理小文件的效率呢? 1). 所 ...
- MR案例:Reduce-Join
问题描述:两种类型输入文件:address(地址)和company(公司)进行一对多的关联查询,得到地址名(例如:Beijing)与公司名(例如:Beijing JD.Beijing Red Star ...
- MR案例:倒排索引
1.map阶段:将单词和URI组成Key值(如“MapReduce :1.txt”),将词频作为value. 利用MR框架自带的Map端排序,将同一文档的相同单词的词频组成列表,传递给Combine过 ...
- mapreduce多文件输出的两方法
mapreduce多文件输出的两方法 package duogemap; import java.io.IOException; import org.apache.hadoop.conf ...
- hadoop多文件输出
现实环境中,经常遇到一个问题就是想使用多个Reduce,可是迫于setup和cleanup在每个Reduce中会调用一次,仅仅能设置一个Reduce,无法是实现负载均衡. 问题,假设要在reduce中 ...
- JAVA实用案例之文件导出(JasperReport踩坑实录)
写在最前面 想想来新公司也快五个月了,恍惚一瞬间. 翻了翻博客,因为太忙,也有将近五个多月没认真总结过了. 正好趁着今天老婆出门团建的机会,记录下最近这段时间遇到的大坑-JasperReport. 六 ...
- MR案例:定制InputFormat
数据输入格式 InputFormat类用于描述MR作业的输入规范,主要功能:输入规范检查(比如输入文件目录的检查).对数据文件进行输入切分和从输入分块中将数据记录逐一读取出来.并转化为Map的输入键值 ...
- Java IO流操作(III)——File类&案例一:输出制定目录下所有java文件名(包含子目录)&案例二:删除指定的目录(包含子目录)
1. File常用的构造 File file = new File("字符串路径"); File f = new File("D:\\a\\b.txt"); F ...
- 使用log4j配置不同文件输出不同内容
敲代码中很不注意写日志,虽然明白很重要.今天碰到记录日志,需要根据内容分别输出到不同的文件. 参考几篇文章: 感觉最详细:http://blog.csdn.net/azheng270/article/ ...
随机推荐
- Python: 使用pip升级所有包
pip 当前内建命令并不支持升级所有已安装的Python模块. 列出当前安装的包: pip list 列出可升级的包: pip list --outdate 升级一个包: pip install ...
- iOS 内存管理(转载)
N久没维护这个博客了,从开始接触编程到现在已经三四年了.不太习惯写博客,这应该是个不好的习惯.所以从哪哪天开始,我得改变自己 (: . 文采不太好,因此很多的文章都会借鉴他人的,但是我一 ...
- C/C++编译过程
C/C++编译过程 C/C++编译过程主要分为4个过程 1) 编译预处理 2) 编译.优化阶段 3) 汇编过程 4) 链接程序 一.编译预处理 (1)宏定义指令,如#define Name Token ...
- the ONLY_FULL_GROUP_BY SQL mode is enabled (which it is by default) 用户变量
MySQL :: MySQL 8.0 Reference Manual :: 5.1.11 Server SQL Modes https://dev.mysql.com/doc/refman/8.0/ ...
- python基础-第九篇-9.1初了解Python线程、进程、协程
了解相关概念之前,我们先来看一张图 进程: 优点:同时利用多个cpu,能够同时进行多个操作 缺点:耗费资源(重新开辟内存空间) 线程: 优点:共享内存,IO操作时候,创造并发操作 缺点:抢占资源 通过 ...
- setup.py
from distutils.core import setup # 使用说明 # 执行以下命令 # python3 setup.py build # python3 setup.py sdist(这 ...
- (1.3.1)连接安全(连接实例与网络协议及TDS端点)
连接安全是sql server安全配置的第1道防线,它保证只有许可的客户端能够连接sql server,而且可以限制连接可用的通道(各种网络协议). 1.连接到sql server实例 sql ser ...
- HTML5开源RPG游戏引擎lufylegendRPG 0.1发布
一,小小开篇 首先不得不先介绍一下这个引擎: lufylegendRPG是lufylegend的拓展引擎,使用它时,需要引入lufylegend.同时您也需要了解lufylegend语法,这样才能 ...
- PHP面试专用笔记精简版
[PHP笔记] 1.require 遇到即包含文件,require_once 只包含一次.require 遇到错误会终止,一般放在程序的最前面:include遇到错误会继续执行,一般放在流程控制语句中 ...
- module_init module_exit
像你写C程序需要包含C库的头文件那样,Linux内核编程也需要包含Kernel头文件,大多的Linux驱动程序需要包含下面三个头文件:#include <linux/init.h>#inc ...