
【论文笔记】YOLOv4: Optimal Speed and Accuracy of Object Detection
论文地址:https://arxiv.org/abs/2004.10934v1
github地址:https://github.com/AlexeyAB/darknet
摘要:
有很多特征可以提高卷积神经网络(CNN)的准确性。需要在大型数据集上对这些特征的组合进行实际测试,并需要对结果进行理论证明来验证这些特征的有效性。 某些特征仅在某些模型上运行,并且仅在某些问题上运行,或者仅在小型数据集上运行; 而某些特征(例如批归一化和残差连接)适用于大多数模型,任务和数据集。 我们假设此类通用特征包括加权残差连接(WRC),跨阶段部分连接(CSP),交叉小批量标准化(CmBN),自对抗训练(SAT)和Mish激活。 我们使用以下新特征:WRC,CSP,CmBN,SAT,Mish激活,马赛克数据增强,CmBN,DropBlock正则化和CIoU丢失,并结合其中的一些特征来实现最先进的结果:在MS COCO数据集上,用Tesla V100Tesla V100以65 FPS的实时速度获得43.5%AP(65.7%AP50) 。
1.介绍:
大多数基于CNN的物体检测器仅适用于推荐系统。 例如,通过慢速精确模型执行的城市摄像机搜索免费停车位,而汽车碰撞警告与快速不精确模型有关。 提高实时物体检测器的精度不仅可以将它们用于提示生成推荐系统,还可以用于独立的过程管理和减少人工输入。 常规图形处理单元(GPU)上的实时对象检测器允许以可承受的价格对其进行操作。 最精确的现代神经网络不能实时运行,需要使用大量GPU用大min-batch-size进行训练,我们通过创建在常规GPU上实时运行的CNN来解决此类问题,也就是训练只需要一个常规GPU。
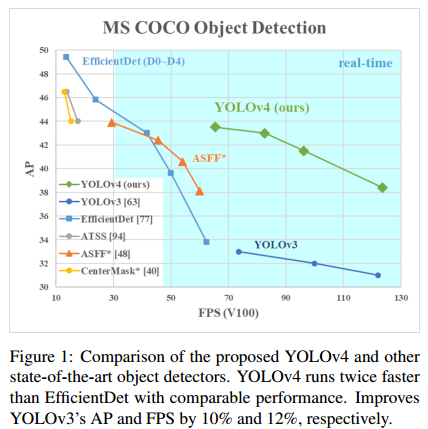
这项工作的主要目标是在生产系统中设计一个快速运行的目标探测器,并对并行计算进行优化,而不是设计一个低计算量的理论指示器(BFLOP)。我们希望设计的检测器可以很容易地训练和使用。例如,任何使用传统GPU进行训练和测试的人都可以获得实时、高质量、令人信服的对象检测结果,如图1所示的YOLOv4结果。
我们的主要贡献如下:
- 我们开发了一个高效、强大的目标检测模型。它使每个人都可以使用1080 Ti或2080 Ti GPU来训练一个超级快速和准确的目标探测器。
- 我们验证了在检测器训练的过程中最先进的 Bag-of Freebies 和Bag-of-Specials methods of object detection的影响。
- 我们修改了最先进的方法使得它们在单个GPU上训练更有效和适合,例如CBN、PAN、SAM等等。
2.相关工作:
2.1 目标检测模型
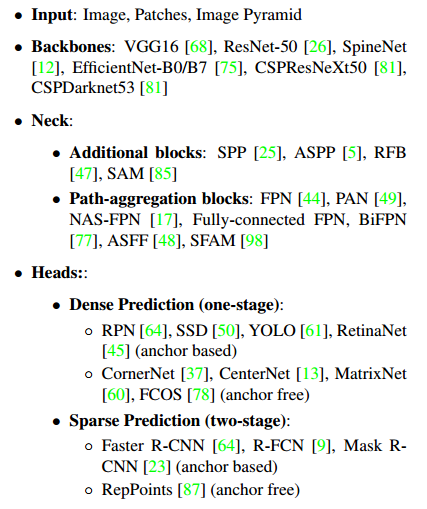
现代检测器通常由两个部分组成,一个是在ImageNet上预训练的主干,另一个是用来预测物体的类别和边界框的头部。对于那些运行在GPU平台上的检测器,它们的主干可以是VGG[68]、ResNet[26]、ResNeXt[86]或DenseNet[30]。对于那些运行在CPU平台上的检测器,它们的主干可以是SqueezeNet[31]、MobileNet[28,66,27,74]或ShuffleNet[97,53]。至于头部,通常分为两类:、一阶段目标检测器和二阶段目标检测器。最具代表性的二阶段目标探测器是R-CNN[19]系列,包括fast R-CNN [18], faster R-CNN [64], R-FCN [9], Libra R-CNN[58]。也可以使两级对象检测器成为anchor-free对象检测器,如RepPoints[87]。一阶段目标探测器最具代表性的模型有YOLO[61, 62, 63]、SSD[50]、RetinaNet[45]。近年来,anchor-free一阶段目标探测器得到了广泛的应用。这类探测器有CenterNet[13]、CornerNet[37,38]、FCOS[78]等。近年来发展起来的目标探测器常常在主干和头部之间插入一些层,这些层通常用来收集不同阶段的特征图。我们可以称它为物体探测器的颈部。通常,一个颈部是由几个自底向上的路径和几个自顶向下的路径组成。具有该机制的网络包括特征金字塔网络(Feature Pyramid Network, FPN)[44]、路径汇聚网络(Path Aggregation Network, PAN)[49]、BiFPN[77]和NAS-FPN[17]。除了上述模型外,一些研究者还着重于直接构建一个新的主干(DetNet [43], DetNAS[7])或一个新的整体模型(SpineNet [12], HitDetector[20])用于对象检测。
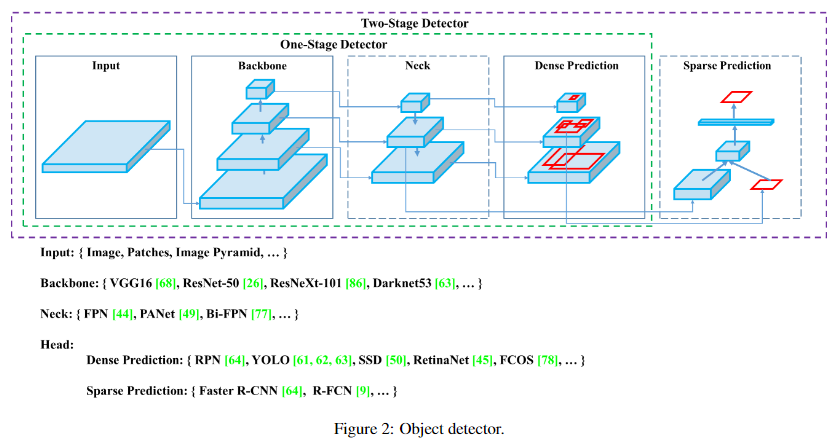
综上所述,一个普通的物体探测器是由几个部分组成的:
2.2 Bag of freebies
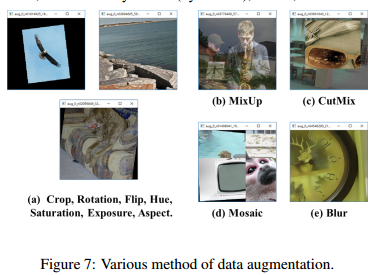
通常,传统的目标探测器是离线训练的。因此,研究人员总是希望利用这一优势,开发出更好的训练方法,使目标探测器在不增加推理成本的情况下获得更好的精度。我们称这些方法为只改变训练策略或只增加训练成本的免费赠品。对象检测方法中经常采用的、符合赠品包定义的是数据扩充。数据扩充的目的是增加输入图像的可变性,使所设计的目标检测模型对不同环境下获得的图像具有更高的鲁棒性。例如,光度畸变和几何畸变是两种常用的数据增强方法,它们对目标检测任务有明显的好处。在处理光度失真时,我们调整图像的亮度、对比度、色调、饱和度和噪声。对于几何畸变,我们添加了随机缩放、剪切、翻转和旋转。
上述数据增强方法均为像素级调整,调整区域内的所有原始像素信息均保留。此外,一些从事数据扩充的研究人员把重点放在模拟物体遮挡问题上。在图像分类和目标检测方面取得了良好的效果。例如,random wipe[100]和CutOut[11]可以随机选择图像中的矩形区域,并填充一个随机的或互补的0值。对于hide-and-seek[69]和grid mask[6],它们随机或均匀地选择图像中的多个矩形区域,并将其全部替换为零。如果将类似的概念应用于feature map,则有DropOut[71]、DropConnect[80]和DropBlock[16]方法。此外,一些研究者提出了将多幅图像结合在一起进行数据扩充的方法。例如,MixUp[92]使用两幅图像以不同的系数比率进行相乘和叠加,然后利用这些叠加比率调整标签。CutMix[91]是将裁剪后的图像覆盖到其他图像的矩形区域,并根据混合区域的大小调整标签。除了上述方法外,style transfer GAN[15]也被用于数据扩充,这样的使用可以有效的减少CNN学习到的纹理偏差。
与上述各种方法不同,其他一些免费赠品方法致力于解决数据集中的语义分布可能存在偏差的问题。在处理语义分布偏差问题时,一个非常重要的问题是存在着不同类之间的数据不平衡问题,这一问题通常通过两阶段对象检测器中的hard example mining[72]或online hard example mining[67]来解决。但the example mining不适用于单级目标探测器,因为这种探测器属于稠密预测结构。因此,Lin等人提出了focal loss来处理各类之间存在的数据不平衡问题。另一个非常重要的问题是,很难用一个one-hot hard representation来表达不同类别之间关联程度的关系。这种表示法常用于执行标记。文献[73]提出的label smoothing是将硬标签转换为软标签进行训练,使模型更加稳健。为了获得更好的软标签,Islam等人在[33]中引入了knowledge distillation的概念来设计标签细化网络。
最后一袋免费赠品是Bounding Box Regression的目标函数。传统的目标检测器通常使用均方误差(Mean Square Error, MSE)直接对BBox的中心点坐标和高度、宽度进行回归,即, {xcenter, ycenter, w, h},或左上点和右下点,即, {xtop lef t, ytop lef t, xbottom right, ybottom right}。对于基于anchor的方法,是对相应的偏移量进行估计,{xcenter offset, ycenter offset, woffset, hoffset} and {xtop left offset, ytop left offset, xbottom right offset, ybottom right offset}。但是,直接估计BBox中每个点的坐标值,就是把这些点当作自变量,而实际上并不考虑对象本身的完整性。为了更好地处理这个问题,一些研究者最近提出了IoU损失[90],将预测的BBox区域的覆盖范围和ground truth BBox区域考虑在内。IoU的损失计算过程通过执行带有ground truth的IoU,触发BBox的四个坐标点的计算,然后将生成的结果连接成一个完整的代码。由于IoU是尺度不变的表示,它可以解决传统方法在计算{x, y, w, h}的l1或l2损耗时,损耗会随着尺度的增大而增大的问题。最近,一些研究人员继续改善IoU损失。例如GIoU loss[65],除了覆盖区域外,还包括了物体的形状和方向。他们提出寻找能够同时覆盖预测的BBox和ground truth BBox的最小面积BBox,用这个BBox作为分母来代替IoU损失中原来使用的分母。对于DIoU loss[99],它额外考虑了物体中心的距离,而CIoU loss[99],同时考虑了重叠区域、中心点之间的距离和长宽比。在BBox回归问题上,CIoU具有较好的收敛速度和精度。
2.3 Bag of specials
对于那些仅增加少量推理成本,却能显著提高目标检测精度的插件模块和后处理方法,我们称之为特价包。这些插件模块一般用于增强模型中的某些属性,如扩大接受域、引入注意机制、增强特征集成能力等,后处理是筛选模型预测结果的一种方法。
可以用来增强感受野的常用模块有SPP[25]、ASPP[5]和RFB[47]。SPP模块起源于空间金字塔匹配(SPM) [39], SPMs原始方法是将feature map分割成几个相等的d×d块,其中d可以是{1,2,3,…,}从而形成空间金字塔,然后提取bag-of-word特征。SPP将SPM集成到CNN中,使用max-pooling操作,而不是bag-of-word操作。由于He等人提出的SPP模块会输出一维特征向量,因此在全卷积网络(FCN)中应用是不可行的。因此,在YOLOv3[63]的设计中,Redmon和Farhadi将SPP模块改进为最大池化输出与核大小k×k级联,其中k = {1,5,9,13}, stride = 1。在本设计中,较大的k×k的max pooling有效地增加了骨干特征的接受域。在添加SPP模块的改进版本后,YOLOv3-608在MS COCO对象检测任务上在AP50提升了了2.7%,增加了0.5%的额外计算量。ASPP[5]模块与改进后的SPP模块在运算上的区别主要体现在原始的k×k核大小,stride为1的最大池化大小到几个3×3核大小,扩展比为k,扩展卷积运算的stride为1。RFB模块是利用k×k kernel的几个展开卷积,展开比等于k, stride等于1,得到比ASPP更全面的空间覆盖。RFB[47]只需额外花费7%的推理时间,就可以将MS COCO上SSD的AP50增加5.7%。(这里ASPP和SPP翻译不太好,需要了解的看论文原文)。
在目标检测中经常使用的注意模块主要分为两种:通道式注意和点态注意,这两种注意模型的代表分别是挤压-激励(squeeze -and-激励,SE)[29]和空间注意模块(Spatial attention module, SAM)[85]。尽管SE模块可以改善ResNet50 ImageNet图像分类任务中1%精度,代价只会增加2%的计算工作。但是在GPU通常会增加推理时间约10%,所以它更适合用于移动设备。但是对于SAM,它只需要额外支付0.1%的计算量,它可以提高ResNet50-SE在ImageNet图像分类任务上的0.5% top-1准确率。最重要的是,它完全不影响GPU上的推理速度。
在特征集成方面,早期的实践是使用跳跃连接[51]或hyper-column[22]将低级物理特征集成到高级语义特征。随着FPN等多尺度预测方法的流行,人们提出了许多融合不同特征金字塔的轻量级模型。这类模块包括SFAM[98]、ASFF[48]和BiFPN[77]。SFAM的主要思想是利用SE模块对多尺度的拼接特征图进行信道级配重权。对于ASFF,它使用softmax作为点向水平重加权,然后添加不同尺度的特征映射。在BiFPN中,提出了多输入加权剩余连接来执行按比例加权的水平重加权,然后加入不同比例的特征映射。
在深度学习的研究中,一些人把重点放在寻找良好的激活功能上。一个好的激活函数可以使梯度更有效地传播,同时也不会造成过多的计算开销。2010年,Nair和Hinton[56]提出ReLU,从本质上解决了传统tanh和sigmoid激活函数中经常遇到的梯度消失问题。随后,LReLU[54]、PReLU[24]、ReLU6[28]、标度指数线性单元(SELU)[35]、Swish[59]、hard-Swish[27]、Mish[55]等也被用于解决梯度消失问题。LReLU和PReLU的主要目的是解决输出小于0时ReLU的梯度为零的问题。对于ReLU6和hard-Swish,它们是专门为量化网络设计的。为了实现神经网络的自归一化,提出了SELU激活函数。需要注意的一点是,Swish和Mish都是连续可微的激活函数。
基于深度挖掘的对象检测中常用的后处理方法是NMS,它可以过滤那些对同一对象预测较差的bbox,只保留响应较高的候选bbox。NMS试图改进的方法与优化目标函数的方法是一致的。NMS提出的原始方法没有考虑上下文信息,所以Girshick等人[19]在R-CNN中加入了分类置信度评分作为参考,按照置信度评分的顺序,从高到低依次进行贪婪NMS。对于soft NMS[1],考虑了在IoU评分的贪心NMS中,对象的遮挡可能会导致信心评分下降的问题。DIoU NMS[99]开发人员的思路是在软NMS的基础上,将中心点距离信息添加到BBox筛选过程中。值得一提的是,由于以上的后处理方法都不直接引用捕获的图像特征,因此在后续的无锚方法开发中不再需要后处理。
3、方法论
其基本目标是在生产系统中提高神经网络的运行速度和并行计算的优化速度,而不是低计算量理论指标(BFLOP)。我们提出了实时神经网络的两种选择:
- 对于GPU,我们在卷积层中使用少量的组(1 - 8):CSPResNeXt50 / CSPDarknet53
- 对于VPU,我们使用grouped-convolution,但是我们不使用(SE)块,具体来说,这包括以下模型:EfficientNet-lite / MixNet [76] / GhostNet [21] / MobileNetV3
3.1 选择的技术
我们的目标是在输入网络分辨率、卷积层数、参数数(filter size2 * filters * channel / groups)和层输出数(filter)之间找到最优的平衡。例如,我们的大量研究表明,在ILSVRC2012 (ImageNet)数据集[10]上的对象分类方面,CSPResNext50要比CSPDarknet53好得多。然而,相反地,CSPDarknet53在检测MS COCO数据集[46]上的对象方面优于CSPResNext50。
下一个目标是选择另外的模块来增加感受野,并从不同主干级别中为检测器级别,例如FPN、PAN、ASFF、BiFPN等选择参数聚合的最佳方法。
对分类最优的参考模型不一定对检测器最优。与分类不同,检测器需要以下特性:
- 更大的网络输入,用于检测小目标
- 更多的层-以获得更大的感受野来覆盖增大的输入图像
- 更多的参数-为了增强从单张图像中检测出不同大小的多个对象的能力
假设我们可以选择一个接受域较大的模型(包含较多的3×3 convolutional layers)和较多的parameter作为主干。表1显示了CSPResNeXt50、CSPDarknet53和Effi- cientNet B3的信息。CSPResNext50只包含16个3×3卷积层,一个425 ×425的接受域和20.6 M的参数,而CSPDarknet53包含29个3×3卷积层,一个725×725的接受域和27.6 M的参数。这一理论证明,以及我们的大量实验,表明CSPDarknet53神经网络在两者中是作为探测器主干的最佳模型。
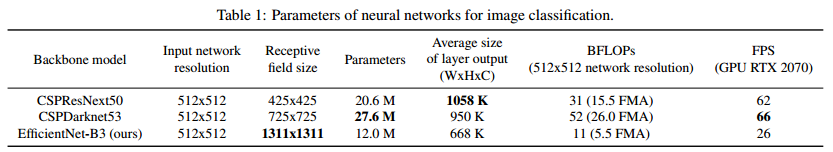
不同大小的感受野对检测效果的影响如下所示:
- 达到对象的大小 -允许看到整个对象
- 达到网络的大小-允许观测到对象的上下文信息
- 超越网络大小-增加图像点和最终激活之间的连接数量
我们在CSPDarknet53上添加了SPP块,因为它显著地增加了接受域,分离出最重要的上下文特征,并且几乎不会导致网络运行速度的降低。我们使用PANet作为从不同的骨组织水平对不同的检测器水平进行参数聚合的方法,而不是YOLOv3中使用的fpn。
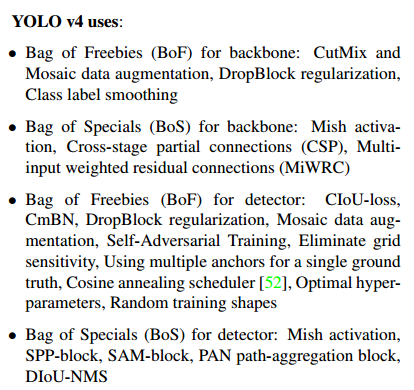
最后,我们选择CSPDarknet53主干、SPP添加模块、PANet路径聚集颈和YOLOv3(基于锚的)头作为YOLOv4的架构。
在未来,我们计划大幅扩展探测器的免费赠品包(BoF)的内容,理论上可以解决一些问题,提高探测精度,并以实验的方式依次检查每种特性的影响。
我们不使用跨gpu批处理标准化(CGBNor SyncBN)或昂贵的专用设备。这使得任何人都可以在传统的图形处理器(如GTX 1080Ti或RTX2080Ti)上重现我们的最新成果。
总结:3.1节的核心
- 选择CSPDarknet53主干
- 使用SPP模块来增大感受野
- 使用PANet中的路径聚合模块
- 使用YOLOV3中的头部
3.2 选择BoF和BoS
卷积神经网络可使用的技术:
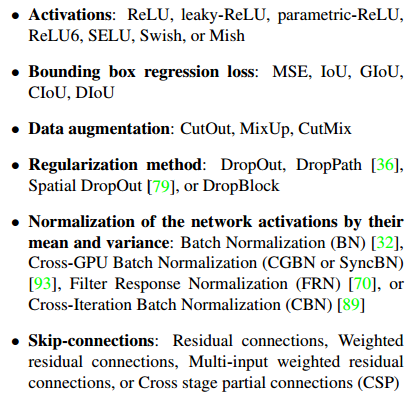
对于训练激活函数,由于PReLU和SELU更难训练,而ReLU6是专门为量化网络设计的,因此我们将上述激活函数从候选列表中删除。在reqularization方法上,发表DropBlock的人详细的将他们的方法与其他方法进行了比较,他们的regularization方法取得了很大的成果。因此,我们毫不犹豫的选择了DropBlock作为我们的regularization方法。在归一化方法的选择上,由于我们关注的是只使用一个GPU的训练策略,所以没有考虑syncBN。
总结:3.2节核心
- 不考虑PReLU、SELU、RELU6激活函数
- 使用DropBlock正则化方法
- 不适用syncBN
3.3 另外的改善
为了让设计的检测器更适合在单个GPU上进行训练,进行了如下改善:
- 提出了新的数据增强方法:Mosaic, and Self-Adversarial Training (SAT)
- 使用遗传算法来选择超参数
- 修改了一些现有的方法,使我们的设计适合于有效的训练和检测-修改的SAM,修改的PAN,和交叉小批量标准化(CmBN)
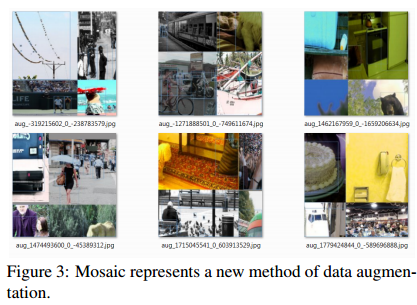
Mosaic:混合四张训练图像,所以四个不同的上下文信息被混合,而CutMix只混合了2种。这允许检测正常上下文之外的对象。此外,BN在每一层从4个不同的图像计算激活统计量。这大大减少了对large mini-batch-size需求。
自对抗训练(SAT)也代表了一种新的数据扩充技术,它分前后两个阶段进行操作。在第一阶段,神经网络改变原始图像而不是网络权值。通过这种方式,神经网络对自己执行一种对抗性攻击,改变原始图像,制造图像上没有期望对象的假象。第二阶段训练神经网络对修改后的图像进行正常的目标检测。
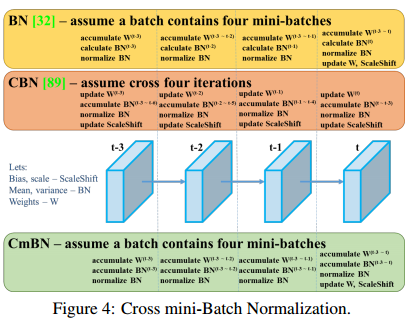
CmBN表示CBN的修改版本,如图4所示,定义为跨微批量标准化(CmBN)。这仅收集单个批中的小批之间的统计信息。
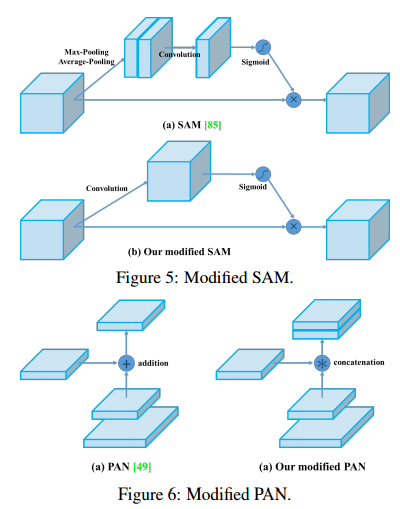
我们将SAM从空间上的注意修改为点注意,并将PAN的快捷连接改为拼接,分别如图5和图6所示。
3.4 YO;LOV4
直接直接放英文好理解:

4. 实验
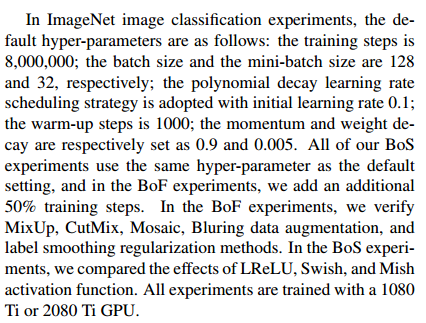
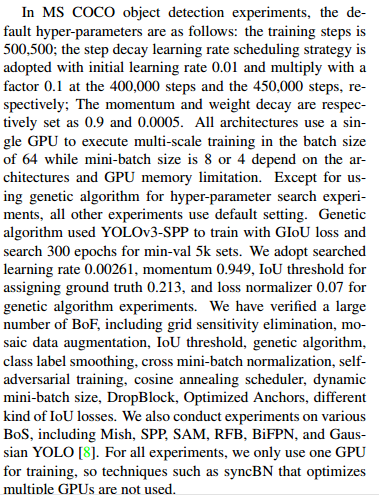
我们在ImageNet (ILSVRC 2012 val)数据集上测试了不同的训练改进技术对分类器精度的影响,然后在MS COCO (test-dev 2017)数据集上测试了检测器的精度。
4.1 实验设置
还是英文比较方便:
4.1 不同特征对分类器训练的影响
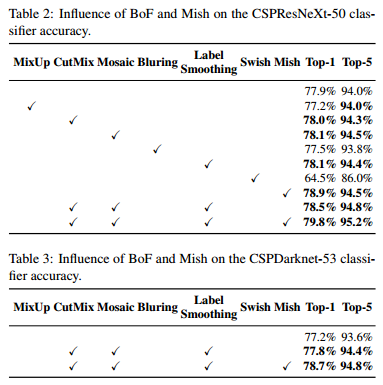
使用CutMix+Mosaic+Label Smoothing+Mish的效果最好。
4.3 不同特征对检测器训练的影响
首先是表格中的缩写的含义:
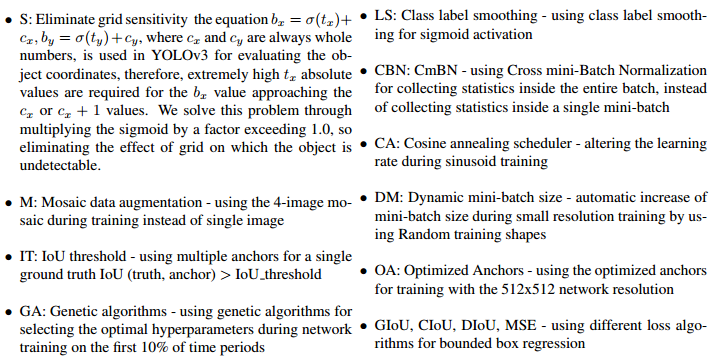
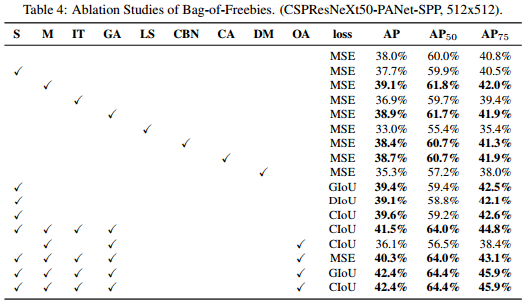
使用S+M+IT+GA+OA+GIOU效果最好。
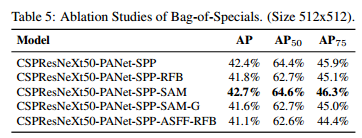
使用CSPResNeXt50-PANet-SPP-SAM效果最好。
4.4 不同主干和预训练权重对检测器训练的影响
在分类上表现好的模型在检测上表现不总是最好的。
首先,虽然不同特征训练的CSPResNeXt- 50模型的分类精度要高于CSPDarknet53模型,但CSPDarknet53模型在目标检测方面具有更高的精度。
其次,在CSPResNeXt50分类器训练中使用BoF和Mish可以提高分类精度,但是在检测器训练中进一步使用这些预训练权重会降低检测器的精度。然而,在CSPDarknet53分类器训练中使用BoF和Mish可以提高分类器和使用该分类器预训练权重的检测器的准确性。最终的结果是CSPDarknet53基干比CSPResNeXt50更适合于探测器。我们观察到,由于各种改进,CSPDarknet53模型显示出了更大的提高探测器精度的能力。

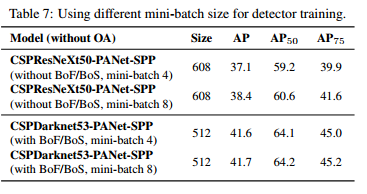
4.5 不同Mini-batch size对检测器训练的影响
最后,我们对不同小批量模型训练得到的结果进行了分析,结果如表7所示。从表7的结果可以看出,加入BoF和BoS训练策略后,小批量的尺寸对检测器的性能几乎没有影响。这一结果表明,在引入BoF和BoS之后,不再需要使用昂贵的gpu进行培训。换句话说,任何人都只能使用传统的GPU来训练一个优秀的检测器。
最后是与最先进的检测器进行对比:
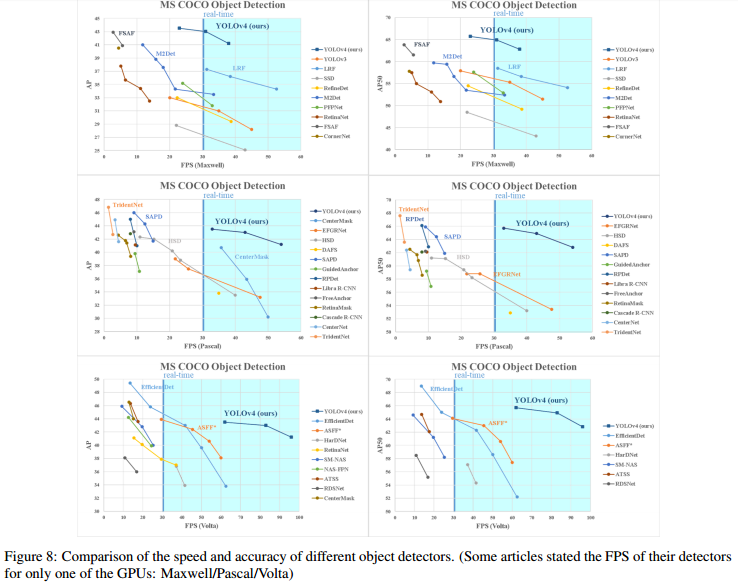
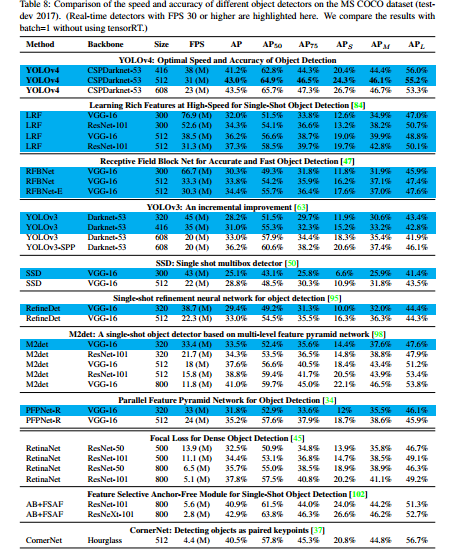

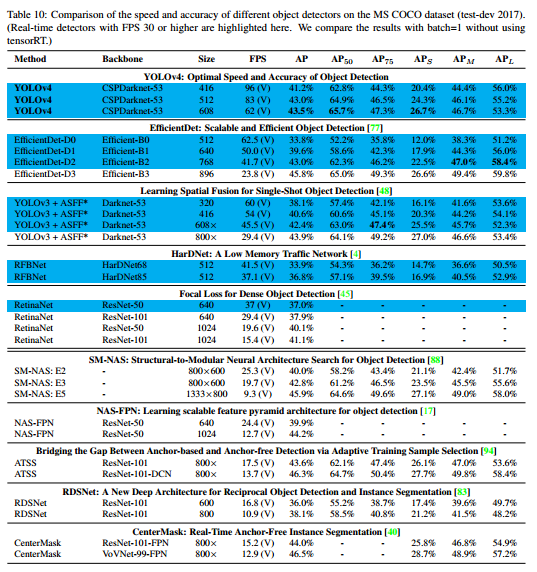
简单的翻译了下,很多内容也不是很理解,如有错误,欢迎指出。
【论文笔记】YOLOv4: Optimal Speed and Accuracy of Object Detection的更多相关文章
- 论文笔记:Rich feature hierarchies for accurate object detection and semantic segmentation
在上计算机视觉这门课的时候,老师曾经留过一个作业:识别一张 A4 纸上的手写数字.按照传统的做法,这种手写体或者验证码识别的项目,都是按照定位+分割+识别的套路.但凡上网搜一下,就能找到一堆识别的教程 ...
- 论文阅读笔记六十三:DeNet: Scalable Real-time Object Detection with Directed Sparse Sampling(CVPR2017)
论文原址:https://arxiv.org/abs/1703.10295 github:https://github.com/lachlants/denet 摘要 本文重新定义了目标检测,将其定义为 ...
- 深度学习笔记(十)Augmentation for small object detection(翻译)
一. abstract 这些年来,目标检测取得了令人瞩目的成就.尽管改进很大,但对于小目标和大目标的检测性能差异还是蛮大的.我们在 MS COCO 数据集上分析了如今一个比较先进的算法,Mask-RC ...
- [论文理解] Acquisition of Localization Confidence for Accurate Object Detection
Acquisition of Localization Confidence for Accurate Object Detection Intro 目标检测领域的问题有很多,本文的作者捕捉到了这样一 ...
- 论文笔记之:Speed Up Tracking by Ignoring Features
Speed Up Tracking by Ignoring Features CVPR 2014 Abstract:本文提出一种特征选择的算法,来实现用最"精简"的特征以进行目标跟 ...
- 【CV论文阅读】+【搬运工】LocNet: Improving Localization Accuracy for Object Detection + A Theoretical analysis of feature pooling in Visual Recognition
论文的关注点在于如何提高bounding box的定位,使用的是概率的预测形式,模型的基础是region proposal.论文提出一个locNet的深度网络,不在依赖于回归方程.论文中提到locne ...
- 论文笔记:《OverFeat: Integrated Recognition, Localization and Detection using Convolutional Networks DeepLearning 》
一.Abstract综述 训练出一个CNN可以同时实现分类,定位和检测..,三个任务共用同一个CNN网络,只是在pool5之后有所不同 二.分类 这里CNN的结构是对ALEXNET做了一些改进,具体的 ...
- 论文阅读笔记五十七:FCOS: Fully Convolutional One-Stage Object Detection(CVPR2019)
论文原址:https://arxiv.org/abs/1904.01355 github: tinyurl.com/FCOSv1 摘要 本文提出了一个基于全卷积的单阶段检测网络,类似于语义分割,针对每 ...
- 论文笔记之:Fully-Convolutional Siamese Networks for Object Tracking
gansh Fully-Convolutional Siamese Network for Object Tracking 摘要:任意目标的跟踪问题通常是根据一个物体的外观来构建表观模型.虽然也取得了 ...
随机推荐
- effective-java学习笔记---注解优于命名模式39
命名模式的缺点有以下三点:(在第 4 版之前,JUnit 测试框架要求其用户通过以 test[Beck04] 开始名称来指定测试方法) 1.拼写错误导致失败,但不会提示. 2.无法确保它们仅用于适当的 ...
- Go解算法07整数反转
描述 给出一个 32 位的有符号整数,你需要将这个整数中每位上的数字进行反转. 示例 1: 输入: 123 输出: 321 示例 2: 输入: -123 输出: -321 示例 3: 输入: 120 ...
- 从本地方法栈看到jni调用
我们都知道java虚拟机所管理的内存区域包括方法区,堆,虚拟机栈,本地方法栈,程序计数器. 在<深入理解java虚拟机>中,周志明老师对虚拟机栈进行了讲解,但是对本地方法栈却一笔带过.今天 ...
- 30款Django 常用的软件包
30款Django 常用的软件包 Django是一款高级的Python Web框架,可以帮助开发者快速创建web应用.我们这里整理了30款Django开发中常用的软件包,学会使用它们可以节省大量开发时 ...
- 基于.NetCore3.1搭建项目系列 —— 使用Swagger导出文档 (番外篇)
前言 回顾之前的两篇Swagger做Api接口文档,我们大体上学会了如何在net core3.1的项目基础上,搭建一套自动生产API接口说明文档的框架. 本来在Swagger的基础上,前后端开发人员在 ...
- Vue 【前端面试题】
前言 看看面试题,只是为了查漏补缺,看看自己那些方面还不懂.切记不要以为背了面试题,就万事大吉了,最好是理解背后的原理,这样面试的时候才能侃侃而谈.不然,稍微有水平的面试官一看就能看出,是否有真才实学 ...
- Java 运行时数据区
写在前面 本文描述的有关于 JVM 的运行时数据区是基于 HotSpot 虚拟机. 概述 JVM 在执行 Java 程序的过程中会把它所管理的内存划分为若干个不同的数据区域.这些区域都有各自的用途,以 ...
- 1013 Battle Over Cities (25 分)
It is vitally important to have all the cities connected by highways in a war. If a city is occupied ...
- Spring(四):使用注解开发
本文是按照狂神说的教学视频学习的笔记,强力推荐,教学深入浅出一遍就懂!b站搜索狂神说或点击下面链接 https://space.bilibili.com/95256449?spm_id_from=33 ...
- Linux Shell编程,使用随机数
Shell有一个$RANDOM环境变量,读取它可以获得5位随机数 在/dev下,有两个字符设备/dev/random和/dev/urandom,可以产生二进制随机数 其中,urandom为非阻塞随机数 ...